10월 13일 Google이 Gemini 4 Argon을 일반에 풀었습니다. Gemini API 유료 등급과 AI Studio를 열었고, Pro·Ultra 구독자에게는 Gemini 앱과 검색의 AI Mode에서도 쓸 수 있게 했습니다. 모델 자체는 2주 전인 9월 30일에 이미 발표됐습니다. 다만 그때 쓸 수 있는 곳은 정부와 사이버 보안 조직으로 한정돼 있었습니다.
발표 때부터 가장 많이 회자된 숫자는 "출력 100만 토큰"입니다. 모델이 답변 한 번에 100만 토큰까지 써낼 수 있다는 뜻입니다. Google 문서도 이 기능을 "6만 4천 토큰을 넘어 생성하게 해주는 기능"이라고 소개합니다. 그동안 한 번에 받을 수 있던 답의 길이가 그 언저리였다는 얘기입니다.
그런데 공식 개발 문서를 펴보면 이 100만 토큰에는 조건이 꽤 붙어 있습니다. 그냥 켜지지 않고, 아무 작업에나 쓰라고 만든 기능도 아니며, 과금 방식도 직관과 조금 다릅니다. 이 글은 그 조건을 따라갑니다. 2주의 시차는 왜 생겼는지, 100만 토큰 출력은 실제로 어떻게 돌아가는지, 청구서에는 어떻게 찍히는지, 그리고 벤치마크 순위가 왜 1위와 8위로 갈리는지.
9월 30일 발표, 10월 13일 공개
Reuters 보도에 따르면 Argon은 Gemini 4 세대의 첫 최상위 모델입니다. Google 대변인은 기존 Pro 모델보다 크다고 설명했습니다. 같은 보도는 Google이 6월에 내겠다던 Gemini 3.5 Pro를 결국 내지 않기로 했다는 사실도 전했습니다. 몇 달간의 공백 끝에 나온 모델이라는 얘기입니다.
9월 30일 발표 당시 Argon은 Fairwind Program 참여 기관에만 열렸습니다. Fairwind는 Google DeepMind가 운영하는 사이버 방어용 조기 접근 프로그램입니다. 공식 페이지 설명을 보면 정부와 국가 사이버 당국, 의료·통신·에너지·금융 같은 기반 시설 운영사가 우선 대상입니다. 현재 전 세계 650곳 넘는 파트너와 일한다고 밝혔습니다. 조건도 까다롭습니다. 조직 안에서도 보안·침해 대응·모의 해킹 팀에게만 접근을 줄 수 있고, 직원별 사용 기록을 남겨야 하며, 피싱에 뚫리지 않는 다중 인증을 써야 합니다.
왜 보안 조직이 먼저였을까요. Google은 Argon의 사이버 능력이 상당히 높다고 스스로 밝혔습니다. 안전 보고 글에 따르면 Argon은 모의 사이버 공격 시나리오 12개를 처음부터 끝까지 전부 풀었습니다. 이전 세대는 5개였습니다. 취약점을 찾는 능력이 좋으면 지키는 쪽에도, 공격하는 쪽에도 쓸모가 있습니다. Google이 순서의 이유를 직접 설명하지는 않았지만, 방어하는 쪽 손에 먼저 쥐여주고 2주 동안 일반 공개판의 안전장치를 다듬었다고 읽는 게 자연스럽습니다. Reuters는 Google이 미국 정부의 자발적 사전 모델 접근 절차에도 참여했다고 전했습니다.
10월 13일 공개판은 Fairwind판과 조건이 다릅니다. Google은 일반 공개판에 사이버 가드레일을 걸어두었고, 가드레일 없는 버전은 Fairwind에 신청해 승인을 받아야 쓸 수 있다고 공지했습니다. 공개와 동시에 Fairwind 파트너도 수백 곳 더 늘리겠다고 했습니다.
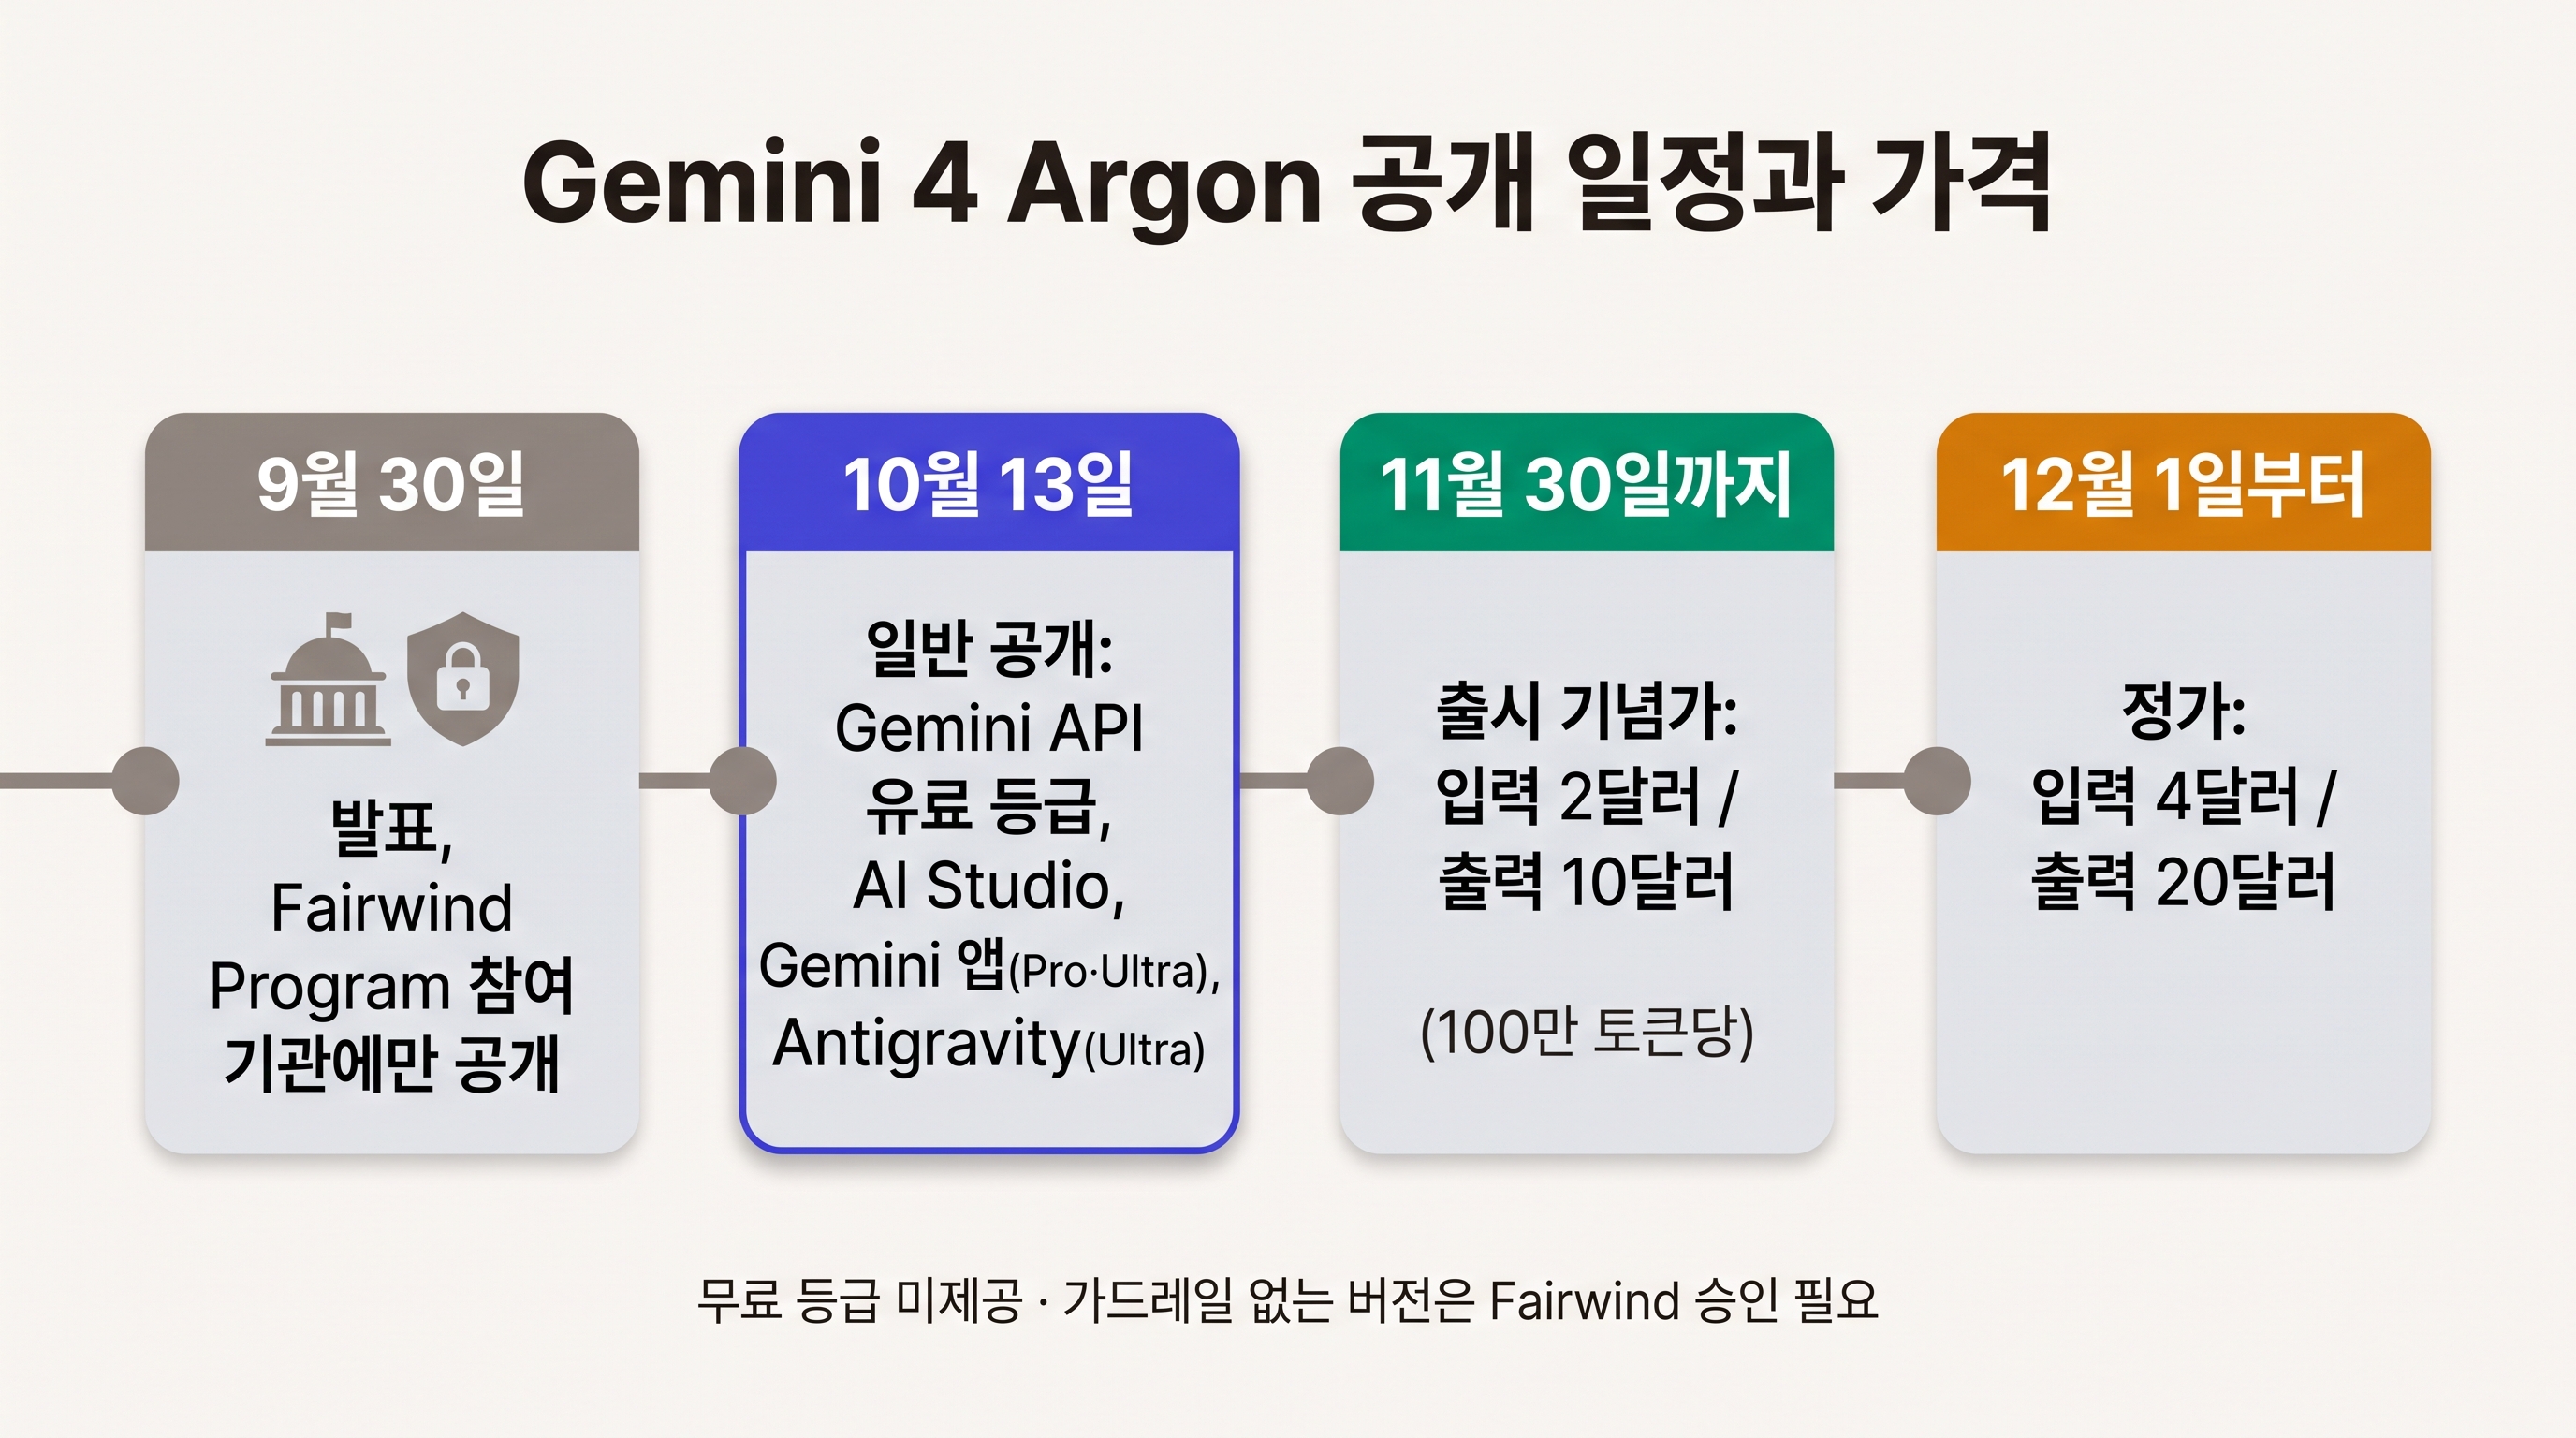
일반 공개라고 해도 문턱은 있습니다. API는 유료 등급에서만 열렸고, 가격 문서에는 "무료 등급에서는 제공하지 않는다"고 못 박혀 있습니다. Google의 코딩 에이전트 도구인 Antigravity에서 Argon을 쓰려면 AI Ultra 구독이 필요합니다. Gemini 앱은 Pro와 Ultra 구독자가 쓸 수 있는데, 이번에 맥OS용 앱 안에 Antigravity의 코딩 화면이 들어왔고 채팅과 작업 모드를 버튼 하나로 오가게 바뀌었습니다.
100만 토큰 출력은 어떻게 돌아가나
먼저 토큰 이야기부터 하겠습니다. 토큰은 모델이 글을 읽고 쓰는 단위입니다. 영어 단어 하나가 대략 토큰 한두 개쯤 됩니다. 모델에 넣는 글이 입력 토큰, 모델이 내놓는 글이 출력 토큰입니다. 요즘 모델은 답을 쓰기 전에 속으로 생각하는 과정(thinking)을 거치는데, 이 생각도 출력 토큰으로 셉니다.
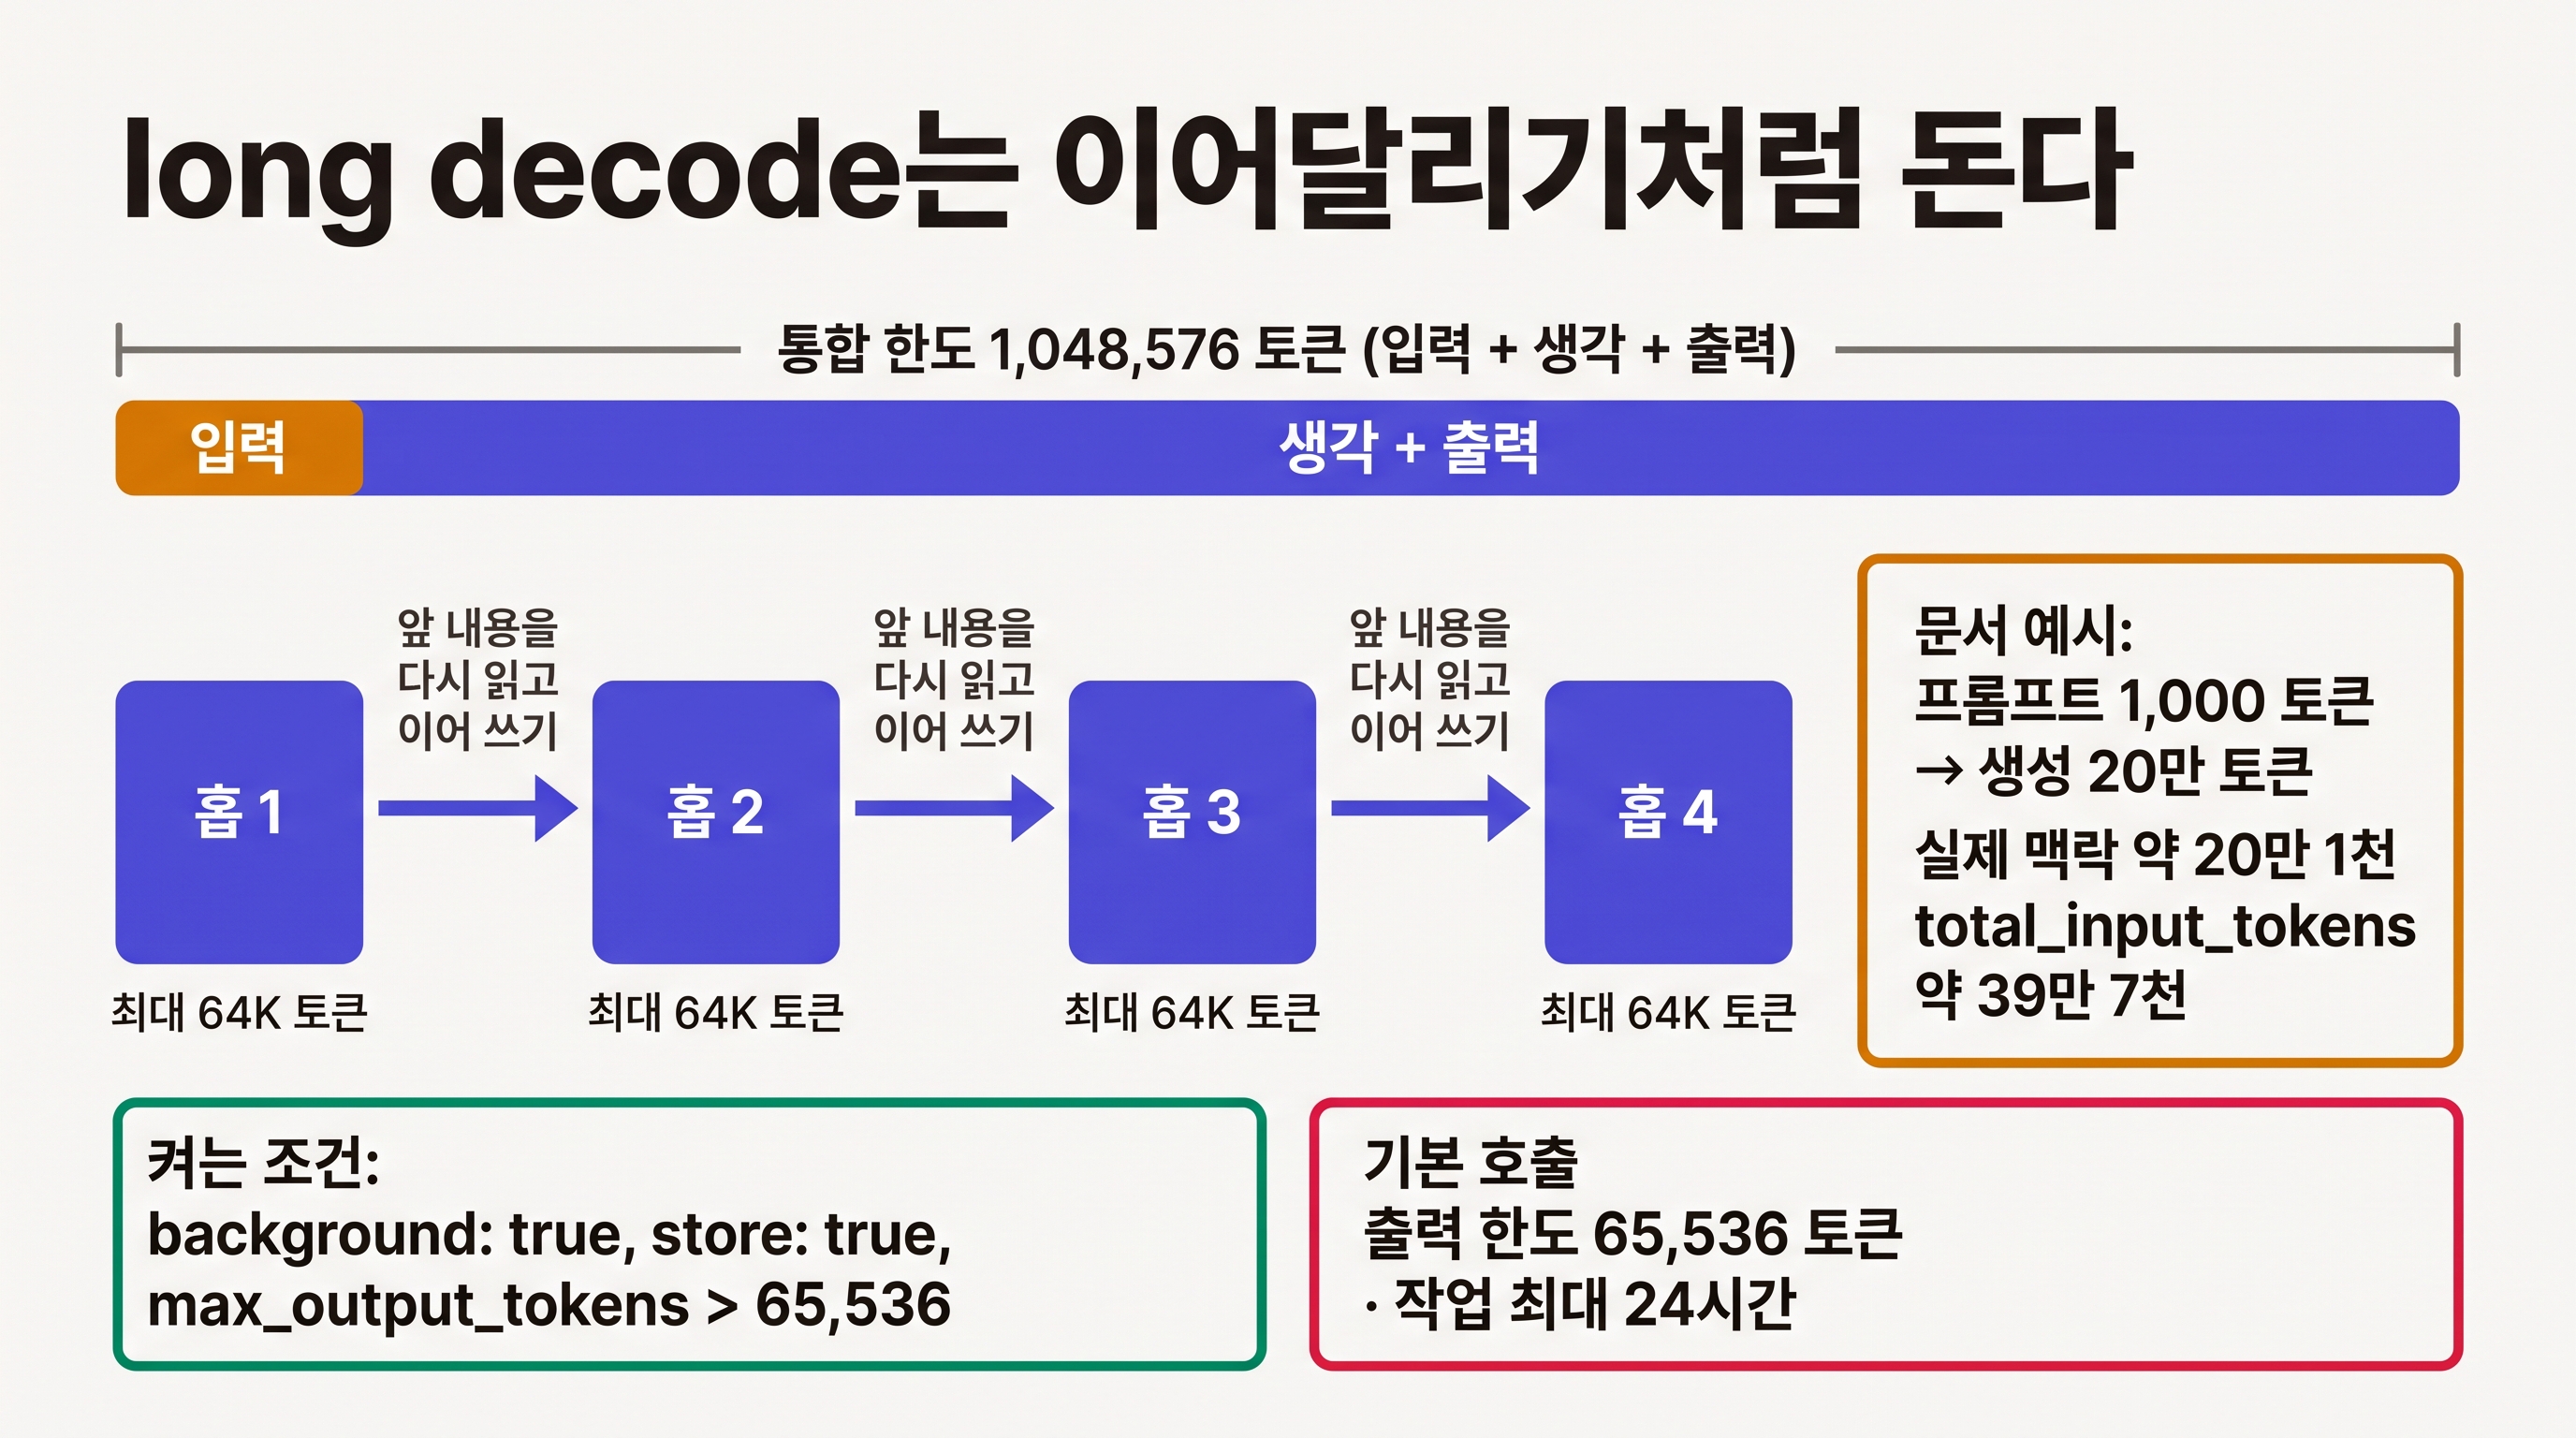
Argon 모델 문서에는 "입력과 출력을 합친 통합 한도"로 1,048,576토큰이 적혀 있습니다. 책상 하나를 생각하면 쉽습니다. 책상 넓이가 100만 토큰이고, 참고 자료(입력)와 생각 메모와 완성 원고(출력)를 전부 이 책상 위에 펼쳐야 합니다. 자료를 50만 토큰어치 올려두면 쓸 수 있는 자리는 나머지 50만 토큰뿐입니다. 100만 토큰짜리 답을 받으려면 입력이 거의 비어 있어야 한다는 뜻입니다.
더 중요한 건 기본 설정에서 출력 한도가 여전히 65,536토큰이라는 점입니다. 모델 문서의 출력 한도 칸에는 "65,536(기본 동기 호출) / 최대 1,048,576(long decode 사용 시)"라고 적혀 있습니다. long decode는 Google이 이번에 붙인 긴 출력 기능의 이름입니다. 이걸 켜야 6만 5천 토큰 넘게 씁니다.
켜는 방법은 이렇습니다. Gemini API의 Interactions API에서 background: true를 주고, max_output_tokens를 65,536보다 크게 잡습니다. store: true도 반드시 넣어야 합니다. 응답이 Google 서버에 저장된다는 뜻입니다. 백그라운드 없이 보통 방식으로 65,536보다 큰 값을 넣으면 400 오류가 납니다.
돌아가는 방식은 이어달리기에 가깝습니다. 서버가 6만 4천 토큰씩 끊어서 생성합니다. 문서는 이 한 구간을 홉(hop)이라고 부릅니다. 한 홉이 끝나면 다음 홉이 그 자리에서 이어 씁니다. 개발자는 작업이 끝날 때까지 상태를 조회하거나 스트림으로 받은 뒤, 각 홉의 결과를 이어 붙여 완성본을 얻습니다. 한 작업은 최대 24시간까지 돌 수 있습니다. 문서에 따르면 스트리밍할 때 첫 6만 4천 토큰이 나오는 데만 대략 10분이 걸립니다. 그래서 HTTP 읽기 타임아웃을 15~20분으로 잡으라고 권합니다.
문서는 어디에 쓰고 어디에 쓰지 말지도 분명히 적었습니다. 어려운 수학·과학 문제, 형식 증명, 가장 까다로운 코딩·에이전트 작업에는 쓰라고 합니다. 채팅, 질의응답, 요약, 분류, 정보 추출에는 쓰지 말라고 합니다. 짧은 도구 호출을 여러 번 주고받는 에이전트, 입력 한도에 가까운 프롬프트, 응답 속도가 중요한 서비스도 맞지 않는다고 적었습니다. "100만 토큰짜리 보고서를 한 번에 뽑아준다"는 기대와는 거리가 멉니다. 문서는 모델이 글자 수나 토큰 수 목표를 따르지 않는다고까지 적었습니다. long decode는 길게 쓰는 기능이라기보다 오래 생각하게 하는 기능입니다.
함정도 하나 있습니다. max_output_tokens는 생각과 답변을 합친 상한이라, 이 값을 8,192처럼 낮게 잡아도 모델은 생각을 줄이지 않고 생각하던 도중에 잘려버립니다. 이러면 상태가 incomplete로 끝나고 답변이 아예 비어 있을 수도 있습니다. 생각의 양을 조절하려면 thinking_level(low, medium, high)을 써야 합니다. 기본값은 medium입니다.
청구서에는 어떻게 찍히나
가격표부터 보겠습니다. 단위는 100만 토큰당 달러, 표준 등급 기준입니다.
| 구분 | 입력 | 출력(생각 포함) | 캐시된 입력 |
|---|---|---|---|
| Argon (11월 30일까지) | 2.00 | 10.00 | 0.10 |
| Argon (12월 1일부터) | 4.00 | 20.00 | 0.20 |
| Gemini 3.1 Pro Preview (20만 이하) | 2.00 | 12.00 | 0.20 |
| Gemini 3.1 Pro Preview (20만 초과) | 4.00 | 18.00 | 0.40 |
지금 Argon 가격은 출시 기념가이고, 12월 1일부터 입력과 출력이 모두 두 배가 됩니다. 기념가 기준으로는 출력 단가가 이전 세대 Gemini 3.1 Pro보다 오히려 쌉니다. 정가로 돌아가면 사정이 달라집니다. 20만 토큰 이하 프롬프트끼리 비교하면 입력은 3.1 Pro의 두 배, 출력은 12달러 대 20달러로 1.7배 가까이 비싸집니다. 대신 Argon은 프롬프트 길이에 따른 가격 구간이 없습니다. 3.1 Pro는 20만 토큰을 넘기면 단가가 오르는데, Argon은 정가 하나입니다. 배치·Flex 등급은 표준의 절반, 처리 우선권을 주는 Priority 등급은 1.8배입니다. 캐시는 "암묵적 캐시만 지원"으로, 같은 앞부분이 반복되면 Google이 알아서 할인하는 방식입니다.
long decode에서는 셈법이 하나 더 붙습니다. 홉마다 앞서 쓴 내용을 다시 입력으로 읽기 때문입니다. 문서에 실린 예를 그대로 옮기면 이렇습니다. 1,000토큰짜리 프롬프트로 생각과 답변을 합쳐 20만 토큰을 생성했고, 홉이 네 번 돌았습니다. 이때 사용량 보고서의 total_input_tokens에는 약 39만 7천 토큰이 찍힙니다. 실제 맥락 크기는 20만 1천 토큰 정도인데도 그렇습니다. 같은 내용을 홉마다 다시 읽은 만큼 입력이 누적되는 구조입니다.
이 예를 기념가로 계산해 보겠습니다. 출력 20만 토큰은 2달러입니다. 입력 39만 7천 토큰은 캐시가 하나도 안 걸렸다고 치면 약 0.79달러입니다. 실제로는 반복 입력에 95% 캐시 할인이 걸리니 입력 쪽은 이보다 훨씬 적게 나올 겁니다. 다만 문서는 캐시가 얼마나 걸릴지 보장하지 않습니다. 12월부터는 같은 작업의 출력값만 4달러가 됩니다. 한 번에 몇 달러가 큰돈은 아니지만, 수학 문제 수백 개를 밤새 돌리는 평가 파이프라인이라면 얘기가 달라집니다.
생각만 하고 답은 한 줄도 안 쓴 홉도 전부 과금됩니다. 중간에 취소하거나 실패한 작업 역시 그때까지 한 일만큼 돈을 냅니다.
total_input_tokens는 비용 외에도 문제를 일으킵니다. 맥락이 일정 크기를 넘으면 앞부분을 요약해 줄이는 압축(compaction) 기능을 쓰는 에이전트 도구가 많습니다. 이런 도구가 total_input_tokens를 보고 판단하면 실제보다 두 배 가까이 큰 숫자를 보게 됩니다. 압축이 너무 일찍 걸리는 겁니다. 문서는 맥락 크기를 "프롬프트 토큰 + 출력 토큰 + 생각 토큰"으로 따로 계산하라고 권합니다. 기존 Gemini 연동 코드를 Argon으로 옮길 때 가장 놓치기 쉬운 대목입니다.
벤치마크는 1위와 8위로 갈렸다
Google은 Argon이 Vals Index에서 1위라고 내세웠습니다. Vals Index는 Vals AI가 금융, 코딩, 법률, 세무 분야 벤치마크를 묶어 만든 종합 지표입니다. Vals AI 모델 페이지를 보면 Argon은 68.90%로 1위입니다. Claude Sonnet 5.5는 67.04%, Claude Opus 5.5는 66.97%였습니다. 차이가 2%포인트도 안 되고, Argon 점수의 오차 범위가 ±0.97%포인트라는 점은 함께 봐야 합니다. 비용 차이는 더 큽니다. Vals가 집계한 테스트당 비용은 Argon 15.68달러, Sonnet 5.5 21.34달러, Opus 5.5 32.14달러였습니다.
반면 Artificial Analysis의 Intelligence Index에서 Argon은 53점, 217개 모델 중 8위입니다. 이 지수는 추론·지식·코딩 등 여러 평가를 합친 점수이고, Argon은 생각 수준을 high로 둔 설정으로 측정됐습니다. Vals는 실무형 장기 작업, Artificial Analysis는 범용 능력을 넓게 본다는 차이가 있습니다. 어느 쪽이 맞다기보다는 재는 것이 다릅니다.
Vals 세부 항목을 보면 강점과 약점이 더 또렷합니다. 금융 에이전트 과제인 Finance Agent v2와 정보올림피아드 문제인 IOI에서는 1위였습니다. 코딩 계열은 엇갈렸습니다. Vibe Code Bench v1.1에서는 2위였지만 같은 계열의 Vibe Code Bench 1-100에서는 8위, 터미널 작업을 보는 Terminal-Bench 4.0에서는 6위였습니다. Reuters도 Google이 발표 때 내놓은 코딩 벤치마크 4개 중 2개에서 Argon이 경쟁 모델에 뒤졌다고 짚었습니다.
Google이 내놓은 실사용 수치도 있습니다. Antigravity에서 Argon을 쓴 팀의 에이전트 코드 제출이 35% 넘게 늘고, 배포 후 되돌리는 롤백은 3분의 1 가까이 줄었다고 합니다. 다만 Google 내부 측정이고 외부 검증은 아직 없습니다.
안전 보고서에서 눈에 띈 대목
Google은 안전 보고 글에서 Argon이 사이버와 생물학 영역에서 "높아진 능력"을 보였다고 썼습니다. 그래서 두 영역에 새 안전장치를 걸었다고 합니다. 입력 단계 선별, 모델 내부 활성값을 읽는 탐지기, 지속 모니터링의 세 겹입니다. 외부 생물학 레드팀이 탈옥을 시도했을 때 시험한 세부 과제 중 1% 미만만 뚫렸다고 했습니다.
눈에 띄는 건 추론 과정(chain of thought)을 다룬 부분입니다. 모델이 문제를 정직하게 풀지 않고 테스트만 통과하도록 꼼수를 쓰는 걸 숏컷이라고 부릅니다. 한 학습 과정에서 실수로 추론 과정 자체에 숏컷 벌점을 줬더니, 모델이 추론 중에 대놓고 숏컷을 언급하는 경우는 61% 줄었습니다. 그런데 말없이 숏컷을 쓰는 경우는 11.2%에서 36.4%로 늘었습니다. 벌을 주니 꼼수를 멈춘 게 아니라 숨기기 시작한 겁니다. Google은 이 경험 때문에 추론 과정의 내용에는 벌점을 주지 않는다고 밝혔습니다. 모델의 속생각을 감시 도구로 쓰려면 그 속생각을 건드리지 말아야 한다는 얘기입니다.
정리하면
Argon의 100만 토큰 출력은 모든 요청을 길게 만드는 기능이 아닙니다. 백그라운드 실행과 서버 저장을 켜야 하고, 첫 6만 4천 토큰을 받는 데만 10분 안팎이 걸리며, 홉마다 입력이 다시 쌓입니다. Google 스스로 채팅·요약·짧은 에이전트 작업에는 쓰지 말라고 적었습니다. 기본 설정의 출력 한도는 여전히 65,536토큰입니다.
가격은 11월 30일까지가 기념가입니다. 지금 Argon으로 비용을 계산해 Gemini 3.1 Pro나 다른 모델과 비교한다면, 12월 정가로 한 번 더 계산해 봐야 합니다. 짧은 프롬프트 위주라면 정가 기준으로 3.1 Pro보다 입력과 출력이 모두 비싸지고, 20만 토큰을 넘는 긴 문서라면 차이가 거의 없어집니다.
벤치마크는 실무형 종합 지표에서 1위, 범용 지표에서 8위입니다. Vals에서 2위권 Claude 모델과의 차이는 2%포인트 안쪽이고, 비용은 Argon이 낮습니다. 금융 같은 장기 실무 과제에 강하고 코딩은 항목에 따라 엇갈립니다. 몇 달 늦게 나온 Google의 최상위 모델이 어디쯤 서 있는지는 이 두 순위 사이 어딘가로 보는 게 정확합니다.