10월 8일 The Lancet에 구글의 진단용 대화 AI AMIE를 실제 환자에게 써본 전향 연구가 실렸다. 보스턴의 한 1차 진료 클리닉에서 환자 98명이 진료 며칠 전 집에서 AMIE와 채팅했다. 감독 의사가 모든 대화를 실시간으로 지켜봤고, 중간에 멈춰야 했던 대화는 없었다. 최종 진단은 AMIE가 꼽은 후보 일곱 개 안에 90% 들어 있었다. 다만 이 연구가 처음부터 물은 것은 진단 실력이 아니라 대화의 안전이었다. 감독 의사를 빼고, 환자에게 진단 후보를 직접 보여주는 순간 남는 숙제는 규제 쪽에 있다.
진료 닷새 전, 집에서 시작된 문진
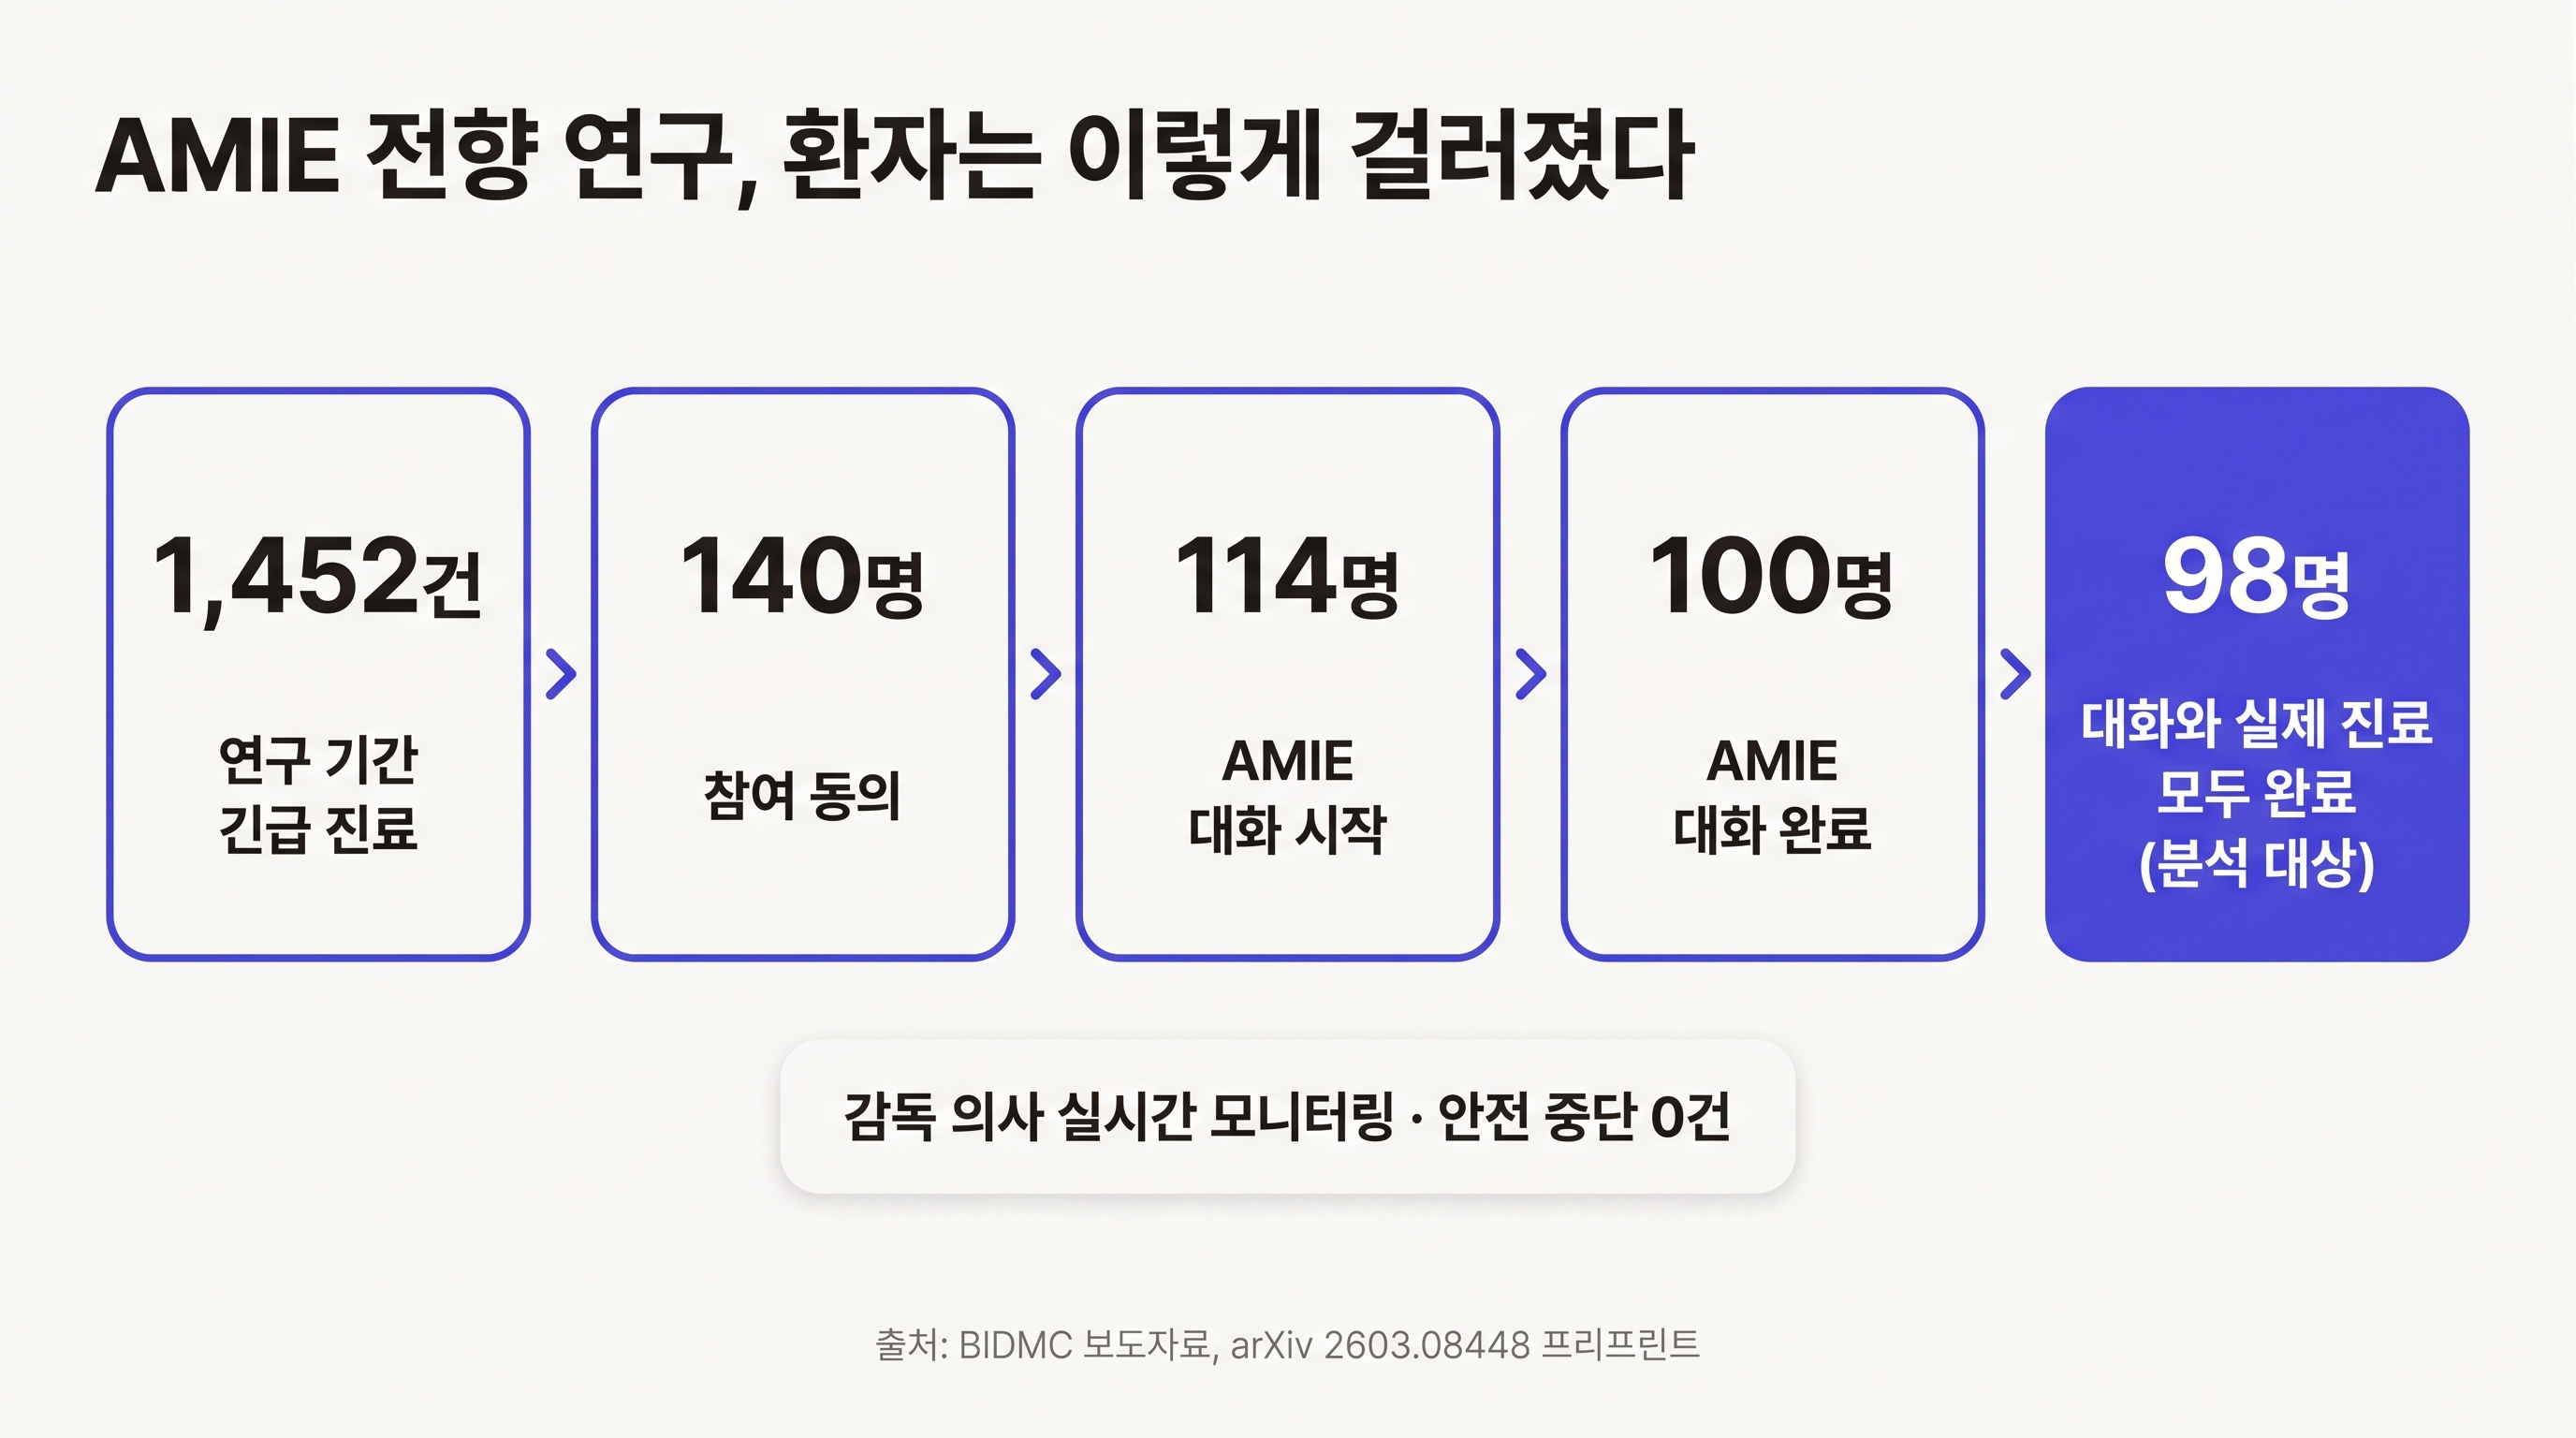
무대는 보스턴 베스이스라엘디코니스 메디컬센터(BIDMC)의 1차 진료 클리닉이다. 2025년 4월부터 11월까지, 새로 생긴 비응급 증상으로 긴급 진료를 예약한 성인에게 참여를 권했다. 동의한 환자는 예약일 최대 5일 전 집에서 노트북이나 데스크톱으로 AMIE와 텍스트 채팅을 했다.
AMIE는 문진을 맡는다. 언제부터 어디가 어떻게 아픈지, 먹는 약은 뭔지 묻고, 대화 끝에 가능한 진단 후보를 환자와 함께 이야기한 뒤 담당 의사가 읽을 요약문을 남긴다. 전자의무기록(EHR)에는 접근하지 못했다. 환자가 채팅창에 쓴 말이 AMIE가 아는 전부였다.
대화 한 건마다 내과 전문의 한 명이 처음부터 끝까지 붙었다. 화상 통화와 화면 공유로 대화를 지켜보다가, 미리 정한 네 가지 상황(자해나 타해 우려, 환자의 심한 정서적 동요, 임상적 위해 가능성, 환자의 중단 요청)이 오면 대화를 끊는 역할이다. 연구팀은 이들을 'AI 감독자'라 불렀다.
BIDMC 발표로는 114명이 등록했고 98명이 AMIE와의 대화와 실제 진료를 모두 마쳤다. 2026년 3월 먼저 공개된 프리프린트(arXiv 2603.08448)에 중간 탈락 사유가 나온다. 프로토콜 위반이나 기술 문제로 7명, 시스템 장애로 5명, 대화 도중 제외 기준에 걸려 2명이 빠졌다. 같은 기간 이 클리닉의 긴급 진료는 1,452건이었다.
연구비는 구글 모회사 알파벳이 댔다. 마지막 저자인 BIDMC의 애덤 로드먼이 연구 기간 일부를 구글 방문연구원으로 지냈다는 사실도 BIDMC 보도자료에 함께 적혀 있다.
배우 환자에서 실제 환자로
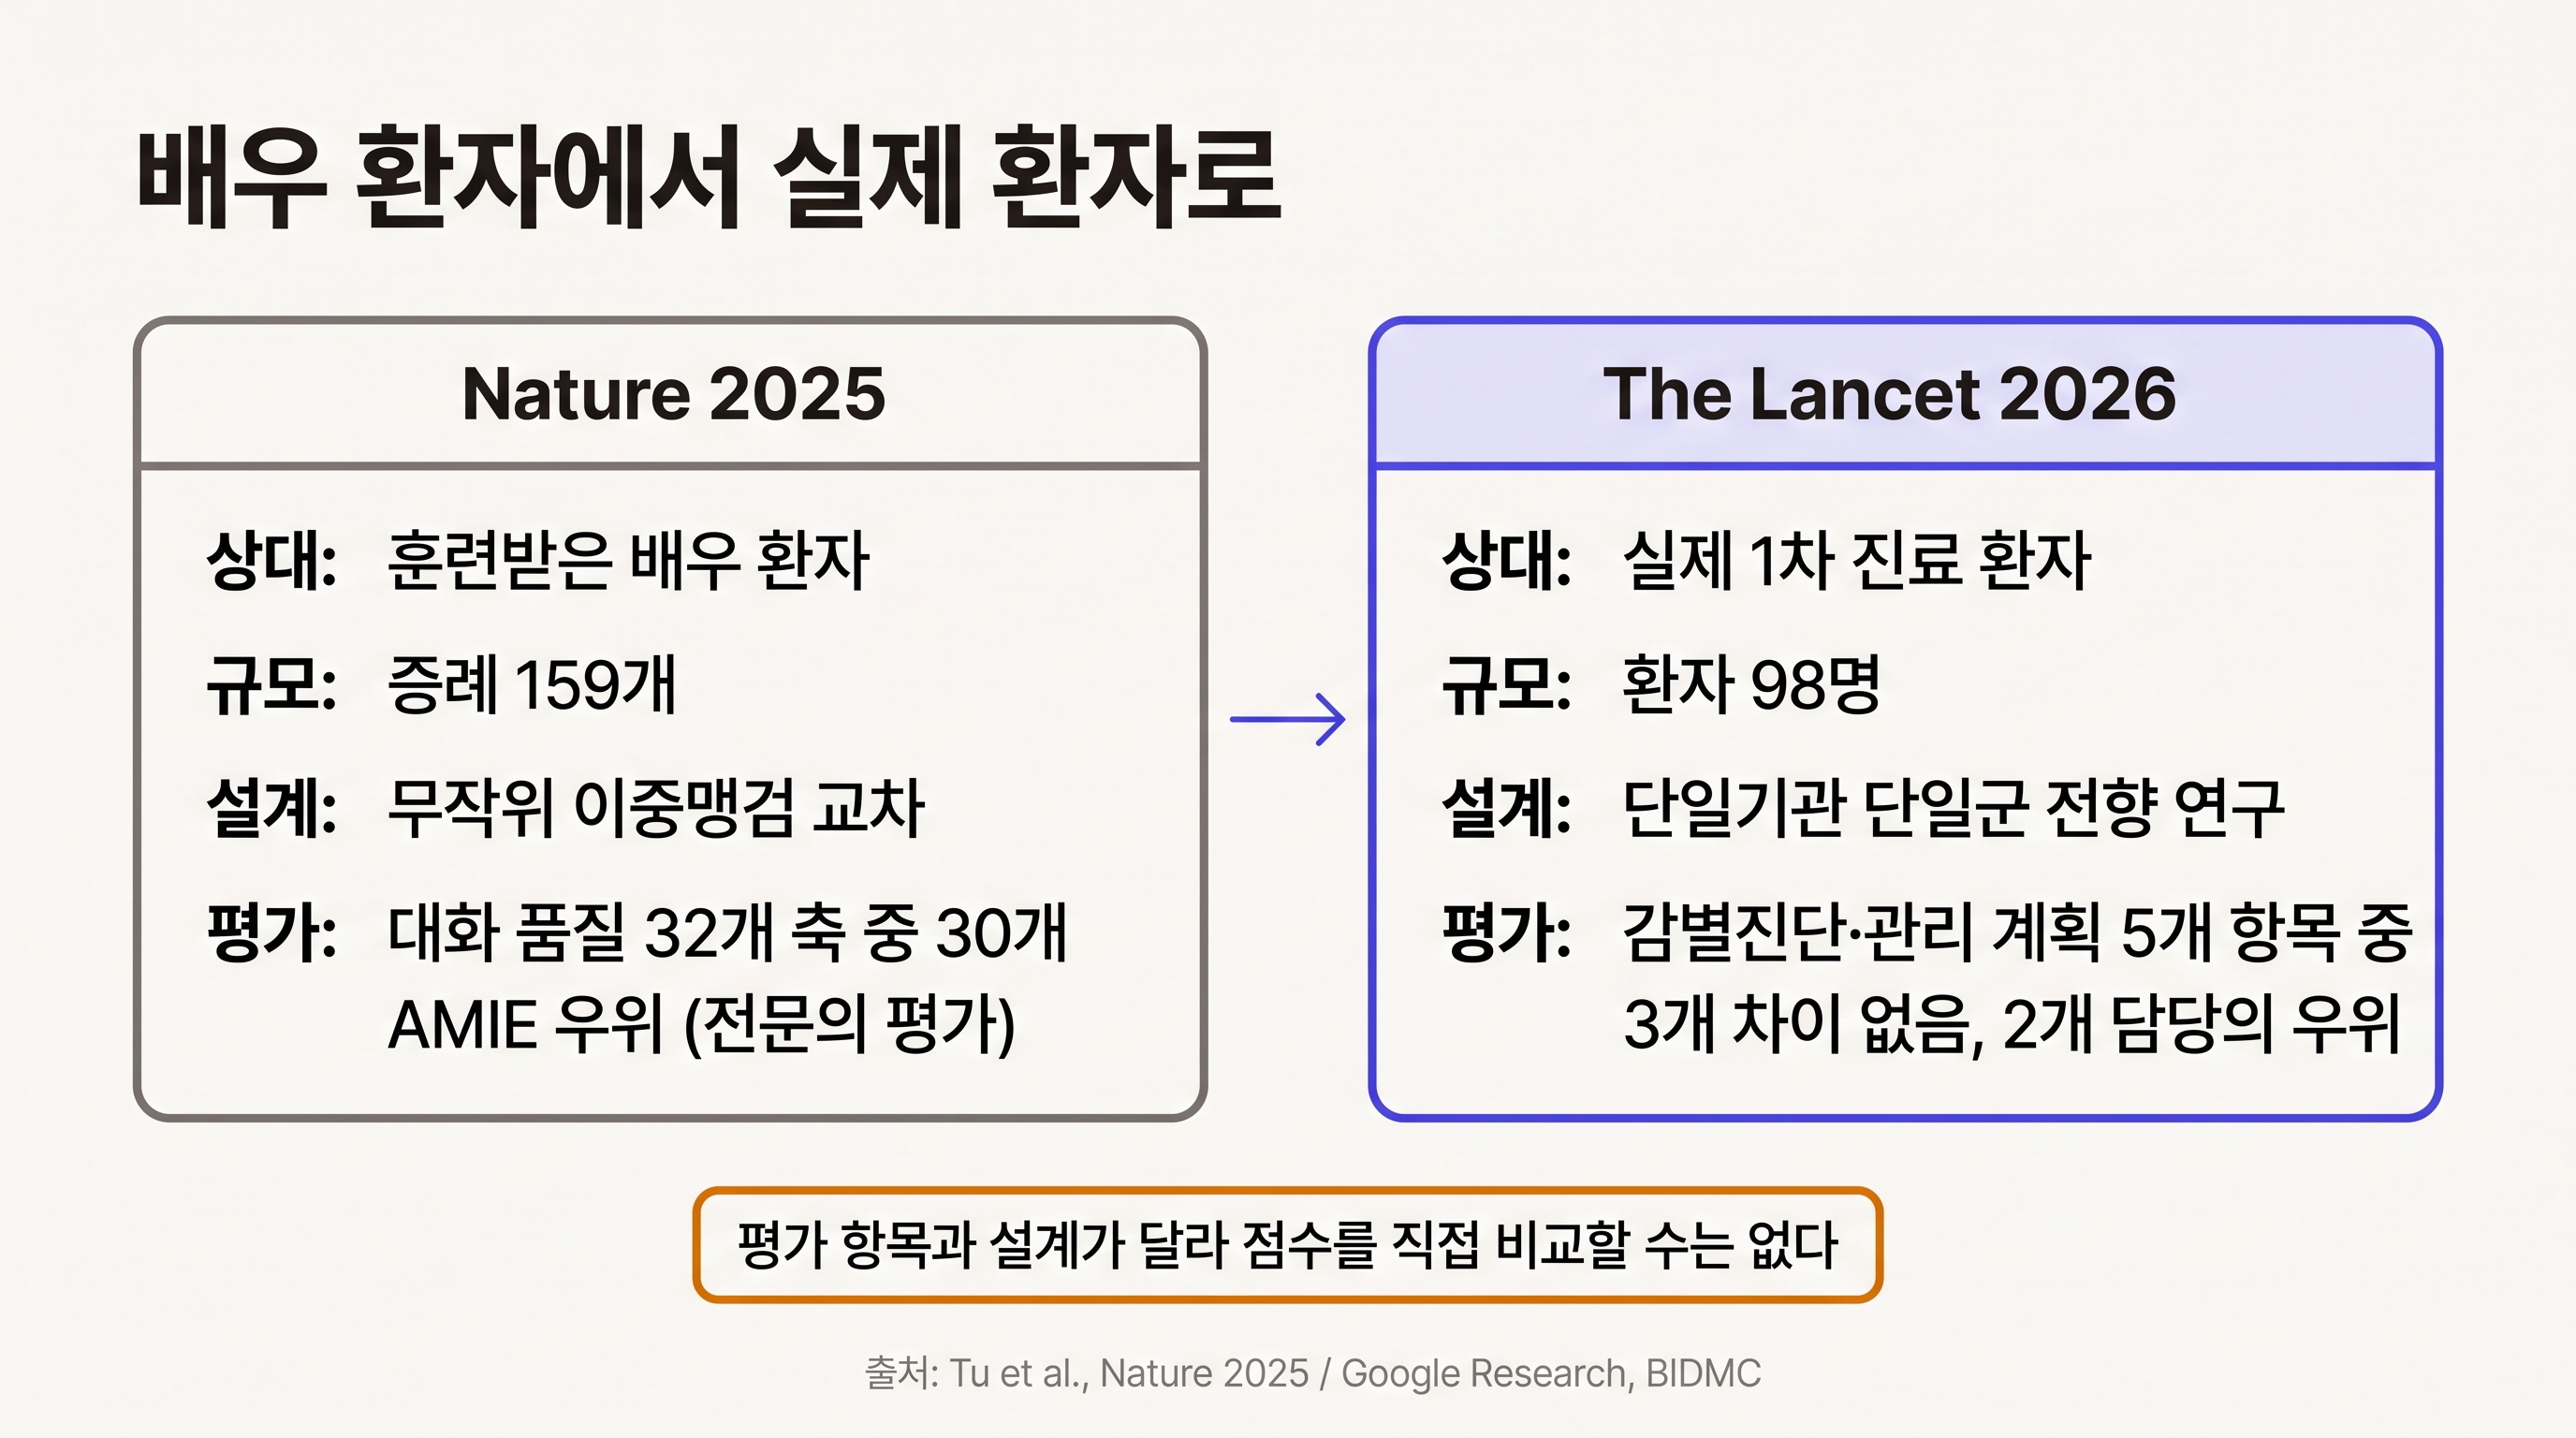
AMIE가 처음 크게 알려진 건 2025년 4월 Nature 논문이다. 그때 상대는 훈련받은 배우였다. 캐나다·영국·인도에서 가져온 159개 증례를 배우가 환자 역할로 연기했고, AMIE와 1차 진료 의사 20명이 무작위로 번갈아 텍스트 상담을 했다. 의대 실기시험(OSCE)을 본뜬 방식이다. 전문의 평가자가 본 32개 축 가운데 30개, 배우가 본 26개 축 가운데 25개에서 AMIE가 앞섰다.
Lancet 연구의 맹검 비교는 결이 다르다. 환자마다 AMIE가 내놓은 감별진단·관리 계획과 실제 담당의의 것을 나란히 놓고, 출처를 가린 채 임상의 세 명이 채점했다. 감별진단의 질, 관리 계획의 적절성과 안전성은 차이가 없었고, 관리 계획의 실용성과 비용효과성은 담당의가 앞섰다. 프리프린트 기준 p값은 실용성 0.003, 비용효과성 0.004다.
두 연구를 "이기다가 비겼다"로 묶고 싶어지지만 그렇게 읽으면 안 된다. Nature는 대화 품질을 수십 개 축으로 쟀고, Lancet은 진단과 처방 결과물 다섯 항목을 쟀다. 재는 대상이 다르니 점수를 맞댈 수 없다. 대신 둘을 이어 보면 질문이 달라진 게 보인다. "AI가 대화를 잘하나"에서 "실제 환자에게 써도 되나"로.
담당의가 실용성에서 앞선 이유는 짐작이 간다. 담당의는 진료 기록에서 지난번 검사 결과를 확인하고, 청진기를 대고, 환자의 형편에서 가능한 검사를 고른다. 구글 연구팀도 그 격차의 원인으로 EHR 접근 불가, 신체 진찰 불가, 시각 정보 부재를 꼽았다. 평가자의 눈가림이 완전했는지도 따져 볼 만한데, 프리프린트에서 평가자가 AI 답을 맞힌 비율은 59.18%(95% 신뢰구간 49.45~68.91)였다. 우연과 구별하기 어려운 수준이다.
90%라는 숫자를 읽는 법
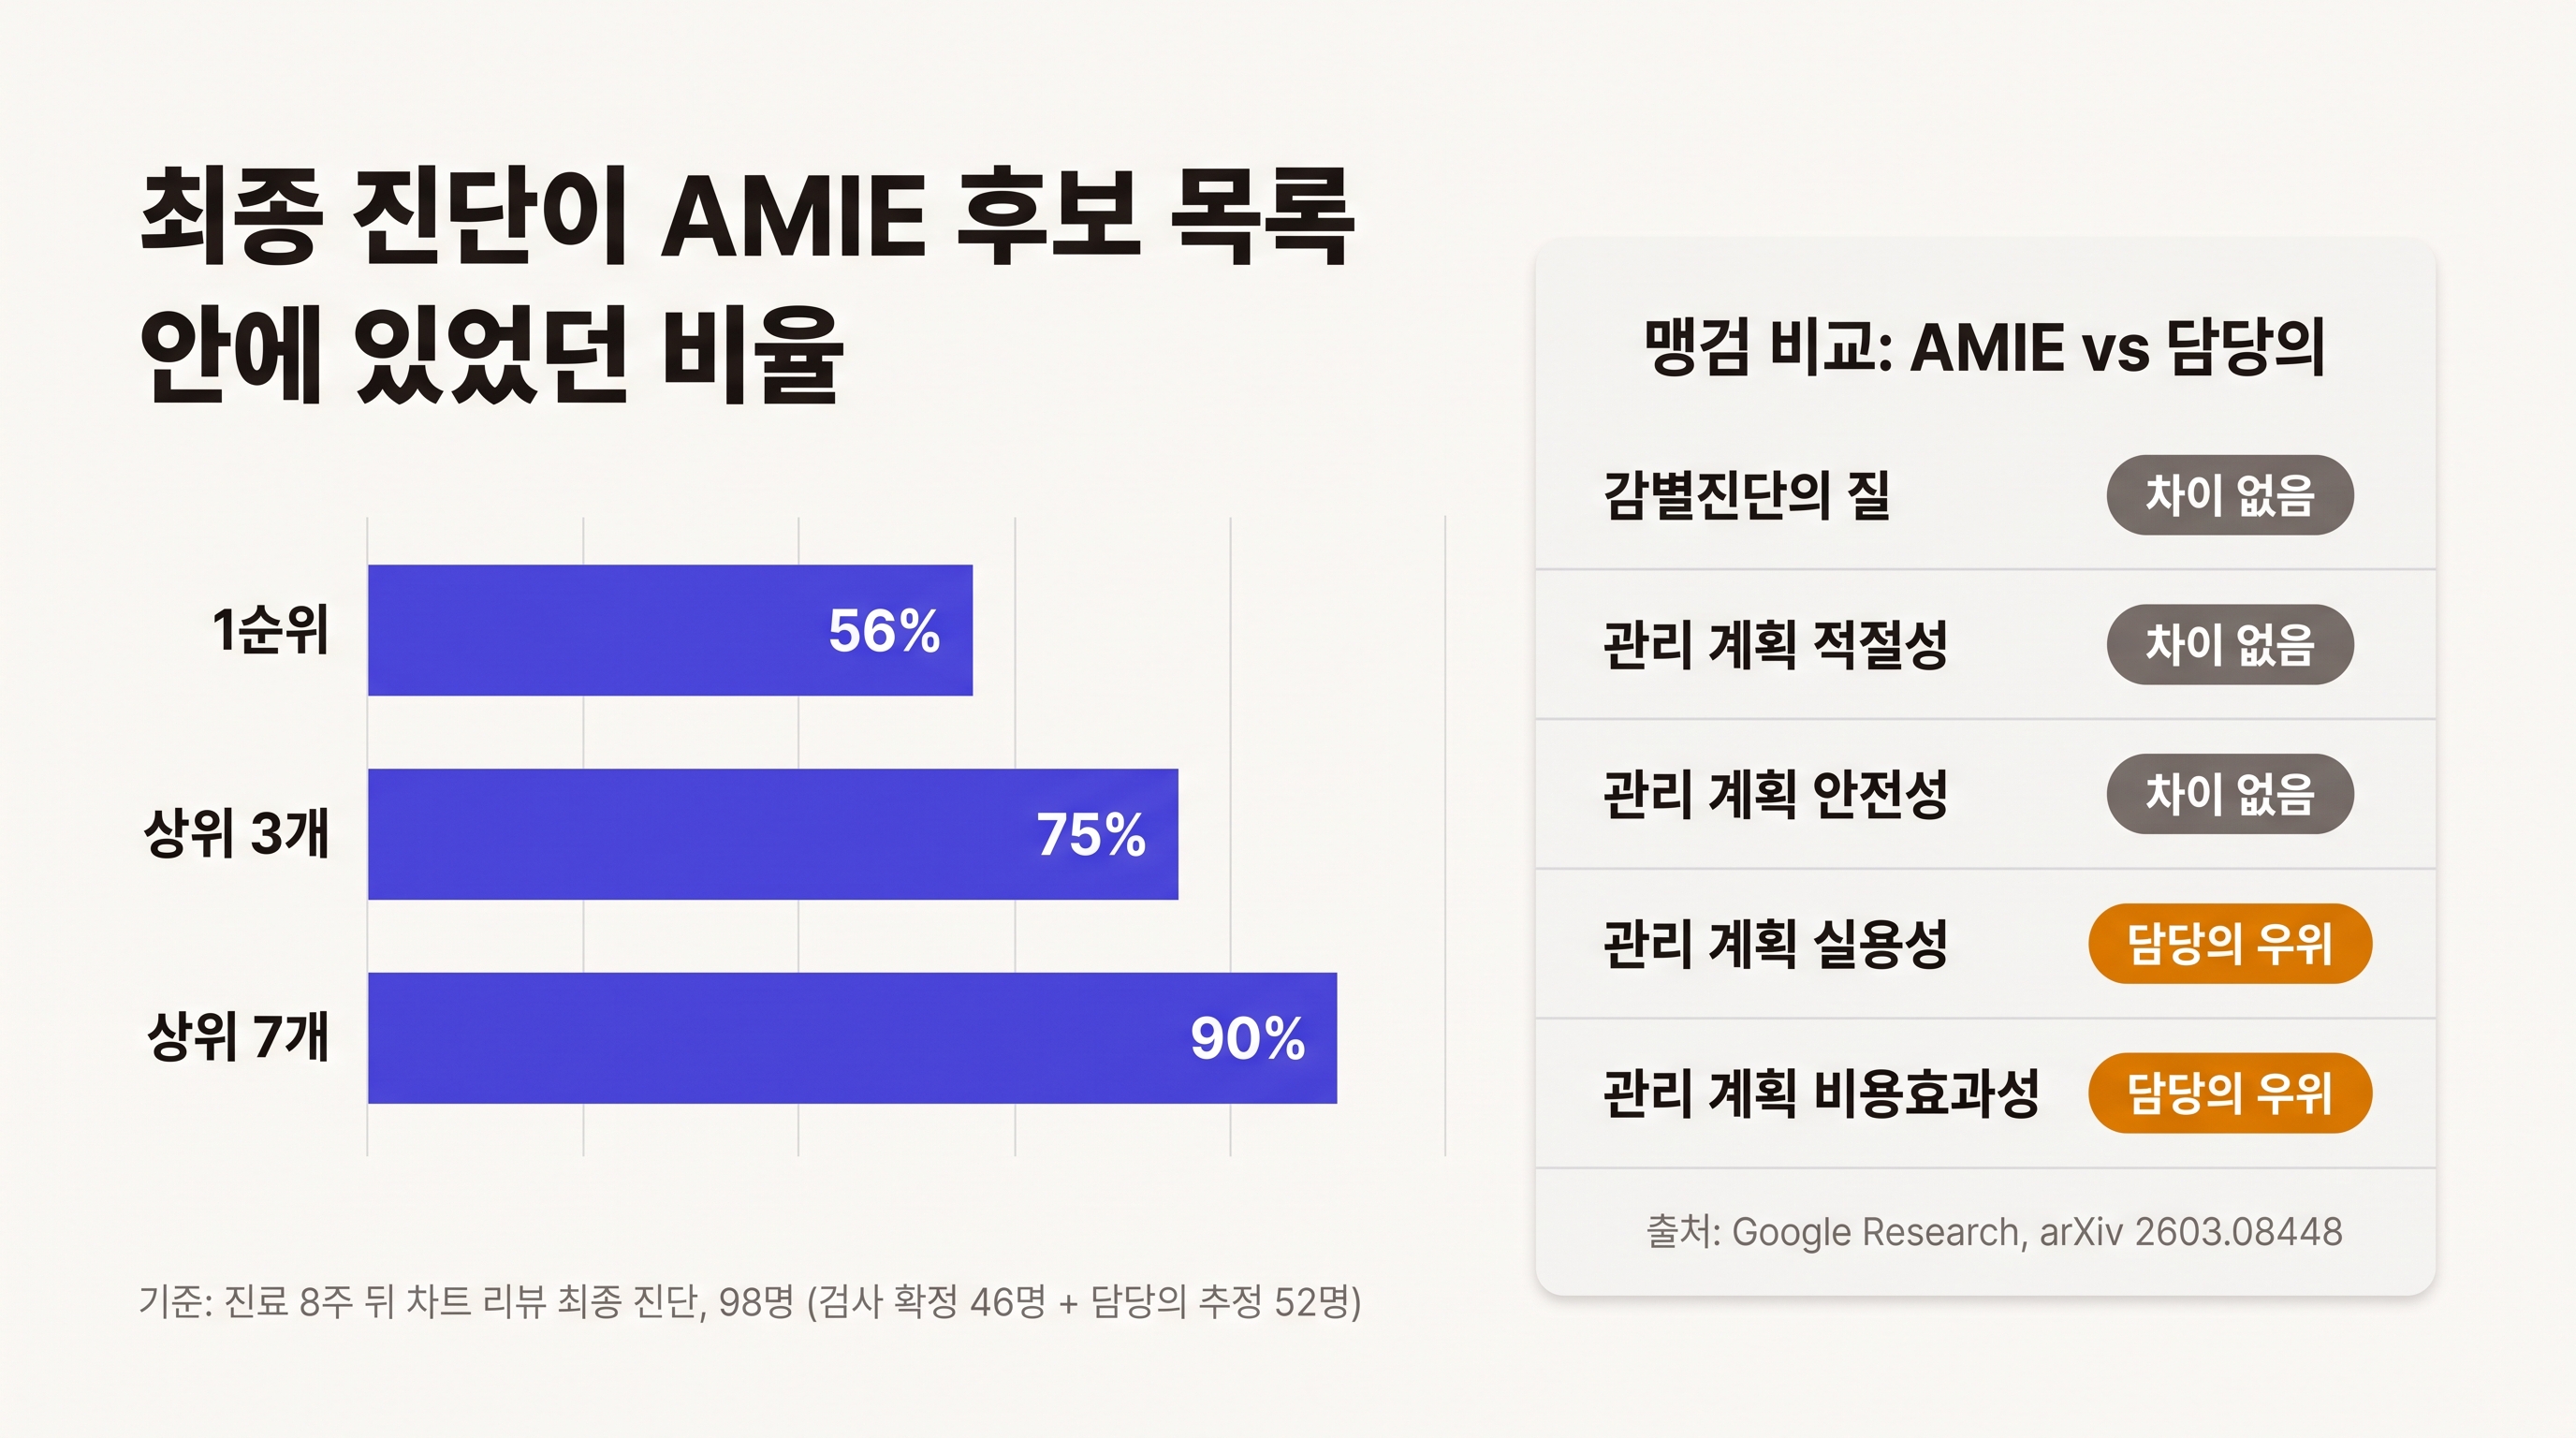
언론이 가장 많이 인용한 숫자는 90%다. 진료 8주 뒤 차트를 다시 열어 정한 최종 진단이 AMIE의 후보 목록 안에 있었던 비율이다. 이 숫자는 목록을 얼마나 길게 보느냐에 따라 달라진다. 후보 일곱 개까지 보면 90%, 세 개까지 보면 75%, 맨 위 하나만 보면 56%. AMIE의 1순위 답이 맞은 건 두 명 중 한 명꼴이었다.
이 숫자가 높은지 낮은지 판단할 잣대는 논문에 없다. 담당의의 1순위 정확도를 같은 방식으로 잰 값이 공개되지 않았기 때문이다. 정답을 정한 방식에도 단서가 붙는다. 98명 가운데 검사로 진단이 확정된 사람은 46명이고, 나머지 52명은 담당의의 추정 진단을 정답으로 썼다. 담당의가 틀렸다면 AMIE도 같이 틀린 것으로 채점됐을 수 있다. 연구팀은 검사 확정 46명에서도 정확도가 높게 유지됐다고 밝혔지만, 공개 자료에서 그 수치는 찾지 못했다.
연구 등록 정보도 같은 방향을 가리킨다. ClinicalTrials.gov(NCT06911398)에 올라간 1차 결과변수는 채팅 중단 건수, 대화 품질, 환자와 의사의 만족도다. 진단 정확도와 관리 계획의 질은 2차 결과변수였다. 애초에 "AMIE가 진단을 잘하나"보다 "실제 환자와 대화해도 괜찮은가"를 묻도록 짠 연구고, 90%는 그 과정에서 함께 잰 값이다.
감독자가 지켜본 98번의 대화
안전 중단 0건은 이 연구의 핵심 결과다. 그 숫자가 나온 조건을 함께 봐야 한다.
먼저 감독자는 대화를 끊지 않았을 뿐 손을 놓고 있지는 않았다. BIDMC 발표에 따르면 감독 의사들은 환각(사실이 아닌 내용을 그럴듯하게 지어내는 LLM의 오류) 1건을 찾아냈고, 5건에서 임상적 설명을 덧붙였다. 프리프린트에는 집계가 조금 달라 감독자 언급 3건이 적혀 있는데, 응급 여부를 가리려고 증상을 다시 확인한 일과 AMIE가 잘못 말한 수술 날짜를 바로잡은 일이 들어 있다. 중단 기준에 닿지 않았을 뿐 사람이 끼어든 대화가 있었다.
위험한 환자는 처음부터 들어오지 않았다. 응급 증상, 임신, 정신건강 문제로 온 환자는 제외됐다. 그러니 AMIE가 응급 환자를 걸러낼 수 있는지는 이 연구로 알 수 없고, 연구팀도 이를 한계로 적었다.
참여자 구성도 클리닉 전체와 달랐다. 연구 기간 긴급 진료 환자는 절반 이상이 60세 이상이었는데, 분석 대상 98명은 50세 미만이 51%였다. 기준 연령이 달라 정확히 맞댈 수는 없지만 표본이 더 젊었던 건 분명하다. 컴퓨터가 없는 사람은 참여할 수 없었고, 연구팀은 적극적인 환자가 스스로 골라 들어왔을 가능성을 한계로 꼽았다.
시험한 모델도 도중에 바뀌었다. 프리프린트에 따르면 처음 50건은 Gemini 2.5 Pro의 추론 모드로 돌렸고, 응답이 느려 이후 Gemini 2.5 Flash로 갈아탔다. 이 연구의 'AMIE'는 하나로 고정된 소프트웨어가 아니었다.
의사들의 반응은 좋았다. 진료 전에 AMIE 기록이나 요약을 본 44건에서 75%가 준비에 도움이 됐다고, 57%가 진료 방향에 영향을 줬을 수 있다고 답했다. 반대 사례도 하나 있다. AMIE가 감별진단 후보에 림프종을 올려 환자가 불안해했을 수 있다며 한 의사가 그 대화를 "다소 해로웠다"고 평가했다. 환자에게 진단 후보를 직접 보여주는 설계라면 피하기 어려운 장면이다.
환자에게 진단을 보여주면 규제가 달라진다
AMIE는 아직 제품이 아니다. 구글은 공식 블로그에서 AMIE를 "연구용 진단 AI 챗봇"이라 불렀고 규제 승인 계획은 꺼내지 않았다. 그래도 이번 연구 설계를 그대로 상품으로 옮긴다면 미국에서 어떤 문이 열리고 닫히는지는 법 조문으로 가늠할 수 있다.
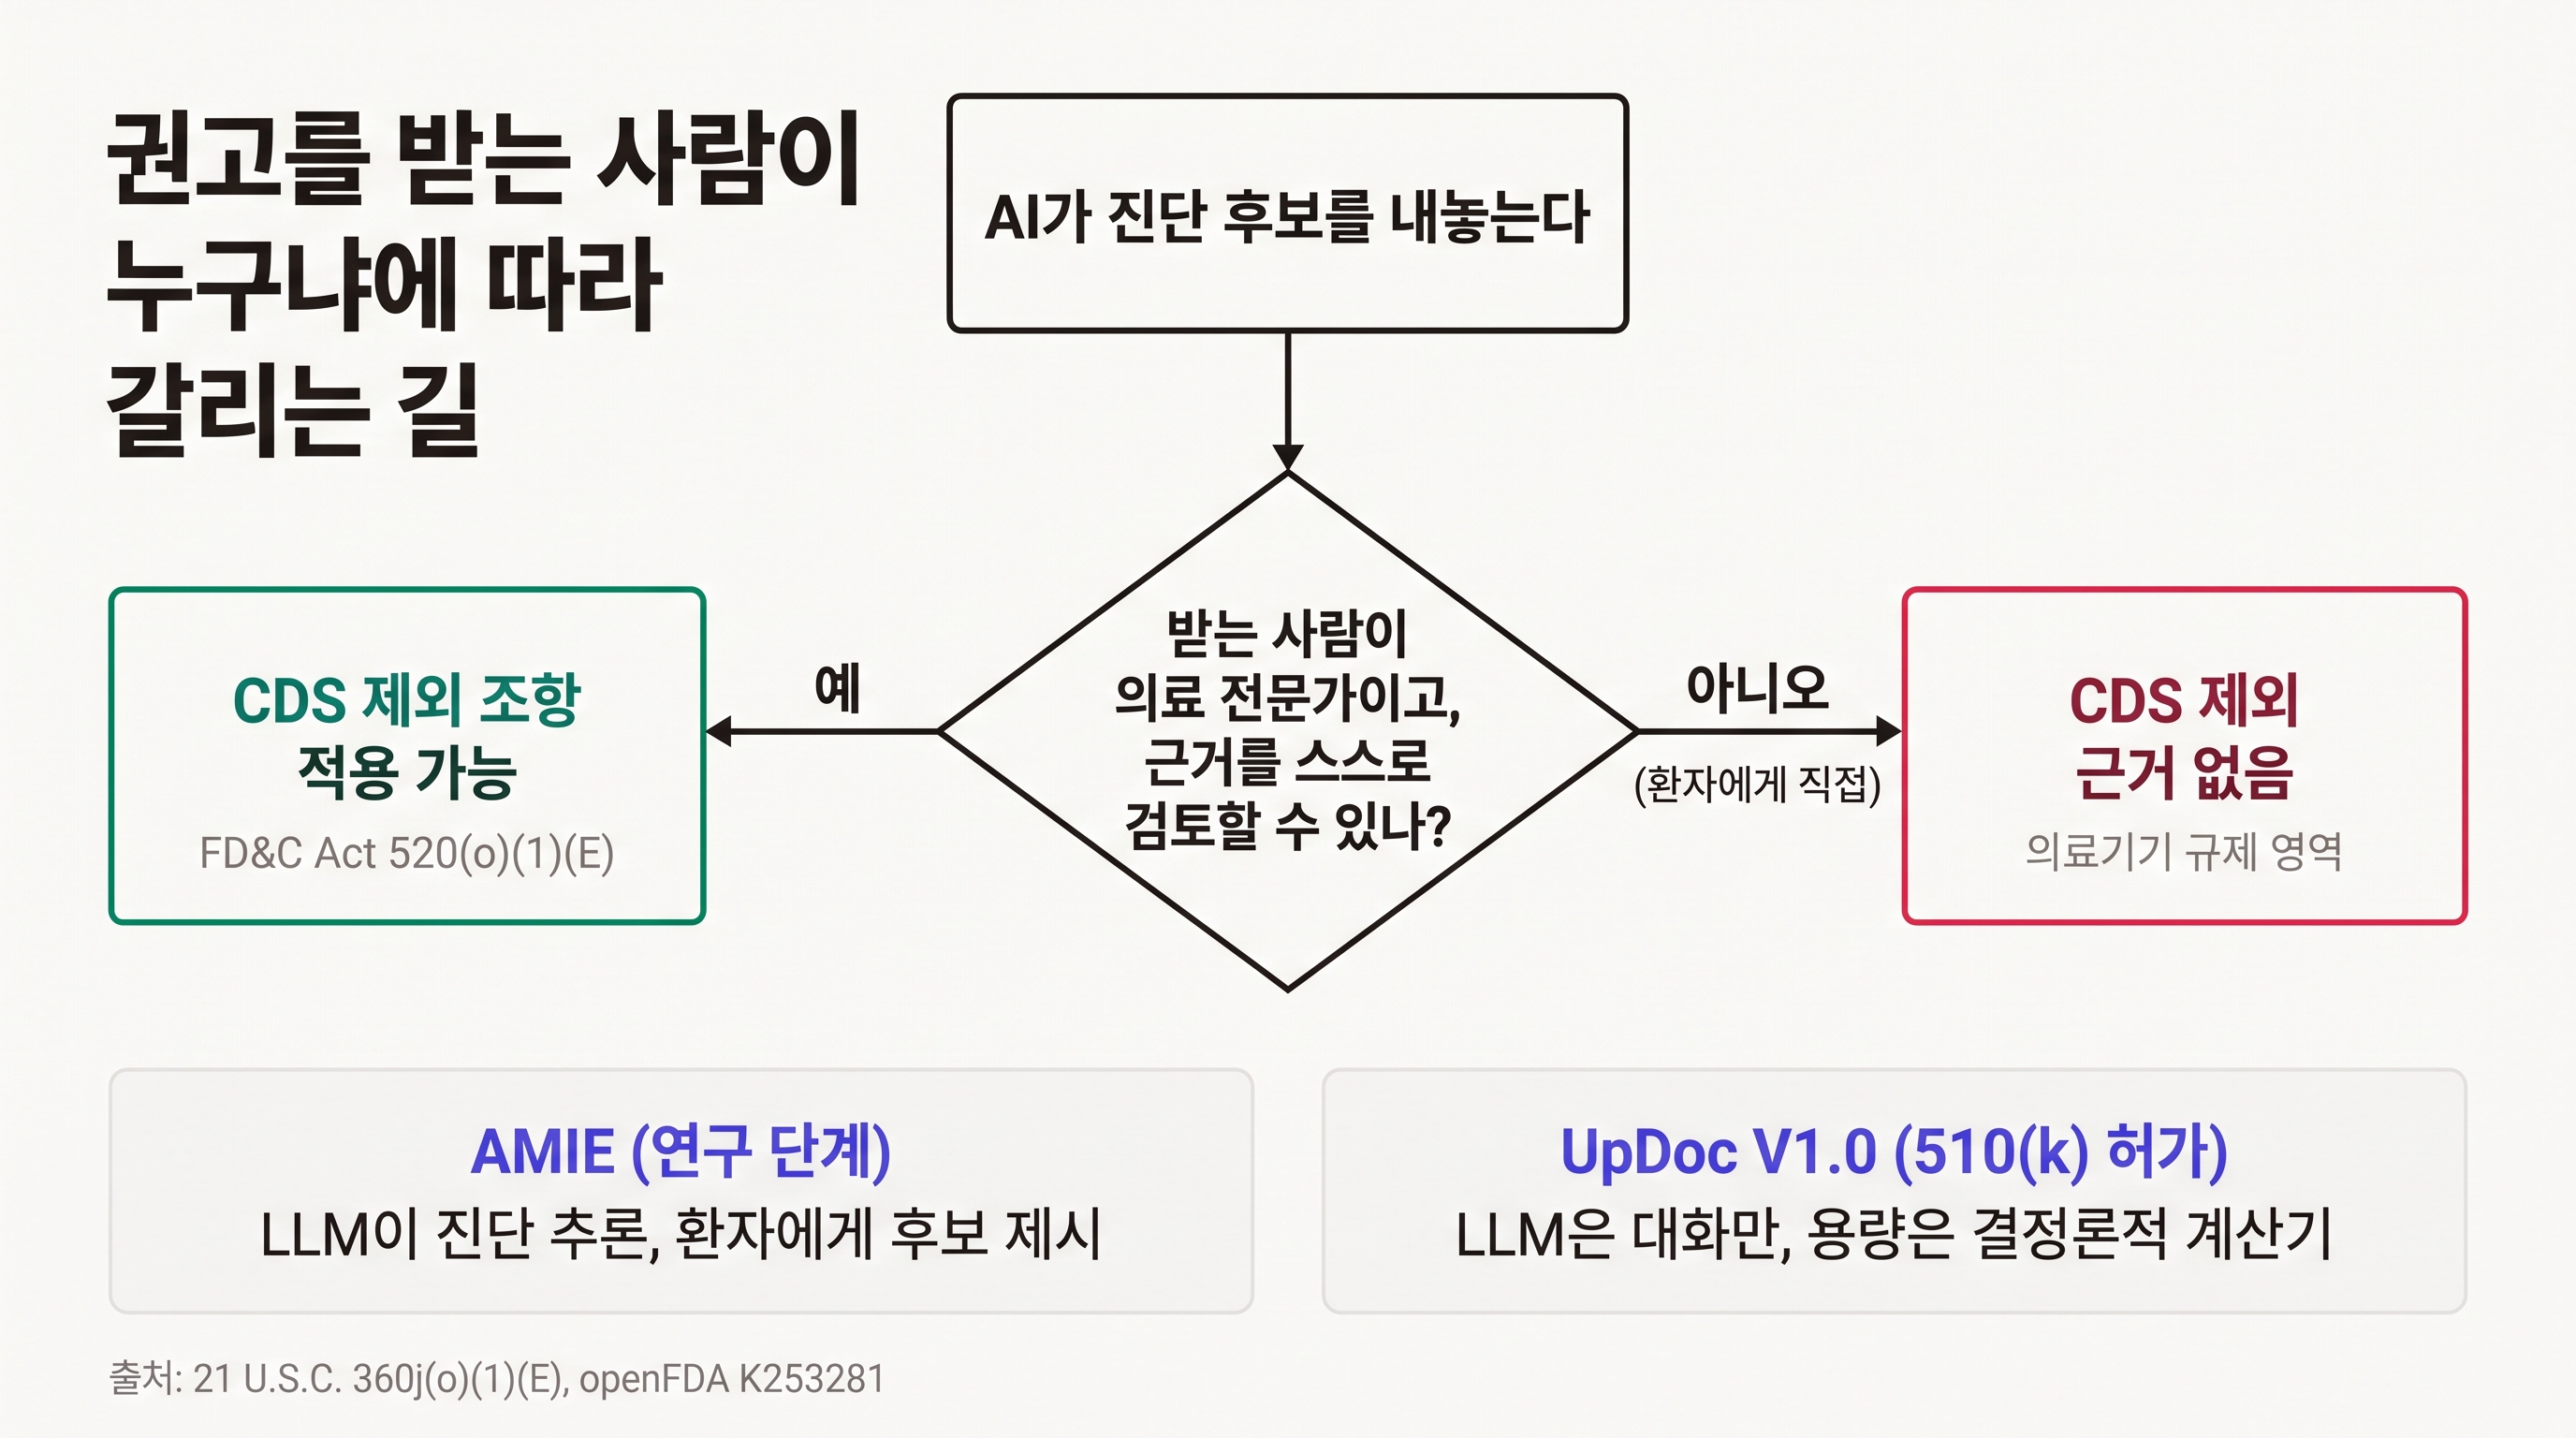
연방식품의약품화장품법 520(o)(1)(E)는 임상의사결정지원(CDS) 소프트웨어를 의료기기 정의에서 빼 주는 조항이다. 조건이 둘 붙는다. 권고를 받는 사람이 "의료 전문가(health care professional)"여야 하고, 그 전문가가 권고의 근거를 스스로 검토할 수 있어야 한다. 의사가 참고만 하는 도구라면 의료기기로 보지 않겠다는 논리다.
AMIE가 의사에게 넘기는 요약문만 보면 이 조항에 기댈 여지가 있다. 그런데 이번 연구에서 AMIE는 환자와 직접 대화하며 진단 후보를 환자에게 보여줬고, 연구팀은 결론에서 "환자에게 가능한 진단을 안전하게 제시했다"는 점을 성과로 꼽았다. 받는 사람이 환자라면 CDS 제외 조항의 첫 조건부터 어긋난다. 이 출구는 닫힌다. 그다음 FDA가 어떤 심사 경로를 요구할지, 집행재량을 둘지는 제품이 정해질 때 가서야 알 수 있다.
FDA도 이 지점을 들여다보고 있다. 8월 18일 FDA 디지털헬스 우수센터가 낸 생성형 AI 의료기기 토론 문서(Docket FDA-2026-N-7874)는 일주일 뒤인 10월 19일 의견수렴을 닫는다. 법무법인 Arnold & Porter의 정리에 따르면 문서는 환자용 기능이 의료진용과 다르거나 더 큰 위험을 가질 수 있다고 봤고, 여러 차례 주고받는 대화형 시스템이 대화가 이어질수록 점점 지시적으로 변할 수 있다는 점을 따로 짚었다. 증상을 묻던 대화가 어느새 "림프종일 수도 있다"에 닿는 AMIE의 대화가 바로 그런 사례다.
대조할 만한 제품이 하나 있다. FDA가 2025년 12월 허가한 UpDoc V1.0(510(k) K253281)도 환자와 직접 대화하는 LLM 제품이다. 다만 여기서 LLM은 대화만 맡고 인슐린 용량은 결정론적 계산기가 정한다. 의료기기로서 책임질 판단을 예측 가능한 부분에만 몰아 둔 설계다. AMIE는 반대로 진단 추론 자체를 LLM이 한다. 이 블로그가 2월에 정리했듯, 진단 판단을 LLM이 직접 내리는 구조로 FDA 문턱을 넘은 사례는 우리가 확인한 범위에서 아직 없다.
AMIE가 다음에 넘어야 할 것
이번 연구가 보여준 것은 "의사가 옆에서 지켜보면 진단용 LLM과 실제 환자의 대화를 안전하게 진행할 수 있다"는 데까지다. 제목에 붙은 타당성(feasibility)이라는 단어가 그 범위를 정확히 말해 준다. 로드먼이 이끄는 연구 네트워크 ARISE도 이 결과가 "감독 없는 AI를 진료에 써도 된다는 증거는 아니다"라고 적었다.
남은 질문은 두 가지다. 하나는 감독자를 빼면 무슨 일이 생기느냐다. 대화 한 건에 내과 전문의 한 명이 내내 붙는 구조는 연구로는 훌륭하지만, 의사 시간을 아끼려는 도구로는 성립하지 않는다. 다른 하나는 대조군이다. 단일군 연구로는 AMIE를 거친 환자가 그렇지 않은 환자보다 더 나은 진료를 받았는지 알 수 없다. 구글과 BIDMC 모두 대조군을 둔 더 큰 연구가 필요하다고 했다.
두 질문은 FDA 토론 문서의 고민과 그대로 겹친다. 감독자를 빼는 순간 AMIE는 "환자용이면서 점점 지시적으로 변하는 대화형 시스템"이 되고, 그런 시스템에 어떤 증거를 요구할지가 바로 10월 19일까지 FDA가 의견을 받는 주제다. 배우 환자 점수만 있던 자리에, 감독 아래서나마 실제 환자 98명의 기록이 놓였다. 다음 연구가 감독자를 얼마나 덜어내느냐가 AMIE가 연구실을 나설 수 있는지를 가를 것이다.
출처
- Google 공식 블로그(The Keyword), Mike Schaekermann, AMIE Lancet 게재 발표, 2026-10-08. https://blog.google/innovation-and-ai/technology/health/amie-clinical-study-lancet/
- Google Research 블로그, "Exploring the feasibility of conversational diagnostic AI in a real-world clinical study," 2026-03-11 (2026-10-08 업데이트). https://research.google/blog/exploring-the-feasibility-of-conversational-diagnostic-ai-in-a-real-world-clinical-study/
- BIDMC 보도자료, Jacqueline Mitchell, 2026-10-09. https://www.bidmc.org/news-stories/all-news-stories/news/2026/10/bidmc-research-shows-safety-quality-of-ai-in-primary-care
- Brodeur P, Koshy JM, et al. The Lancet, 2026-10-08 (본문 미열람, 수치는 위 발표문 기준). https://www.thelancet.com/journals/lancet/article/PIIS0140-6736(26)01535-7/fulltext
- Brodeur P, Koshy JM, Palepu A, et al. "A prospective clinical feasibility study of a conversational diagnostic AI in an ambulatory primary care clinic." arXiv:2603.08448 (프리프린트, v3 2026-03-15). https://arxiv.org/abs/2603.08448
- ClinicalTrials.gov, NCT06911398. https://clinicaltrials.gov/study/NCT06911398
- ARISE 블로그, AMIE Lancet 게재 소개, 2026-10-08. https://www.arise-ai.org/blog/amie-lancet
- Tu T, et al. "Towards conversational diagnostic artificial intelligence." Nature 2025;642:442–450. doi:10.1038/s41586-025-08866-7
- 21 U.S.C. 360j(o)(1)(E). https://www.law.cornell.edu/uscode/text/21/360j
- FDA, "Considerations for the Regulation of Generative AI-Enabled Medical Devices: Discussion Paper and Request for Feedback," Docket FDA-2026-N-7874. https://www.fda.gov/medical-devices/digital-health-center-excellence/considerations-regulation-generative-ai-enabled-medical-devices-discussion-paper-and-request
- Arnold & Porter, "FDA Seeks Public Feedback on Regulatory Approach for Generative AI-Enabled Medical Devices," 2026-09-01. https://www.arnoldporter.com/en/perspectives/advisories/2026/09/fda-seeks-public-feedback-on-regulatory-approach-for-generative-ai-enabled-medical-devices
- openFDA 510(k) K253281 (UpDoc, 결정일 2025-12-23, 제품코드 NDC). https://api.fda.gov/device/510k.json?search=k_number:K253281