10월 15일 JAMA에 의사용 AI 검색 서비스 OpenEvidence의 사용 기록을 분석한 논문이 실렸다. 2년 반 동안 미국 의료인 95만 명이 2억 7,100만 건을 물었다. 의사들이 가장 많이 물은 것은 진단이 아니라 치료였고, 가장 열심히 쓴 사람은 젊은 의사와 내과 계열이었다. 다만 이 논문은 답이 맞았는지, 환자에게 도움이 됐는지는 재지 않았다. 데이터도 회사가 내놨다.
JAMA가 들여다본 2억 7,100만 개의 질문
OpenEvidence는 의사가 자연어로 질문하면 논문과 진료지침을 인용해 답을 돌려주는 서비스다. 예를 들어 "신기능이 떨어진 심방세동 환자에게 항응고제 용량을 어떻게 맞추나" 같은 질문을 넣으면(논문에 실린 실제 질문이 아니라 이해를 돕기 위한 예시다), 근거 문헌 링크가 달린 요약 답변이 나온다. 쓰는 감각은 검색창에 가깝지만, 뒤에서 답을 만드는 것은 대규모 언어모델(LLM)이다. 미국 의사면허 번호(NPI)로 의료인임을 확인하면 무료로 쓸 수 있다.
이번 JAMA 논문("Clinician Use of an Artificial Intelligence–Enabled Clinical Information Platform")은 이 서비스의 2024년 1월부터 2026년 6월까지 30개월치 질문 기록을 분석한 횡단면 연구다. 횡단면 연구란 특정 시점이나 기간의 상태를 한 번에 잘라 보는 연구로, 무엇이 무엇을 일으켰는지는 말하지 못하고 "어떤 모습이었는지"를 보여준다. 분석 대상은 NPI가 국가 의료인 등록부(NPPES)와 일치하고 질문을 한 번이라도 한 계정이다.
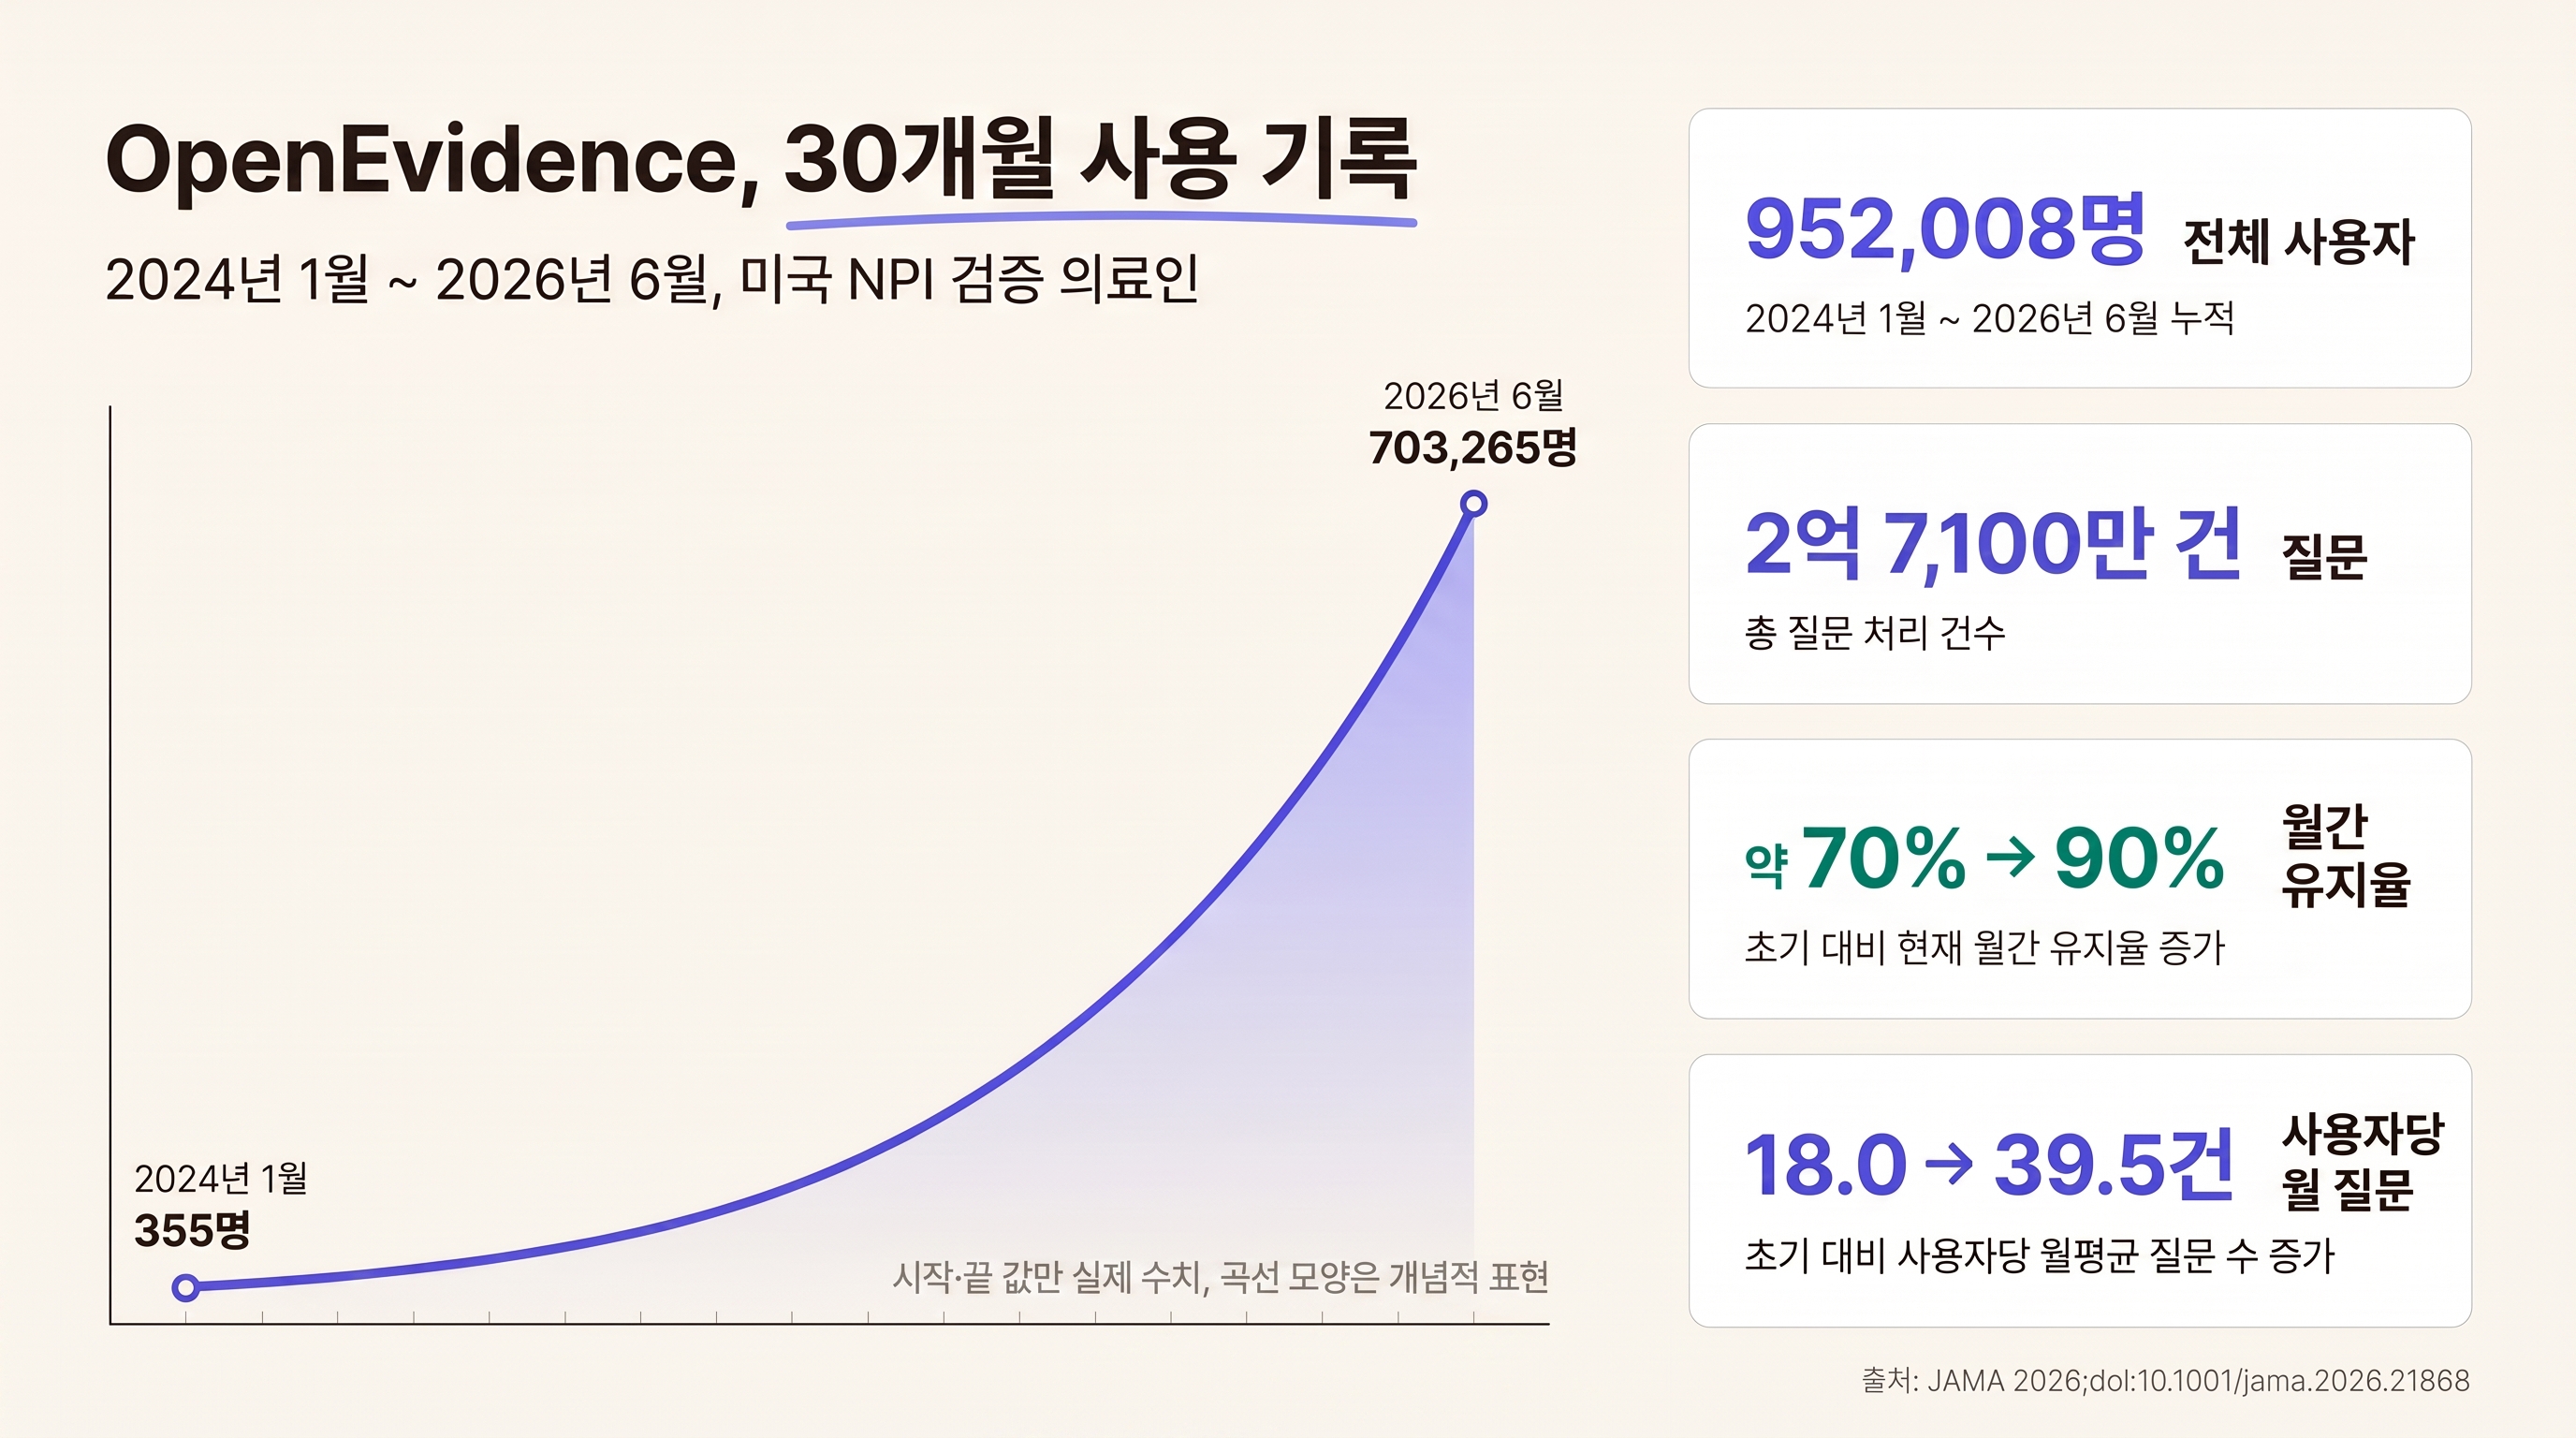
숫자부터 보자. 의료인 952,008명이 질문 2억 7,100만 건을 남겼다. 이 중 의사가 556,200명으로 사용자의 58.4%, 질문은 1억 7,210만 건으로 63.5%였다. 전문간호사(NP) 171,034명, 의사보조인력(PA) 93,241명, 약사 35,819명이 뒤를 잇는다.
성장 곡선은 가파르다. 월간 활성 사용자는 2024년 1월 355명에서 2026년 6월 703,265명이 됐다. 한 달에 들어오는 질문은 약 6,000건에서 2,780만 건으로 늘었다. 사용자 한 명이 한 달에 던지는 질문도 평균 18.0건에서 39.5건으로 두 배 넘게 뛰었다.
더 눈여겨볼 지표는 유지율이다. 이번 달에 쓴 사람이 다음 달에도 쓰는 비율이 2024년 초 약 70%에서 2026년 약 90%로 올랐다. 2026년 6월 활성 사용자의 92.5%는 이전에 써본 사람이었다. 하루만 써보고 떠난 사람은 9.6%였고, 첫 사용 이후 매달 최소 68%가 계속 활동했다. 호기심에 한 번 눌러보는 단계를 지나 업무 습관으로 자리 잡았다고 읽을 만한 숫자다.
가장 많이 쓴 사람은 젊은 의사와 내과 계열
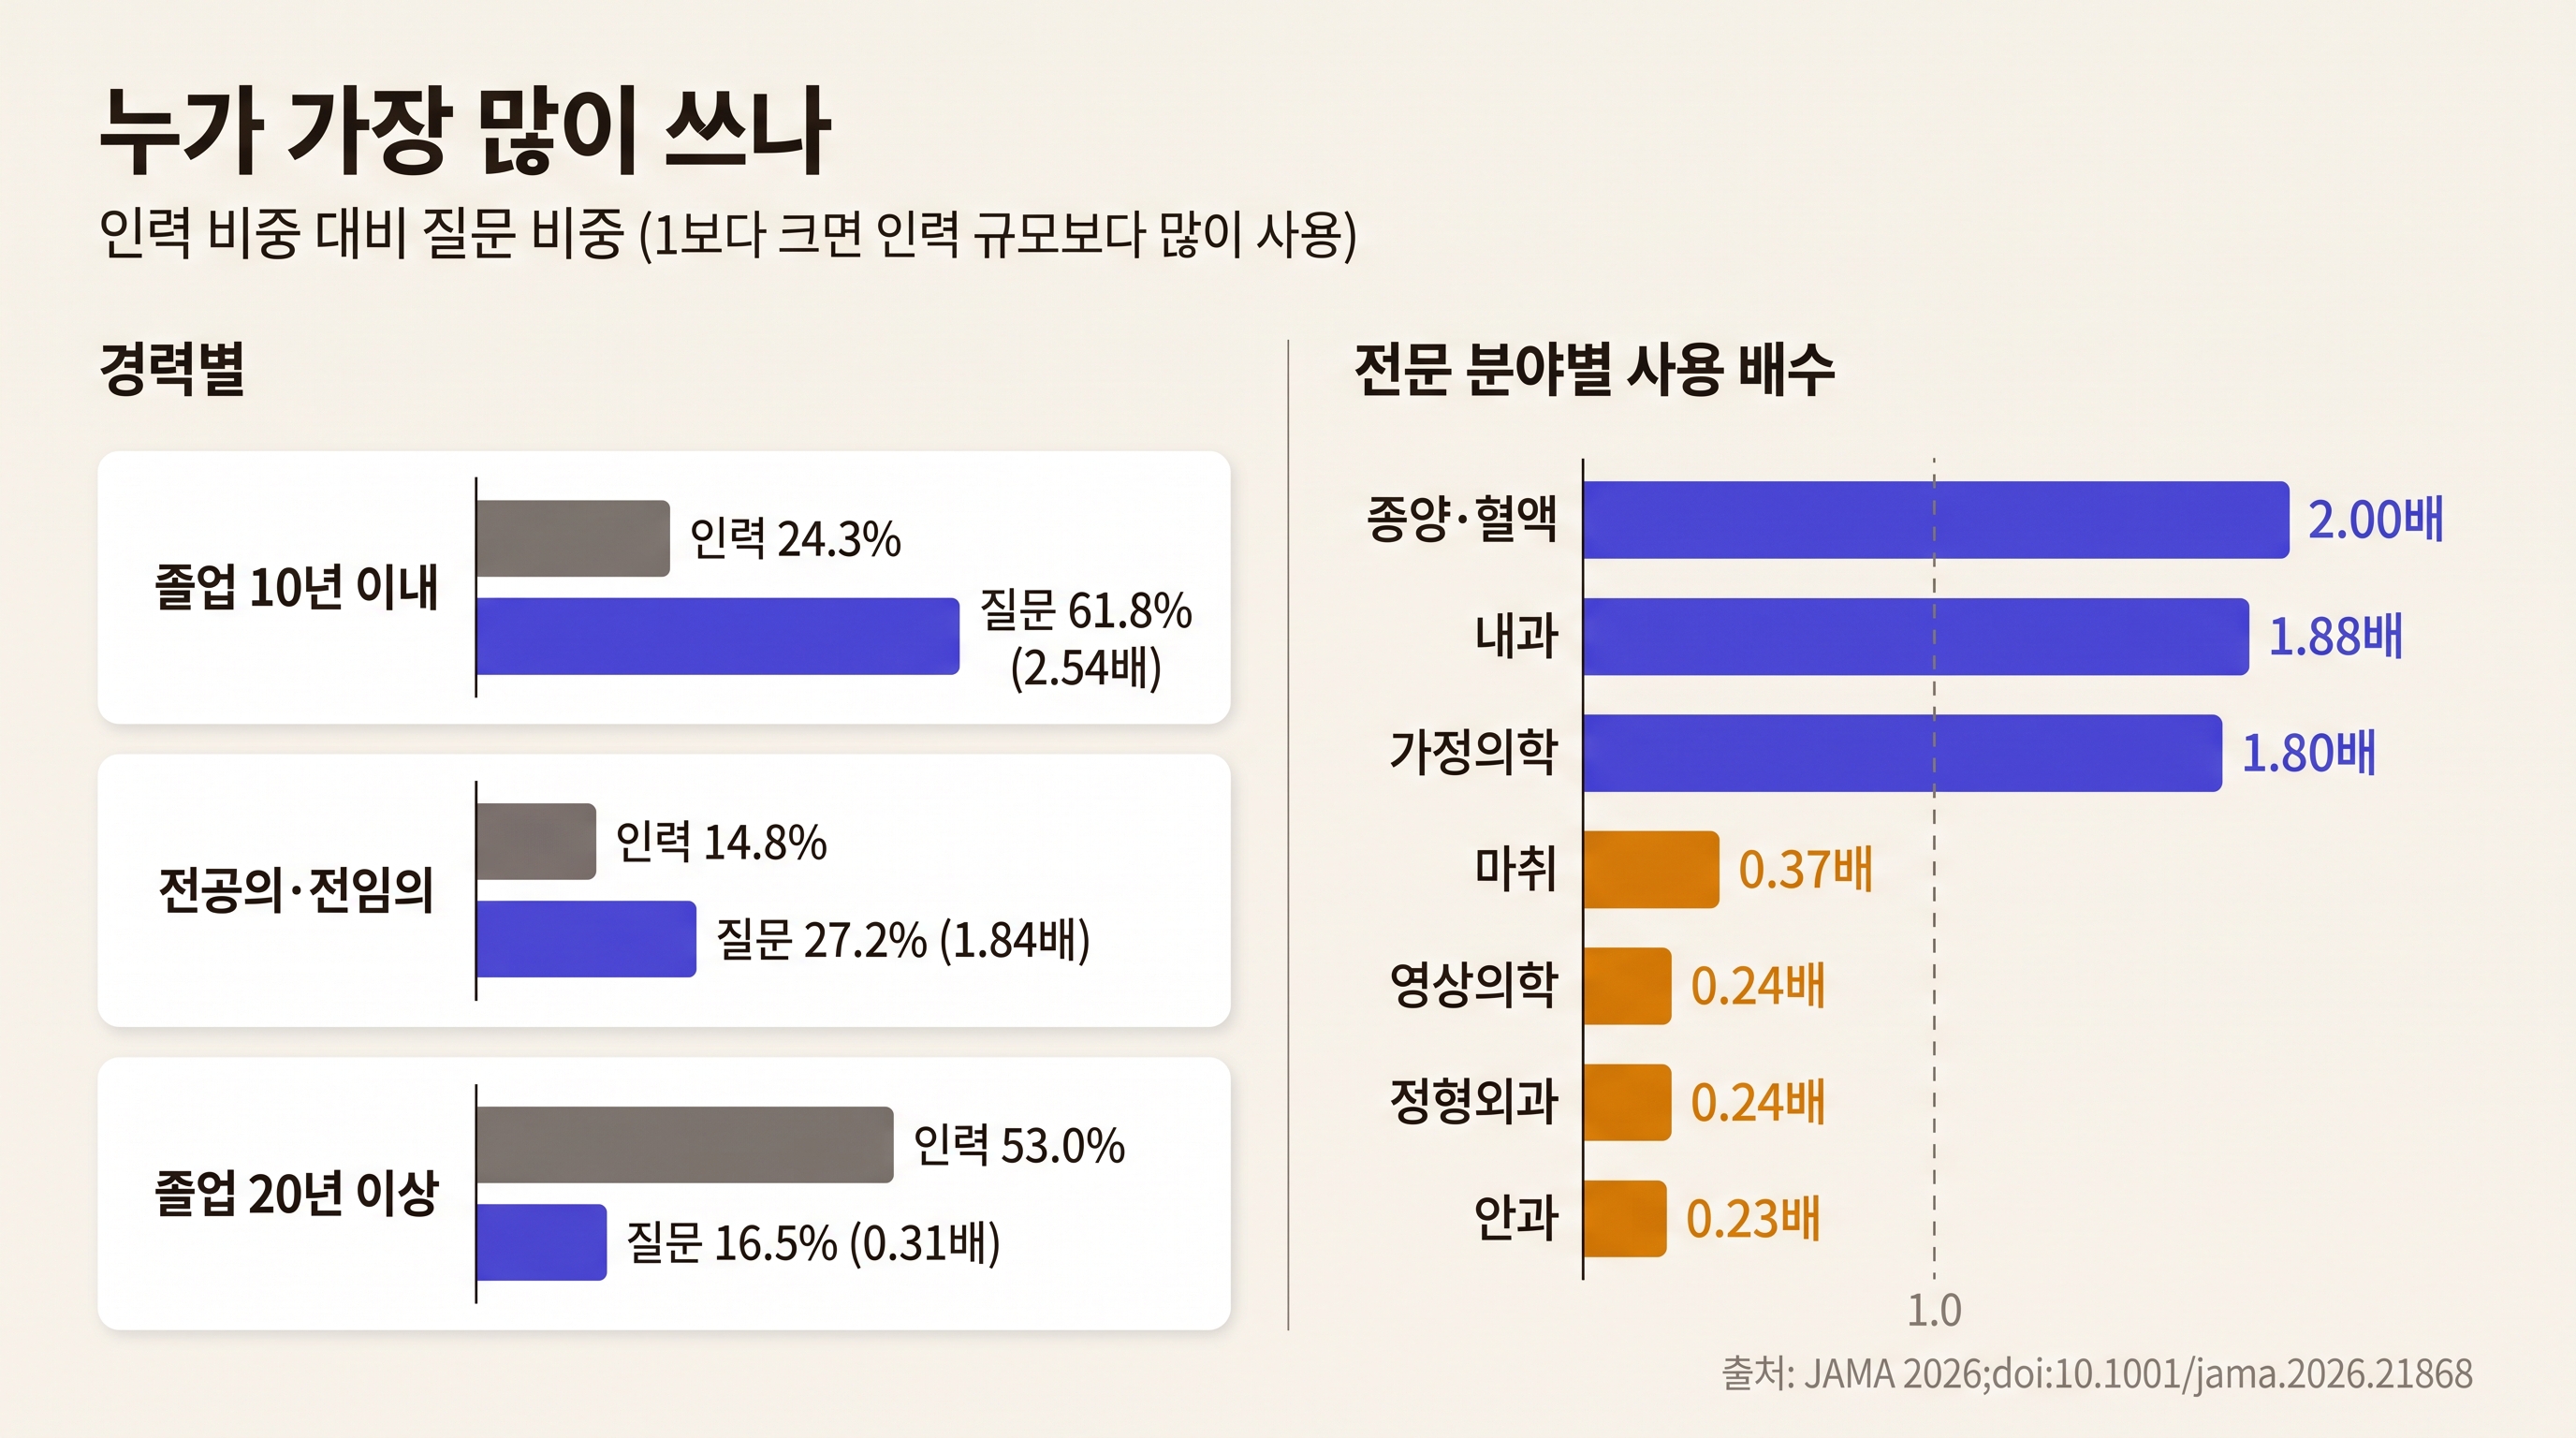
연구진은 의사 집단별로 질문 점유율을 인력 점유율로 나눈 배수를 계산했다. 1보다 크면 인력 규모에 비해 많이 쓴다는 뜻이다.
졸업 10년 이내 의사는 미국 의사 인력의 24.3%인데, 사용자의 45.2%, 질문의 61.8%를 차지했다. 비율로 2.54배다. 전공의와 전임의는 인력의 14.8%로 질문의 27.2%를 던졌다(1.84배). 반대로 졸업 20년 이상 의사는 인력의 절반이 넘는 53.0%인데 질문은 16.5%에 그쳤다(0.31배). 사용자 한 명당 월 질문 수도 경력 10년 미만이 43.4건, 20년 이상이 29.9건이었다.
이 차이를 "젊은 의사는 AI에 익숙하다"로만 읽으면 절반만 본 셈이다. 수련 중이거나 갓 독립한 의사는 처음 보는 상황을 더 자주 만나고, 확인할 것도 더 많다. 경력이 쌓이면 같은 질문에 대한 답이 머릿속에 있다. 실제로 경력 많은 의사의 질문은 성격이 달랐다. 문헌 검색(5.1% 대 2.9%)과 위험·예후 질문(3.9% 대 2.4%) 비중이 더 높았다. 답을 물어보기보다는 근거를 찾아보는 쪽에 가깝다.
전문 분야별로는 종양·혈액내과(2.00배), 내과(1.88배), 가정의학과(1.80배)가 많이 썼다. 마취과(0.37배), 영상의학과(0.24배), 정형외과(0.24배), 안과(0.23배)는 적게 썼다. 사용자당 월 질문 수도 가정의학과 51.7건, 종양·혈액 49.7건인 반면 안과 19.9건, 정형외과 18.5건이었다.
갈림길은 꽤 선명하다. 약물 조합과 진료지침이 복잡하고 다른 분야 질환을 함께 다뤄야 하는 비시술 과는 많이 쓰고, 손기술과 영상 판독이 중심인 시술 과는 덜 쓴다. 텍스트로 묻고 텍스트로 답하는 도구의 성격이 그대로 드러난다. 의료 AI라고 하면 영상 판독 AI를 먼저 떠올리기 쉬운데, 정작 영상의학과 의사들은 이 도구를 가장 덜 쓰는 축에 들었다.
진단보다 치료를 물었다
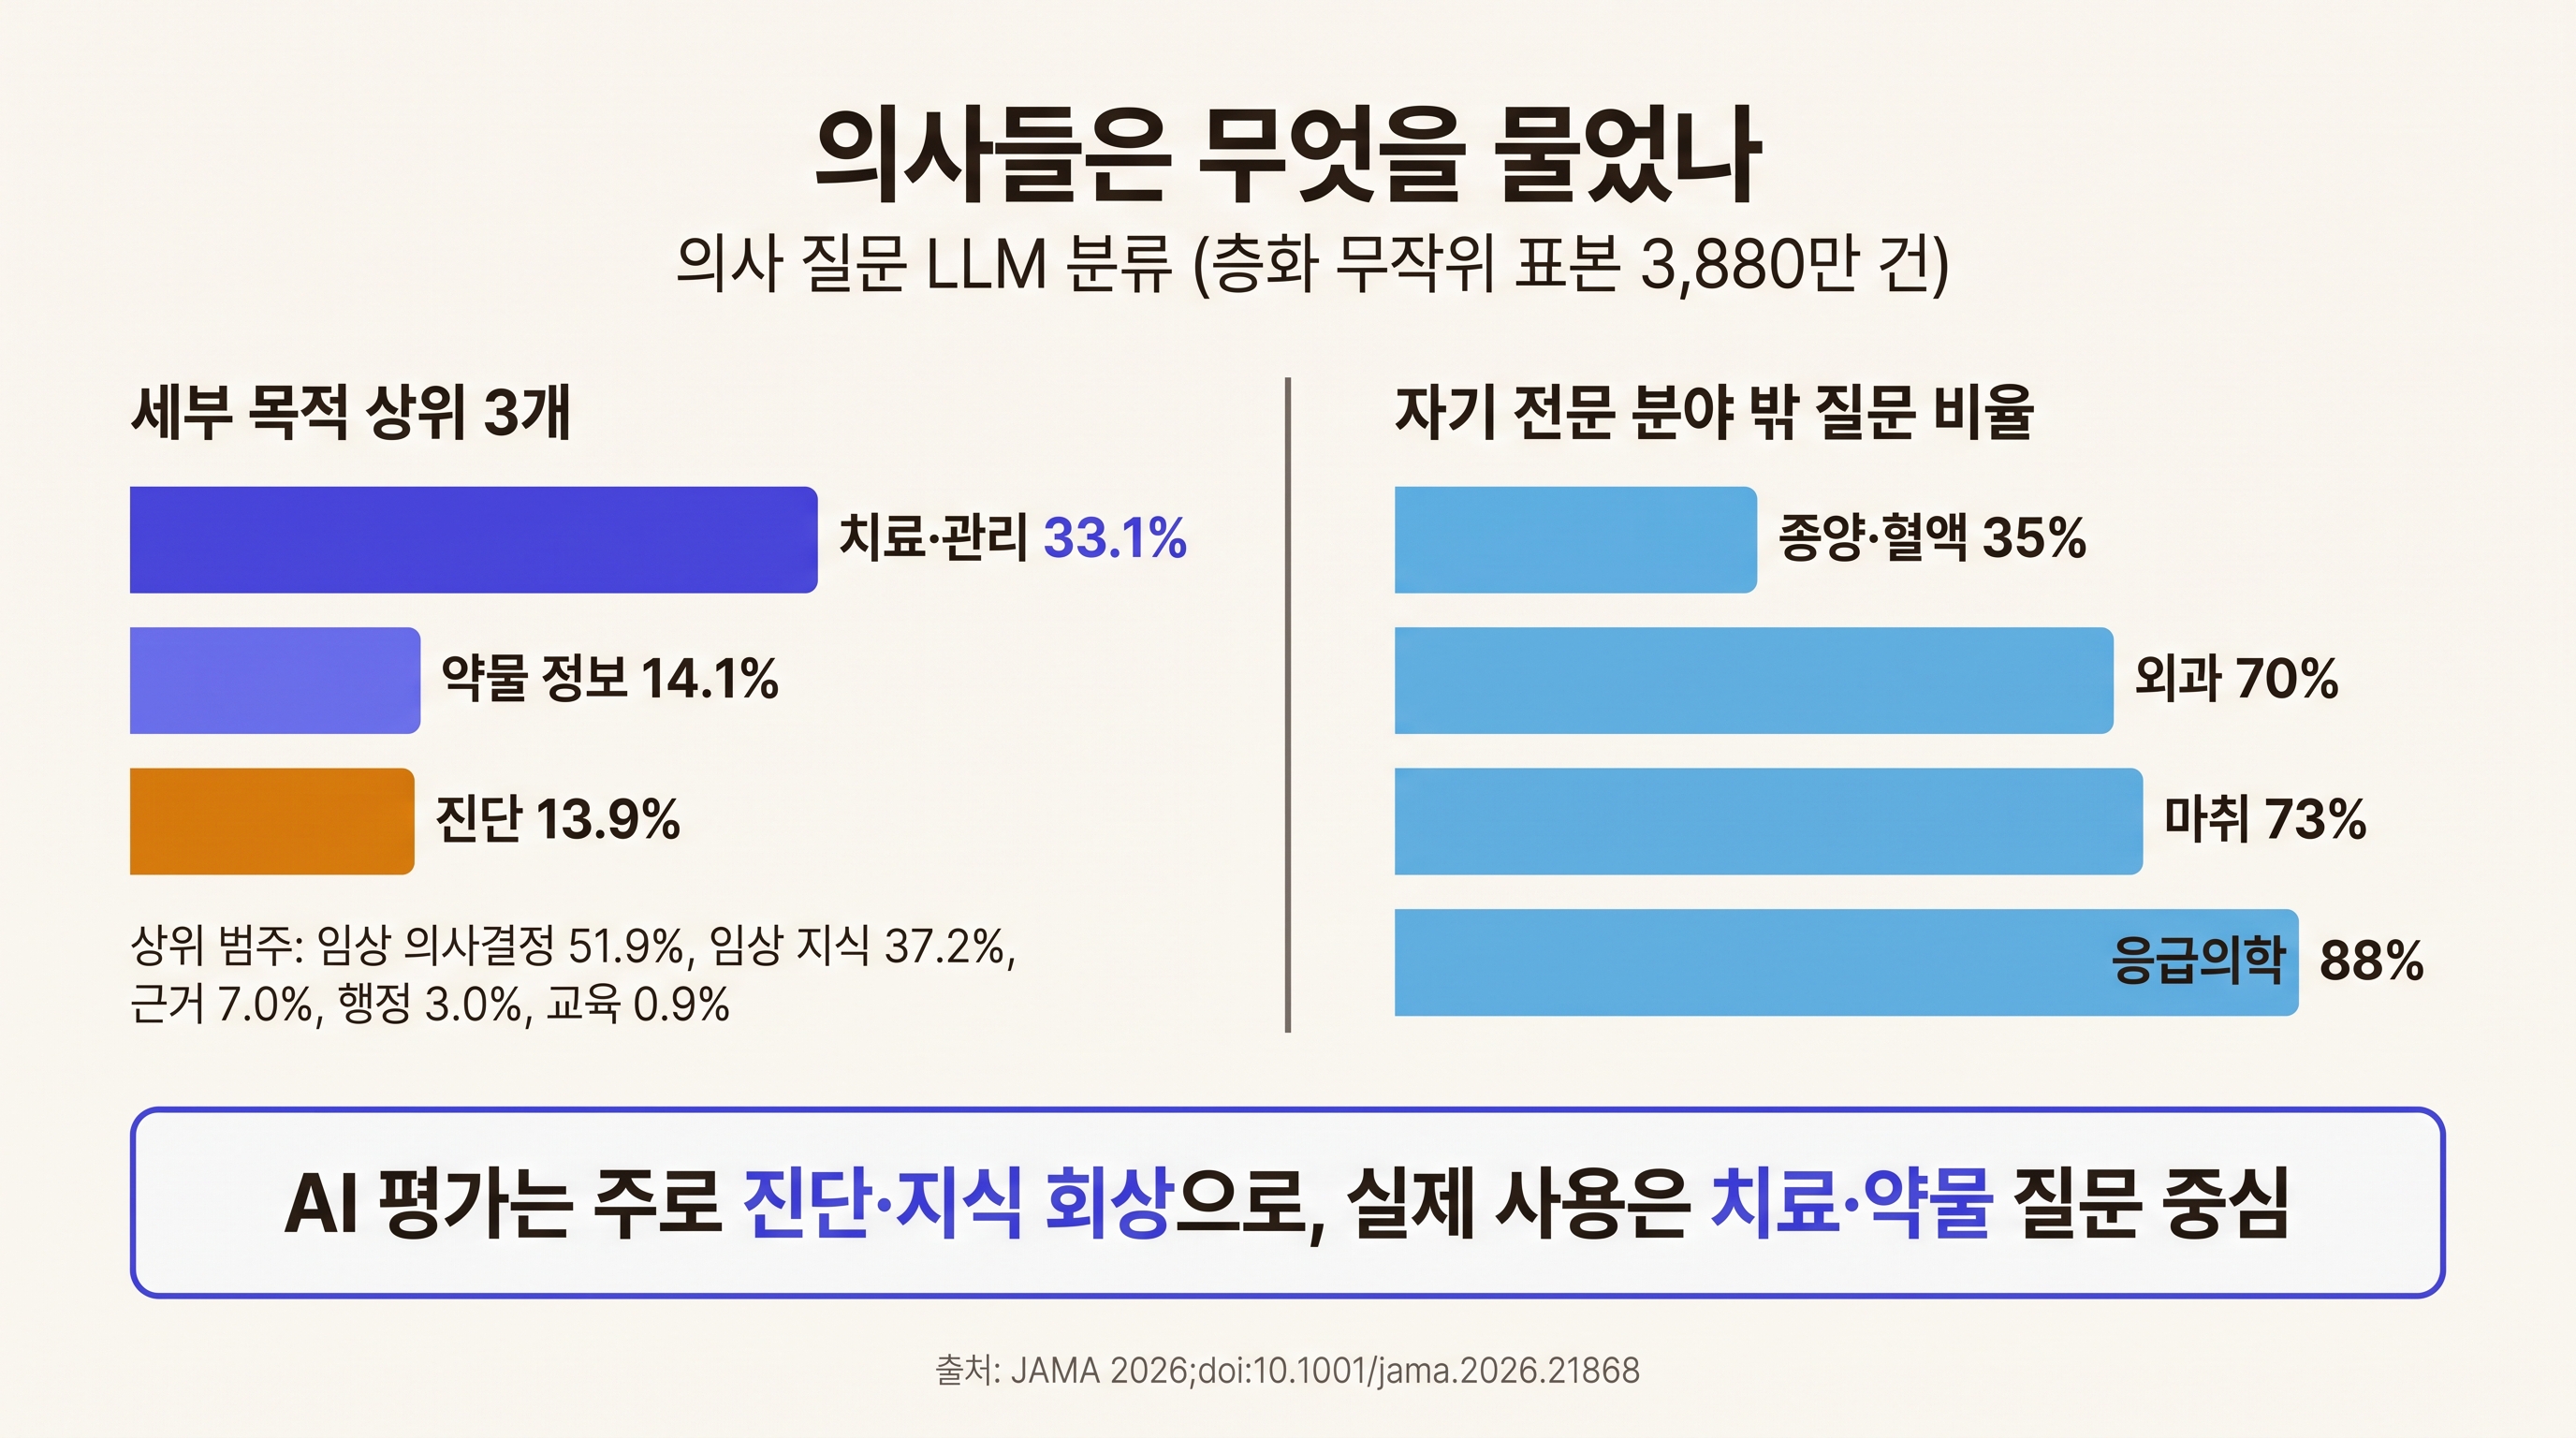
의사들은 무엇을 물었을까. 연구진은 전체 질문을 모두 읽을 수 없어서, 층화 무작위로 14.4%(3,880만 건)를 뽑아 LLM으로 분류했다. 층화 무작위란 직군·시기 같은 집단별로 고르게 표본을 뽑는 방법이다.
의사 질문의 목적은 임상 의사결정이 51.9%, 임상 지식이 37.2%였다. 근거 확인은 7.0%, 행정 업무는 3.0%, 교육은 0.9%에 불과했다. 세부 항목으로 보면 치료·관리가 33.1%로 가장 많았고 약물 정보 14.1%, 진단 13.9% 순이었다. 약사는 약물 정보(32.8%)와 치료·관리(32.0%)에 질문이 몰렸다. 주제는 심장(8.6%), 감염(7.5%), 종양·혈액(7.4%)이 상위였다.
또 하나 눈에 띄는 결과는 자기 전문 분야 밖 질문이다. 종양·혈액내과 의사도 질문의 35%는 종양 밖 주제였고, 응급의학과는 88%가 응급의학 밖 주제였다. 외과 의사의 70%, 마취과 의사의 73%가 자기 분야가 아닌 내용을 물었다. 자기 분야 안에서는 근거 확인 질문이 많았고(9.1% 대 6.4%), 밖에서는 기본 임상 지식을 묻는 비중이 컸다(36.8% 대 28.0%). 외과 의사가 수술 후 환자의 당뇨약을 조정할 때, 응급실 의사가 드문 약물 상호작용을 확인할 때 꺼내 드는 도구라는 그림이 그려진다.
이 결과는 의료 AI를 평가하는 방식과 어긋난다. 지금까지 의료 LLM 성능을 보여준 연구는 대부분 진단 맞히기나 의사국가시험 같은 지식 회상 문제를 썼다. 지난주 다룬 구글 AMIE의 Lancet 연구도 감별진단 정확도가 핵심 지표였다. 저자들도 결론에서 실제 사용 패턴이 대부분의 AI 평가 과제와 다르다고 짚었다.
시험은 진단으로 보는데 현장에서는 치료와 약물을 묻는 셈이다. "의사국가시험 몇 점" 같은 성적표가 이 도구의 실제 일을 대변하기 어려운 이유다. 치료 권고는 진단보다 정답이 하나로 정해지지 않는 경우가 많고, 환자 상태·약물 상호작용·보험 조건에 따라 달라진다. 그만큼 평가하기도 어렵다.
사용 기록만으로는 알 수 없는 것
논문이 보여주지 않은 것도 보여준 것만큼 중요하다.
답이 맞았는지 모른다. 연구는 답변의 질과 정확도를 평가하지 않았다. 의사들이 그 답을 어떻게 받아들였는지, 환자 진료가 바뀌었는지도 확인하지 않았다. JAMA 편집진은 같은 날 실은 편집자 노트("Engaging With Medical Evidence in the Age of AI")에서 이 한계를 정면으로 적었다. 많이 쓴다는 사실이 환자에게 이득이라는 증거는 아니라는 것이다. 편집진은 인용이 달려 있다고 해서 답변이 검증되는 것은 아니며, 인용된 근거를 제대로 해석했는지도 보장하지 않는다고 덧붙였다.
진료 중에 썼는지 모른다. 환자를 앞에 두고 물었는지, 진료 전 차트를 준비하며 물었는지, 공부하려고 물었는지 기록만으로는 가를 수 없다. 기존에 쓰던 교과서나 다른 검색 도구를 대신한 것인지, 새로운 수요가 생긴 것인지도 알 수 없다.
회사 데이터, 회사 공저자. 공저자 7명 중 3명이 OpenEvidence 소속이다. 그중 한 명은 최고의료책임자(CMO)다. 데이터를 회사가 제공했고 분석에도 참여했다. 그렇다고 숫자를 의심할 이유가 바로 생기지는 않는다. 사용 로그는 회사만 가진 데이터이고, 하버드·NYU 연구자가 함께 이름을 올렸다. 다만 독자는 이 연구가 독립 평가가 아니라 회사 데이터 공개에 가깝다는 점을 알고 읽어야 한다. 또 하나, 편집자 노트 말미에는 JAMA Network가 OpenEvidence에 저널 콘텐츠를 라이선스하고 있다는 고지가 붙어 있다. 편집진은 모든 논문이 독립된 편집·동료심사를 거친다고 밝혔다.
분류도 AI가 했다. 연구진은 임상의 6명이 맹검으로 200건을 따로 분류해 비교했다. 질문 목적에서 모델과 임상의의 일치율은 73.6%로, 임상의끼리의 일치율 66.3%보다 높았다. 주제 분류는 54.5% 대 52.8%였다. 사람끼리도 셋 중 하나는 의견이 갈릴 만큼 경계가 모호한 분류라는 뜻이다. "치료 33.1%, 진단 13.9%"는 큰 그림으로 읽고, 소수점 차이에 의미를 두지 않는 편이 안전하다.
한 플랫폼의 이야기다. 의료인의 AI 사용 전체를 대표하지 않는다. 의사가 아닌 직군은 등록부에 비활동 인력이 섞여 있어 인력 대비 비율도 계산하지 못했다.
FDA 허가 기록 없이 95만 명이 쓰는 구조
치료 결정을 돕는 AI를 한 달에 70만 명이 쓴다면 FDA 허가는 받았을까. openFDA에서 OpenEvidence를 신청자나 기기명으로 검색하면 510(k), PMA, 업체 등록·제품 리스팅 어디에서도 결과가 나오지 않는다(2026년 10월 19일 조회). De Novo는 openFDA가 조회 창구를 제공하지 않아 같은 방식으로 확인하지 못했다.
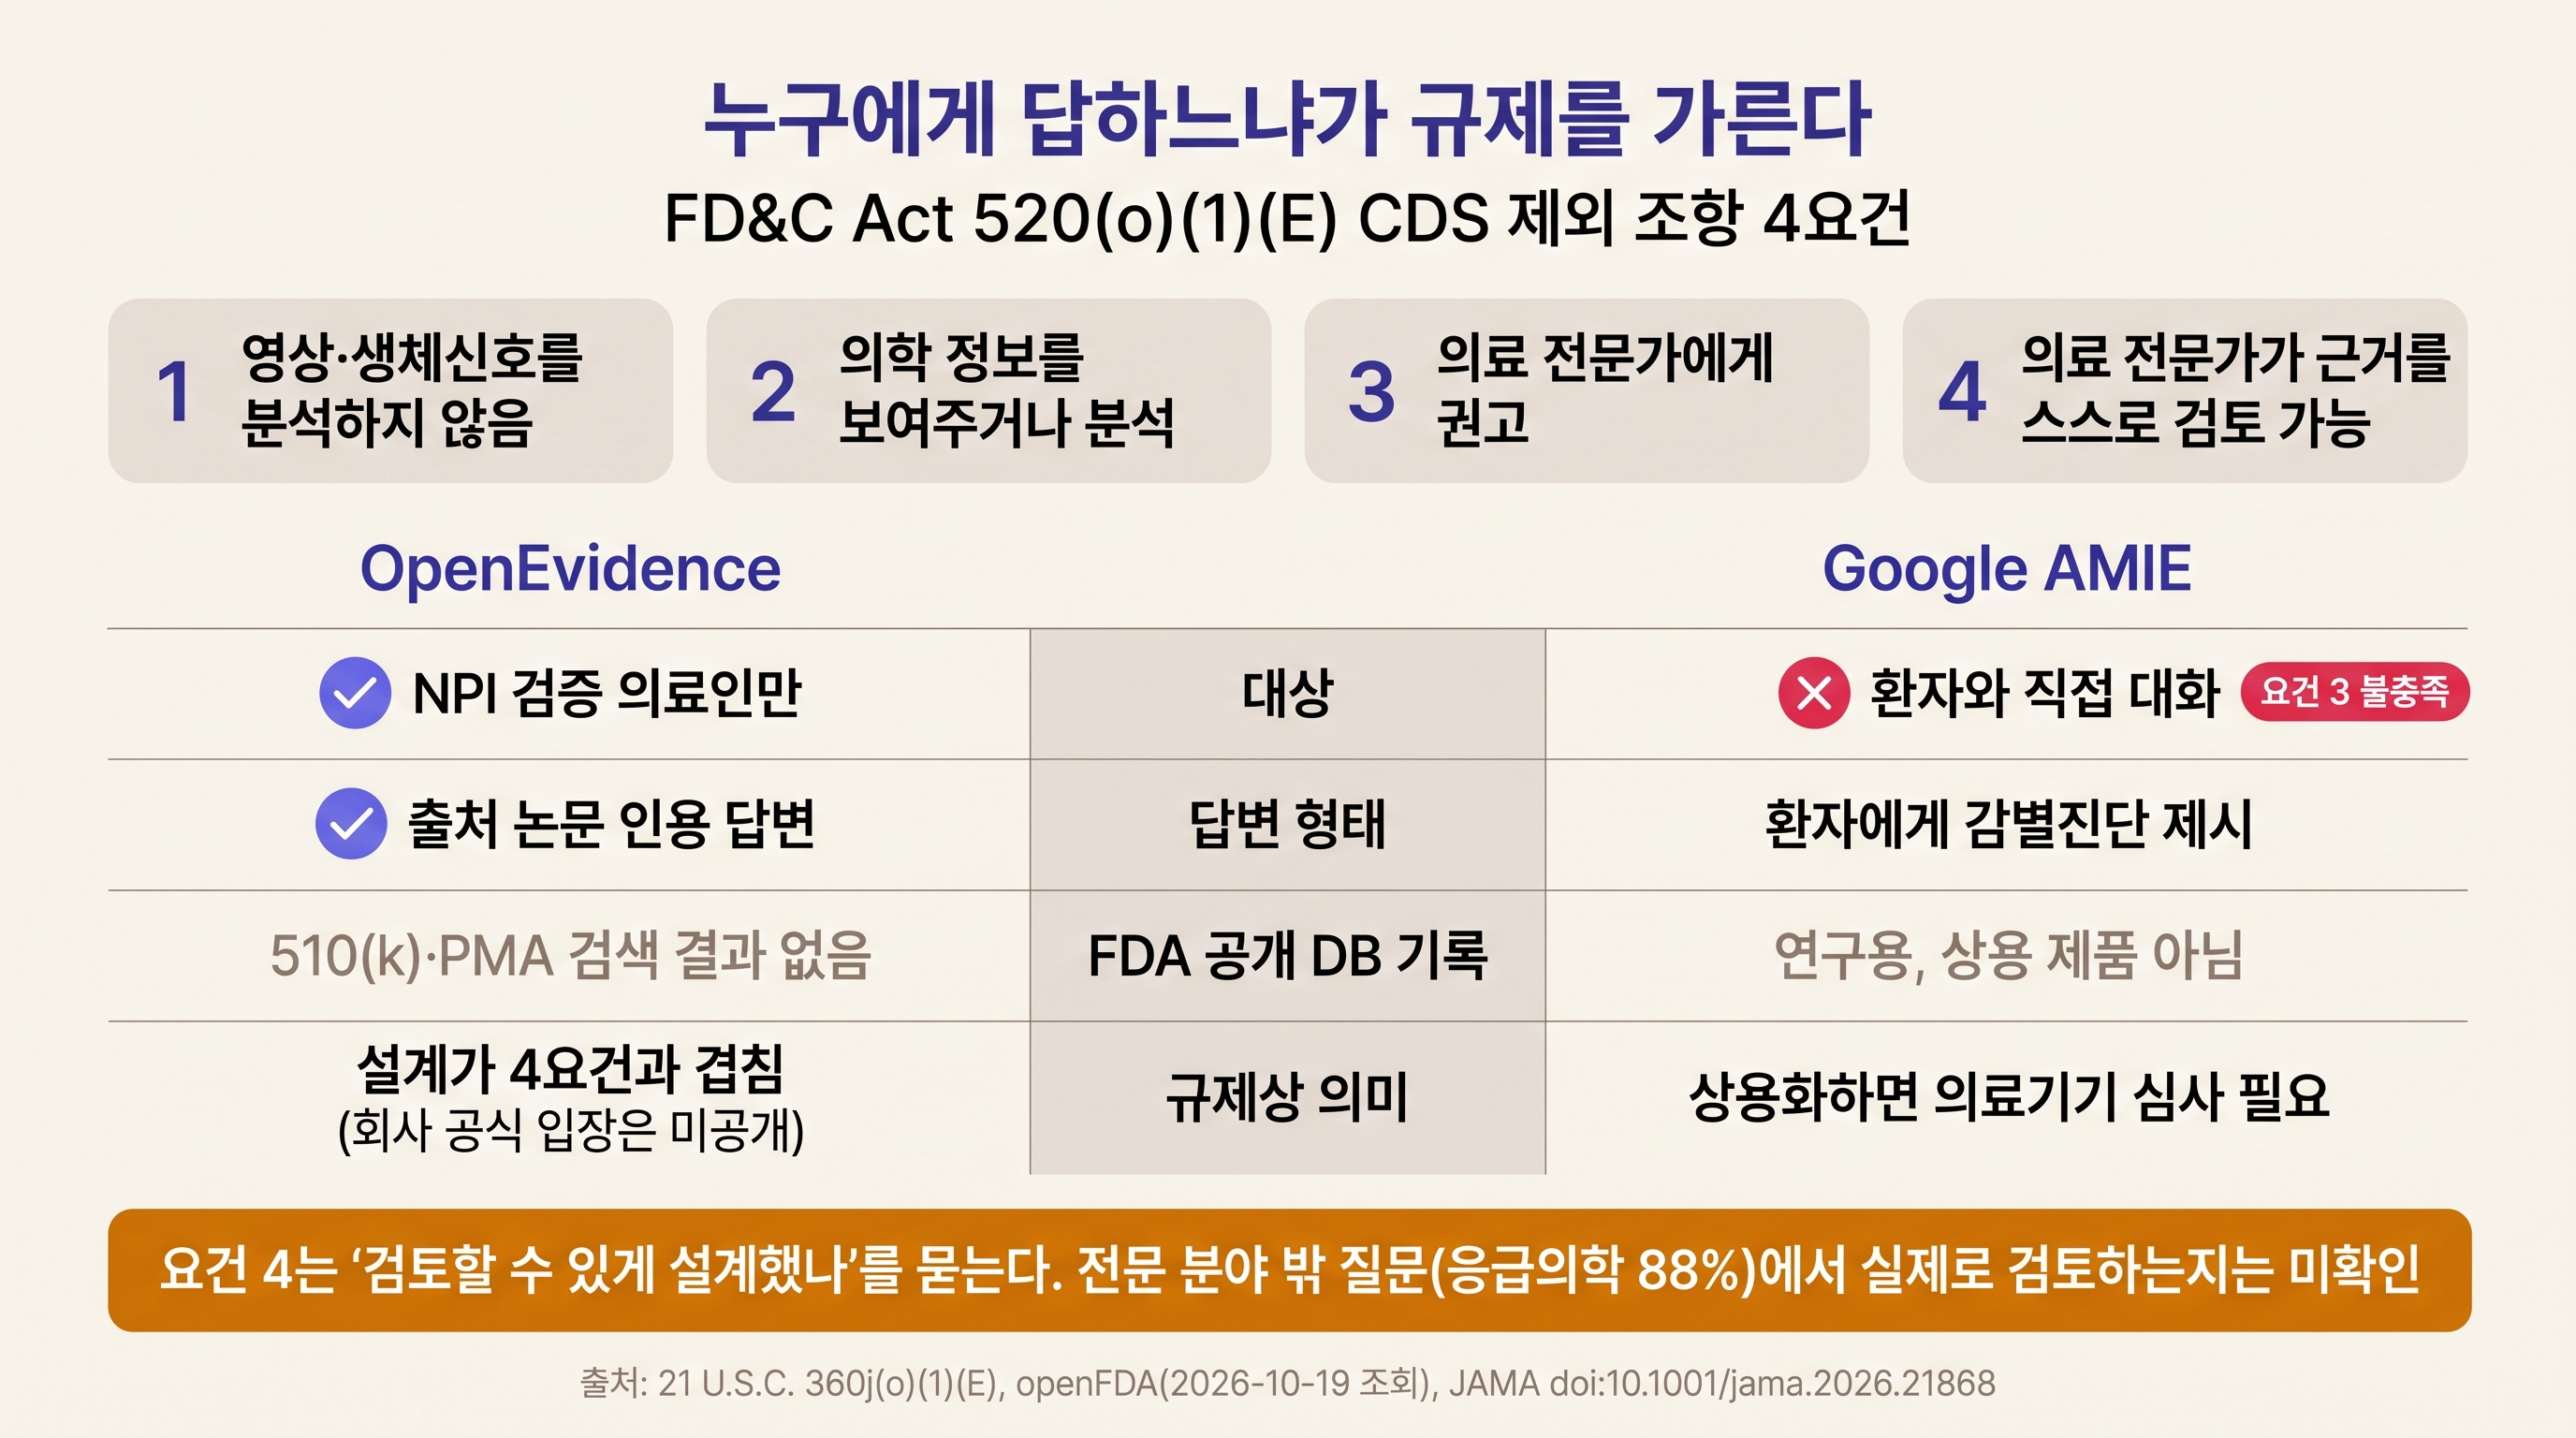
이 상황을 이해하려면 미국 연방 식품의약품화장품법(FD&C Act) 520(o)(1)(E), 이른바 CDS 제외 조항을 알아야 한다. 2016년 21세기 치료법(21st Century Cures Act)으로 들어온 이 조항은, 임상의사결정지원(CDS) 소프트웨어가 네 가지 요건을 모두 갖추면 의료기기로 보지 않는다. 요건은 이렇다.
- 의료 영상이나 생체 신호를 분석하지 않는다.
- 환자 정보나 의학 지식(논문, 진료지침 등)을 보여주거나 분석한다.
- 의료 전문가에게 예방·진단·치료에 관한 권고를 제공한다.
- 의료 전문가가 권고의 근거를 스스로 검토할 수 있어서, 그 권고에 주로 의존하지 않도록 설계돼 있다.
FDA는 2026년 1월 CDS 가이던스를 개정하면서, 임상적으로 적절한 선택지가 하나뿐인 경우에는 단일 권고를 내놓는 소프트웨어도 다른 요건을 충족하면 집행재량(규제 권한은 있지만 당분간 행사하지 않겠다는 방침)을 적용한다고 밝혔다.
텍스트 질문에 답하고, 의료인만 쓰며, 답마다 출처 논문을 달아 의사가 직접 확인할 수 있게 한 OpenEvidence의 설계는 네 요건과 잘 맞물린다. 회사가 자사 규제 지위를 어떻게 판단했는지 공개한 자료는 찾지 못했다. 다만 영상을 읽지 않고, 의료인만 받고, 근거를 노출하는 구조가 허가 없이 시장에 나올 수 있는 길과 겹친다는 점은 분명하다.
지난주 다룬 구글 AMIE와 비교하면 차이가 선명하다. AMIE는 환자와 직접 대화하고 환자에게 감별진단을 보여준다. 3번 요건(의료 전문가 대상)을 충족할 수 없어서 상용화하려면 의료기기 심사를 거쳐야 한다. OpenEvidence는 같은 LLM 기술을 쓰면서도 상대를 의사로 한정해 그 문턱을 피했다. 같은 기술이라도 누구에게 답하느냐가 규제 경로를 가른다.
JAMA 논문의 결과는 4번 요건, 즉 의사가 근거를 독립적으로 검토할 수 있어야 한다는 요건에 질문을 던진다. 질문의 상당수가 자기 전문 분야 밖이었기 때문이다. 응급의학과 의사가 던진 질문의 88%가 응급의학 밖 주제였다. 자기 분야 밖의 논문 인용을 받아 들고 그 해석이 맞는지 판단하기는, 자기 분야일 때보다 확실히 어렵다. 경력이 짧을수록 더 그렇다. 편집진이 자동화 편향(기계가 내놓은 답을 과하게 믿는 경향)과 수련의의 비판적 평가 능력 저하를 우려한 이유가 여기 있다. 규제 요건은 "검토할 수 있게 설계했느냐"를 묻지만, 실제로 "검토하고 있느냐"는 이번 연구가 답하지 못한 질문이다.
사용량이 곧 사업 모델
사업 쪽에서 보면 이번 논문은 OpenEvidence가 쥔 자산의 크기를 공식 학술지 지면에 올린 셈이다. 이 서비스는 의료인에게 돈을 받지 않는다. MedCity News(2026년 2월) 보도에 따르면 회사는 플랫폼 광고를 제약사에 팔아 돈을 번다. 의사가 치료 결정을 고민하는 바로 그 순간의 관심이 상품인 구조다. 그러니 월 70만 명, 유지율 90%, 질문의 절반이 의사결정이라는 숫자는 광고주에게 그대로 매력이 된다. 회사는 2026년 1월 2억 5,000만 달러를 투자받으며 기업가치 120억 달러를 인정받았다(Axios, Crunchbase 보도).
치료 질문이 많다는 결과는 사업적으로는 강점이지만 규제·윤리 측면에서는 부담이다. 치료와 약물 선택을 묻는 화면에 제약 광고가 함께 놓이는 구조라면, 답변과 광고가 섞이지 않는다는 것을 외부에서 확인할 장치가 필요하다. 이번 논문은 광고 문제를 다루지 않았다.
이번 JAMA 논문으로 의료 LLM이 미국 의료 현장의 일상 도구가 됐다는 사실은 2억 7,100만 건이라는 기록으로 남았다. 그 기록이 가리키는 다음 과제도 꽤 구체적이다. 진단 퀴즈가 아니라 치료·약물 질문에서 답이 맞는지, 자기 분야 밖을 묻는 응급의학과 의사와 수련 중인 전공의가 인용된 근거를 실제로 검토하는지를 재야 한다. 앞의 것은 이 도구의 품질을, 뒤의 것은 CDS 제외 조항 4번 요건이 현실에서 작동하는지를 가린다. 이번 논문은 두 질문 모두에 답하지 않았고, JAMA 편집진이 요구한 것도 바로 그 독립 검증이다.
출처
- Patel VR, Finlayson SG, Liu-Hass M, Ray M, Burk-Rafel J, Zack TI, Jena AB. "Clinician Use of an Artificial Intelligence–Enabled Clinical Information Platform." JAMA. Published online 2026-10-15. doi:10.1001/jama.2026.21868. https://jamanetwork.com/journals/jama/fullarticle/2855491
- Khera R, Bibbins-Domingo K, Ross JS. "Engaging With Medical Evidence in the Age of AI." JAMA (Editor's Note). Published online 2026-10-15. doi:10.1001/jama.2026.21894. https://jamanetwork.com/journals/jama/fullarticle/2855492
- 21 U.S.C. 360j(o)(1)(E) (FD&C Act 520(o)(1)(E)). https://www.law.cornell.edu/uscode/text/21/360j
- Covington, "5 Key Takeaways from FDA's Revised Clinical Decision Support (CDS) Software Guidance," 2026-01. https://www.cov.com/en/news-and-insights/insights/2026/01/5-key-takeaways-from-fdas-revised-clinical-decision-support-cds-software-guidance
- Cooley, "Automation Bias and Clinical Practice: FDA Makes Incremental Updates to Clinical Decision Support Software Guidance," 2026-01-20. https://www.cooley.com/news/insight/2026/2026-01-20-automation-bias-and-clinical-practice-fda-makes-incremental-updates-to-clinical-decision-support-software-guidance
- openFDA 510(k)·PMA·등록/리스팅 API, "OpenEvidence" 검색 결과 0건 (2026-10-19 조회). https://api.fda.gov/device/510k.json?search=applicant:openevidence , https://api.fda.gov/device/pma.json?search=applicant:openevidence , https://api.fda.gov/device/registrationlisting.json?search=registration.name:openevidence
- Axios Pro, "OpenEvidence raises $250M at $12B valuation," 2026-01-21. https://www.axios.com/pro/health-tech-deals/2026/01/21/openevidence-250m-round-12b
- Crunchbase News, OpenEvidence Series D. https://news.crunchbase.com/venture/openevidence-ai-doctors-doubles-valuation-seriesd/
- MedCity News, "Thunderstruck By OpenEvidence's $12B Valuation? Don't Be.", 2026-02-08. https://medcitynews.com/2026/02/openevidence-healthcare-valuation/