9월 17일, PrismML이라는 회사가 Ternary Bonsai 2 27B를 내놨습니다. 새로 학습한 모델은 아닙니다. 알리바바가 공개한 Qwen3.8 27B를 가져다 용량만 줄인 물건입니다. 줄인 결과가 5.9GB입니다.
모델 소식에서 파일 크기가 헤드라인이 되는 경우는 드뭅니다. 보통은 점수가 앞에 옵니다. 그런데 이번에는 크기가 먼저 나와야 이야기가 됩니다. 계산이 맞지 않는 숫자이기 때문입니다.
5.9GB가 이상한 숫자인 이유
모델 파일의 크기는 계산으로 나옵니다. 파라미터 하나당 몇 비트를 쓰는지 알면 곱셈이면 됩니다.
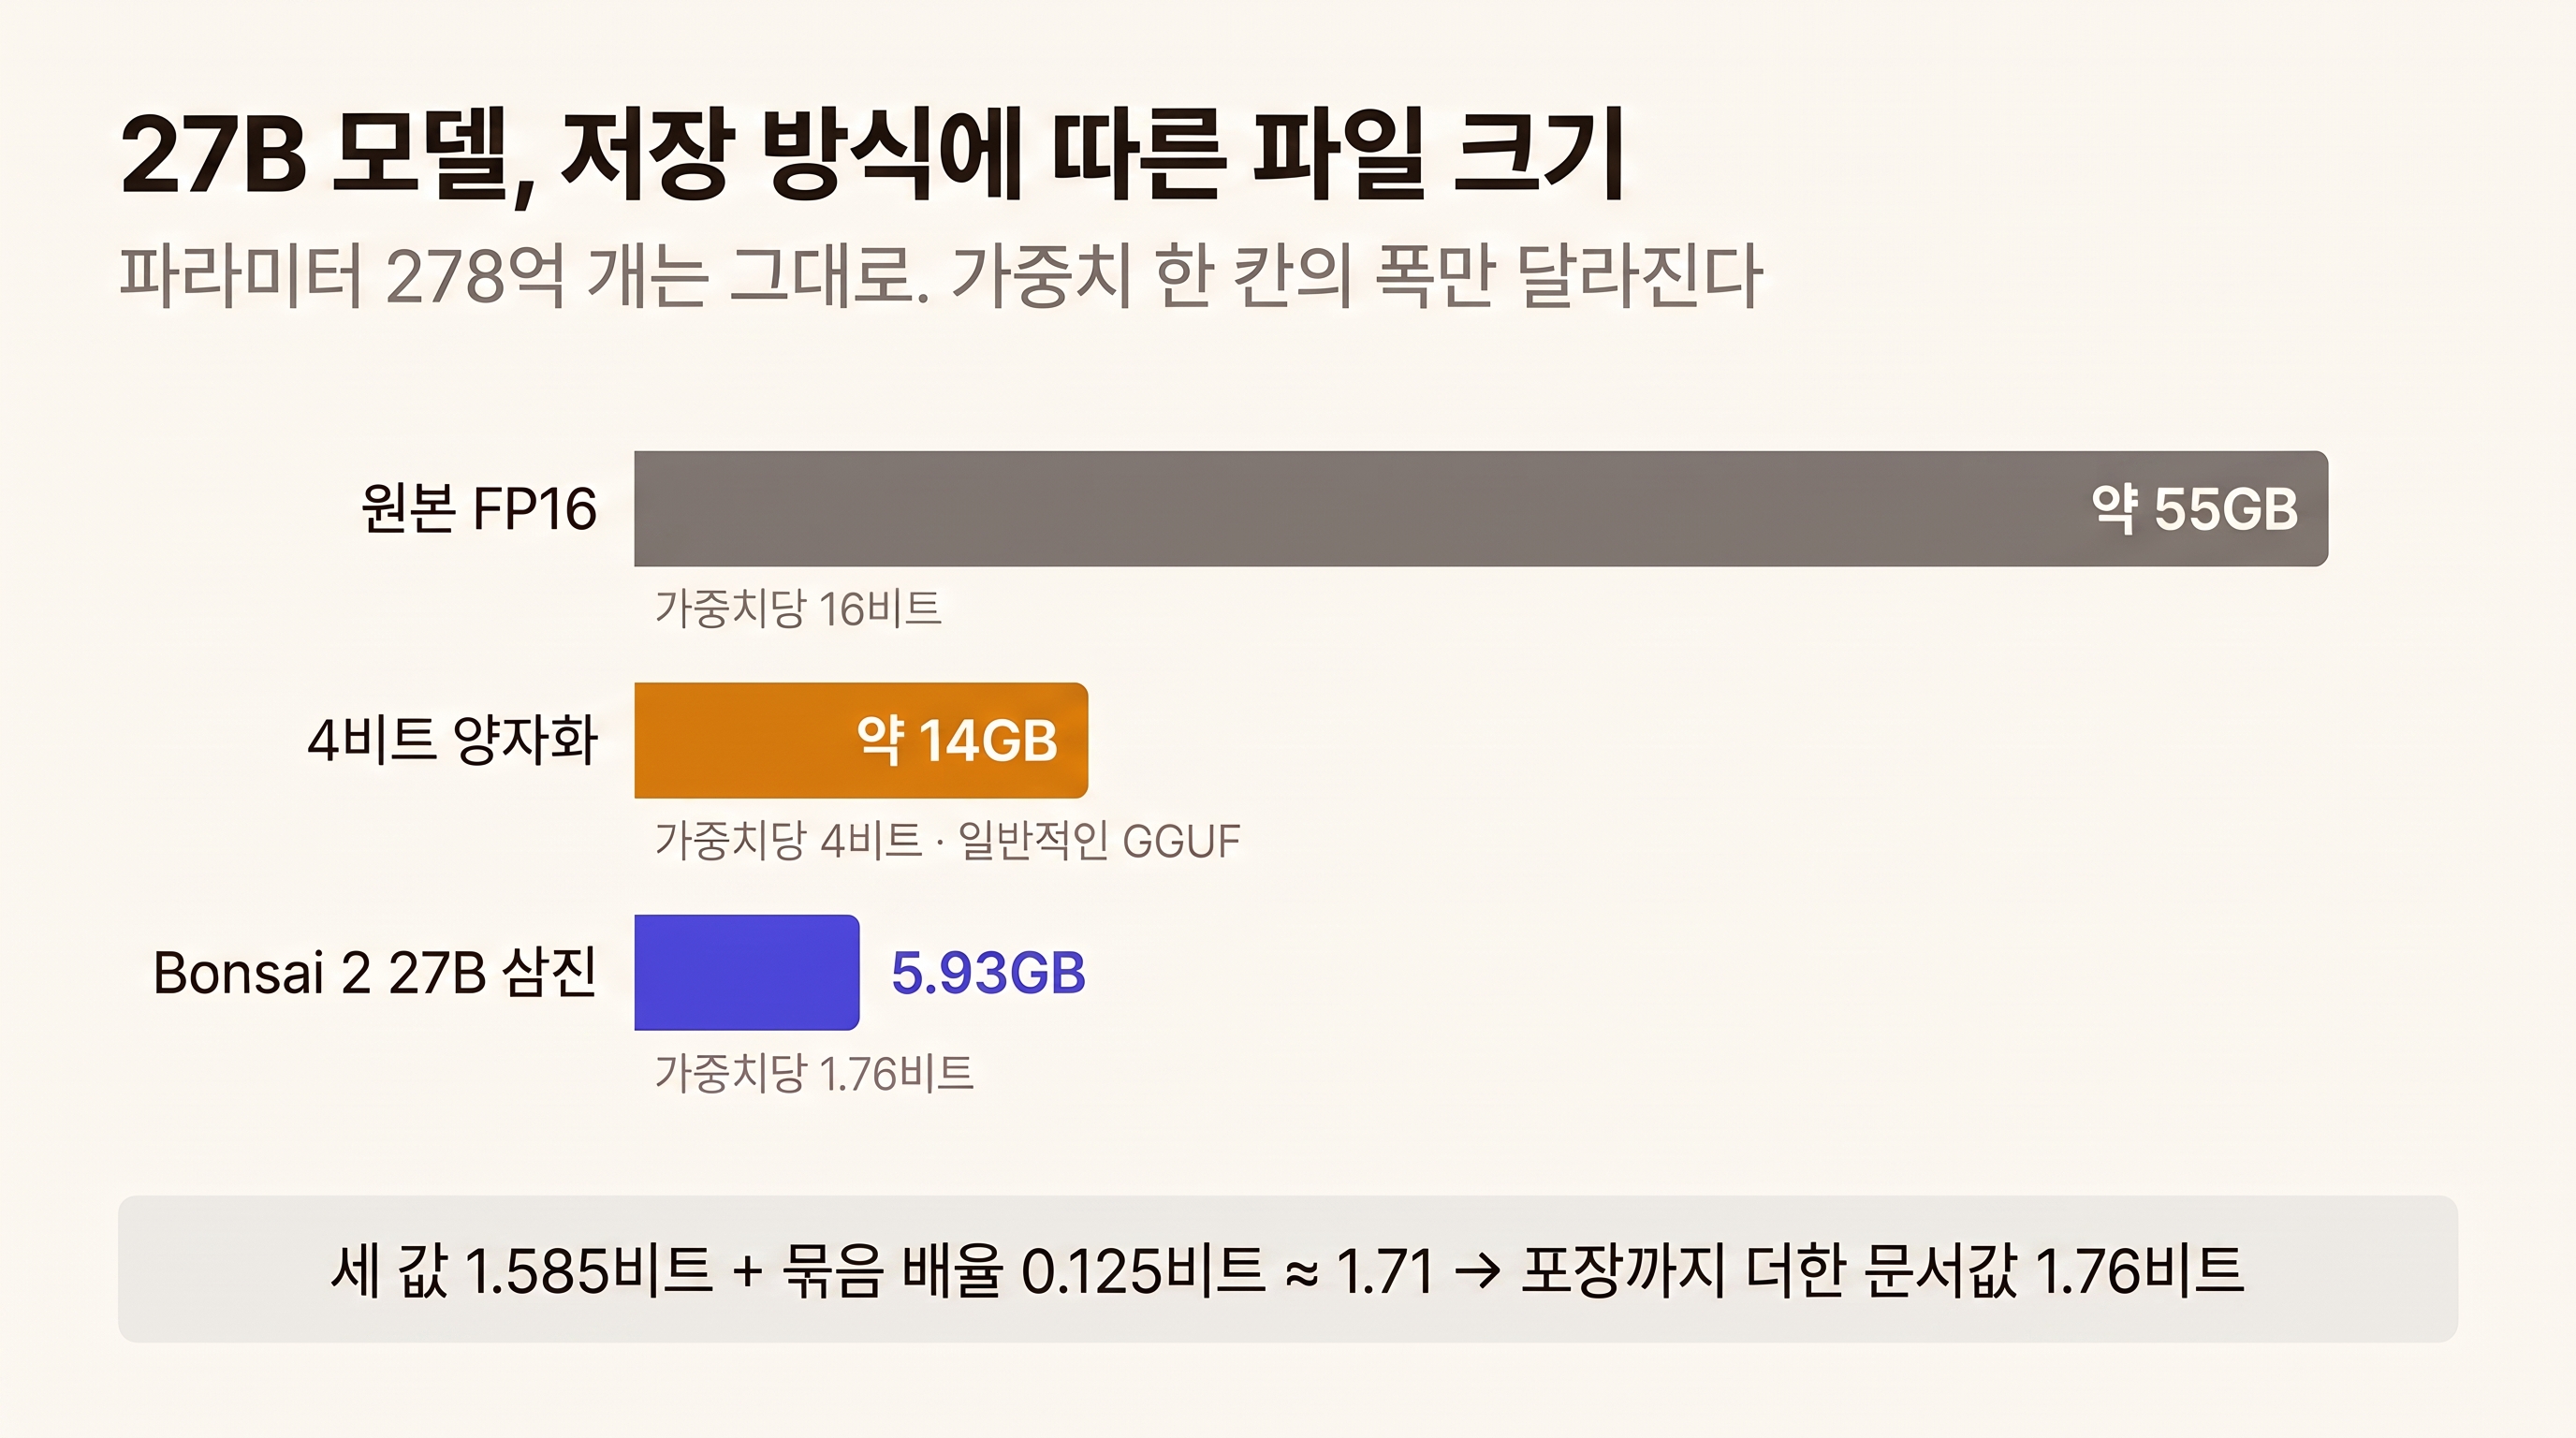
Qwen3.8 27B는 파라미터가 278억 개입니다. 원본은 가중치 하나를 16비트, 그러니까 2바이트로 저장합니다. 278억 곱하기 2바이트, 약 55GB가 나옵니다. 개인 장비로는 손댈 수 없는 크기입니다. 메모리 80GB짜리 데이터센터 GPU에나 통째로 올라갑니다.
그래서 보통은 압축을 합니다. 가중치를 4비트로 낮추면 파일이 4분의 1로 줄어 14GB 근처가 됩니다. 요즘 개인 PC에서 오픈모델을 돌릴 때 받는 파일이 대개 이 언저리입니다. Ollama나 LM Studio에서 내려받는 GGUF 파일도 여기 해당합니다. 그래픽카드 메모리 16GB짜리에 겨우 들어가는, 취미로 돌려볼 수 있는 하한선쯤 되겠습니다.
Bonsai 2 27B는 5.93GB입니다. 4비트로 줄인 것보다도 절반 이하입니다. PrismML 문서가 밝힌 값이 가중치당 1.76비트입니다.
1비트는 0 아니면 1, 두 가지 상태를 적는 단위입니다. 가중치 하나에 두 가지 상태를 적을 자리조차 온전히 주지 않았다는 뜻입니다. 55GB짜리 모델의 파라미터 개수는 그대로 둔 채 각 칸의 폭만 극단적으로 좁혔습니다.
가중치를 세 값으로만 적는다
모델 이름 앞에 붙은 ternary, 삼진이라는 말이 그 방법입니다. Bonsai 2는 모든 가중치를 +1, 0, -1 세 값 중 하나로 바꿔버립니다. 원본에 0.0713이 적혀 있든 -0.2264가 적혀 있든, 반올림해서 셋 중 하나로 만듭니다.
이게 성립하나 싶지만, 정보량으로 따지면 값 세 개는 log₂3, 약 1.585비트입니다. 2비트보다 작습니다.
여기에 배율이 하나 붙습니다. 세 값만 남기면 크기 정보가 사라지니까, 가중치 128개를 한 묶음으로 묶고 그 묶음 전체에 곱할 스케일 값을 16비트로 따로 저장합니다. 128개가 나눠 쓰는 16비트니 가중치당 0.125비트씩 더해집니다. 단순히 더하면 1.71 근처가 나오는데, 문서에 적힌 이론값은 1.72비트이고 실제 GGUF 파일로 포장한 값은 1.76비트입니다. 남는 자투리는 포맷이 값을 묶어 저장하면서 붙는 몫입니다. 어쨌든 1.6과 1.8 사이, 가중치 하나에 2비트도 주지 않는 자리에서 모든 게 벌어집니다.
0을 넣은 게 중요합니다. +1과 -1 둘만 쓰는 이진 압축도 오래된 연구 주제인데, 0이 있으면 "이 가중치는 그냥 끈다"는 선택지가 하나 더 생깁니다. 신경망 가중치는 대부분 0 근처에 몰려 있습니다. 거의 0에 가까운 값을 억지로 +1이나 -1 쪽으로 밀어붙이는 대신 0으로 보내면, 원본과의 거리가 확 줄어듭니다. 세 칸짜리 눈금인데 가운데 칸이 실제 분포의 한복판을 잡아주는 구조입니다.
방향 자체가 새롭지는 않습니다. 마이크로소프트 연구진의 BitNet b1.58이 가중치당 평균 1.58비트를 목표로 삼진 표현을 밀어붙인 작업으로 알려져 있습니다. 다만 그쪽은 처음부터 삼진 제약을 걸어두고 학습하는 방식입니다. Bonsai 2는 반대입니다. 이미 완성된 남의 모델을 나중에 변환합니다. 학습비를 한 푼도 안 쓰는 대신, 원본이 공들여 잡아둔 정밀한 값들을 세 칸 눈금에 욱여넣어야 하는 부담을 떠안습니다.
반올림하기 전에 축을 돌린다
정밀한 값을 세 칸으로 반올림하면 망가지는 게 정상입니다. 그런데도 성능이 상당히 남아 있는 이유는 반올림 순서에 있습니다. 그냥 반올림하지 않고, 좌표를 한 번 돌린 다음 반올림합니다.
왜 그래야 하는지는 이상치 문제를 보면 드러납니다. 가중치를 뭉텅이로 펼쳐 보면 대부분 0 근처에 모여 있는데 가끔 유난히 큰 값이 튀어나옵니다. 문제는 스케일 배율이 묶음 안에서 가장 큰 값에 맞춰 정해진다는 데 있습니다. 128개 중 하나가 크게 튀면 그 하나에 맞춰 눈금 간격이 벌어지고, 나머지 127개는 전부 0 칸으로 눌려버립니다. 한 사람이 눈금 폭을 독차지하는 바람에 나머지가 전부 같은 칸에 들어가는 셈입니다. 압축률은 좋아지는데 모델은 말을 못 하게 됩니다.
Bonsai 2가 쓰는 처방이 블록 단위 아다마르 회전(Hadamard rotation)입니다. 가중치 묶음을 수학적으로 회전시킨 다음 반올림합니다. 축을 돌리면 한 방향에 쏠려 있던 큰 값이 여러 방향으로 나뉘어 퍼집니다. 튀는 값 하나가 만들던 눈금 폭이 줄어들고, 묻혀 있던 나머지 가중치들도 자기 칸을 되찾습니다. 삐죽한 봉우리 하나를 여러 개의 낮은 언덕으로 흩어놓는다고 생각하면 얼추 맞습니다.
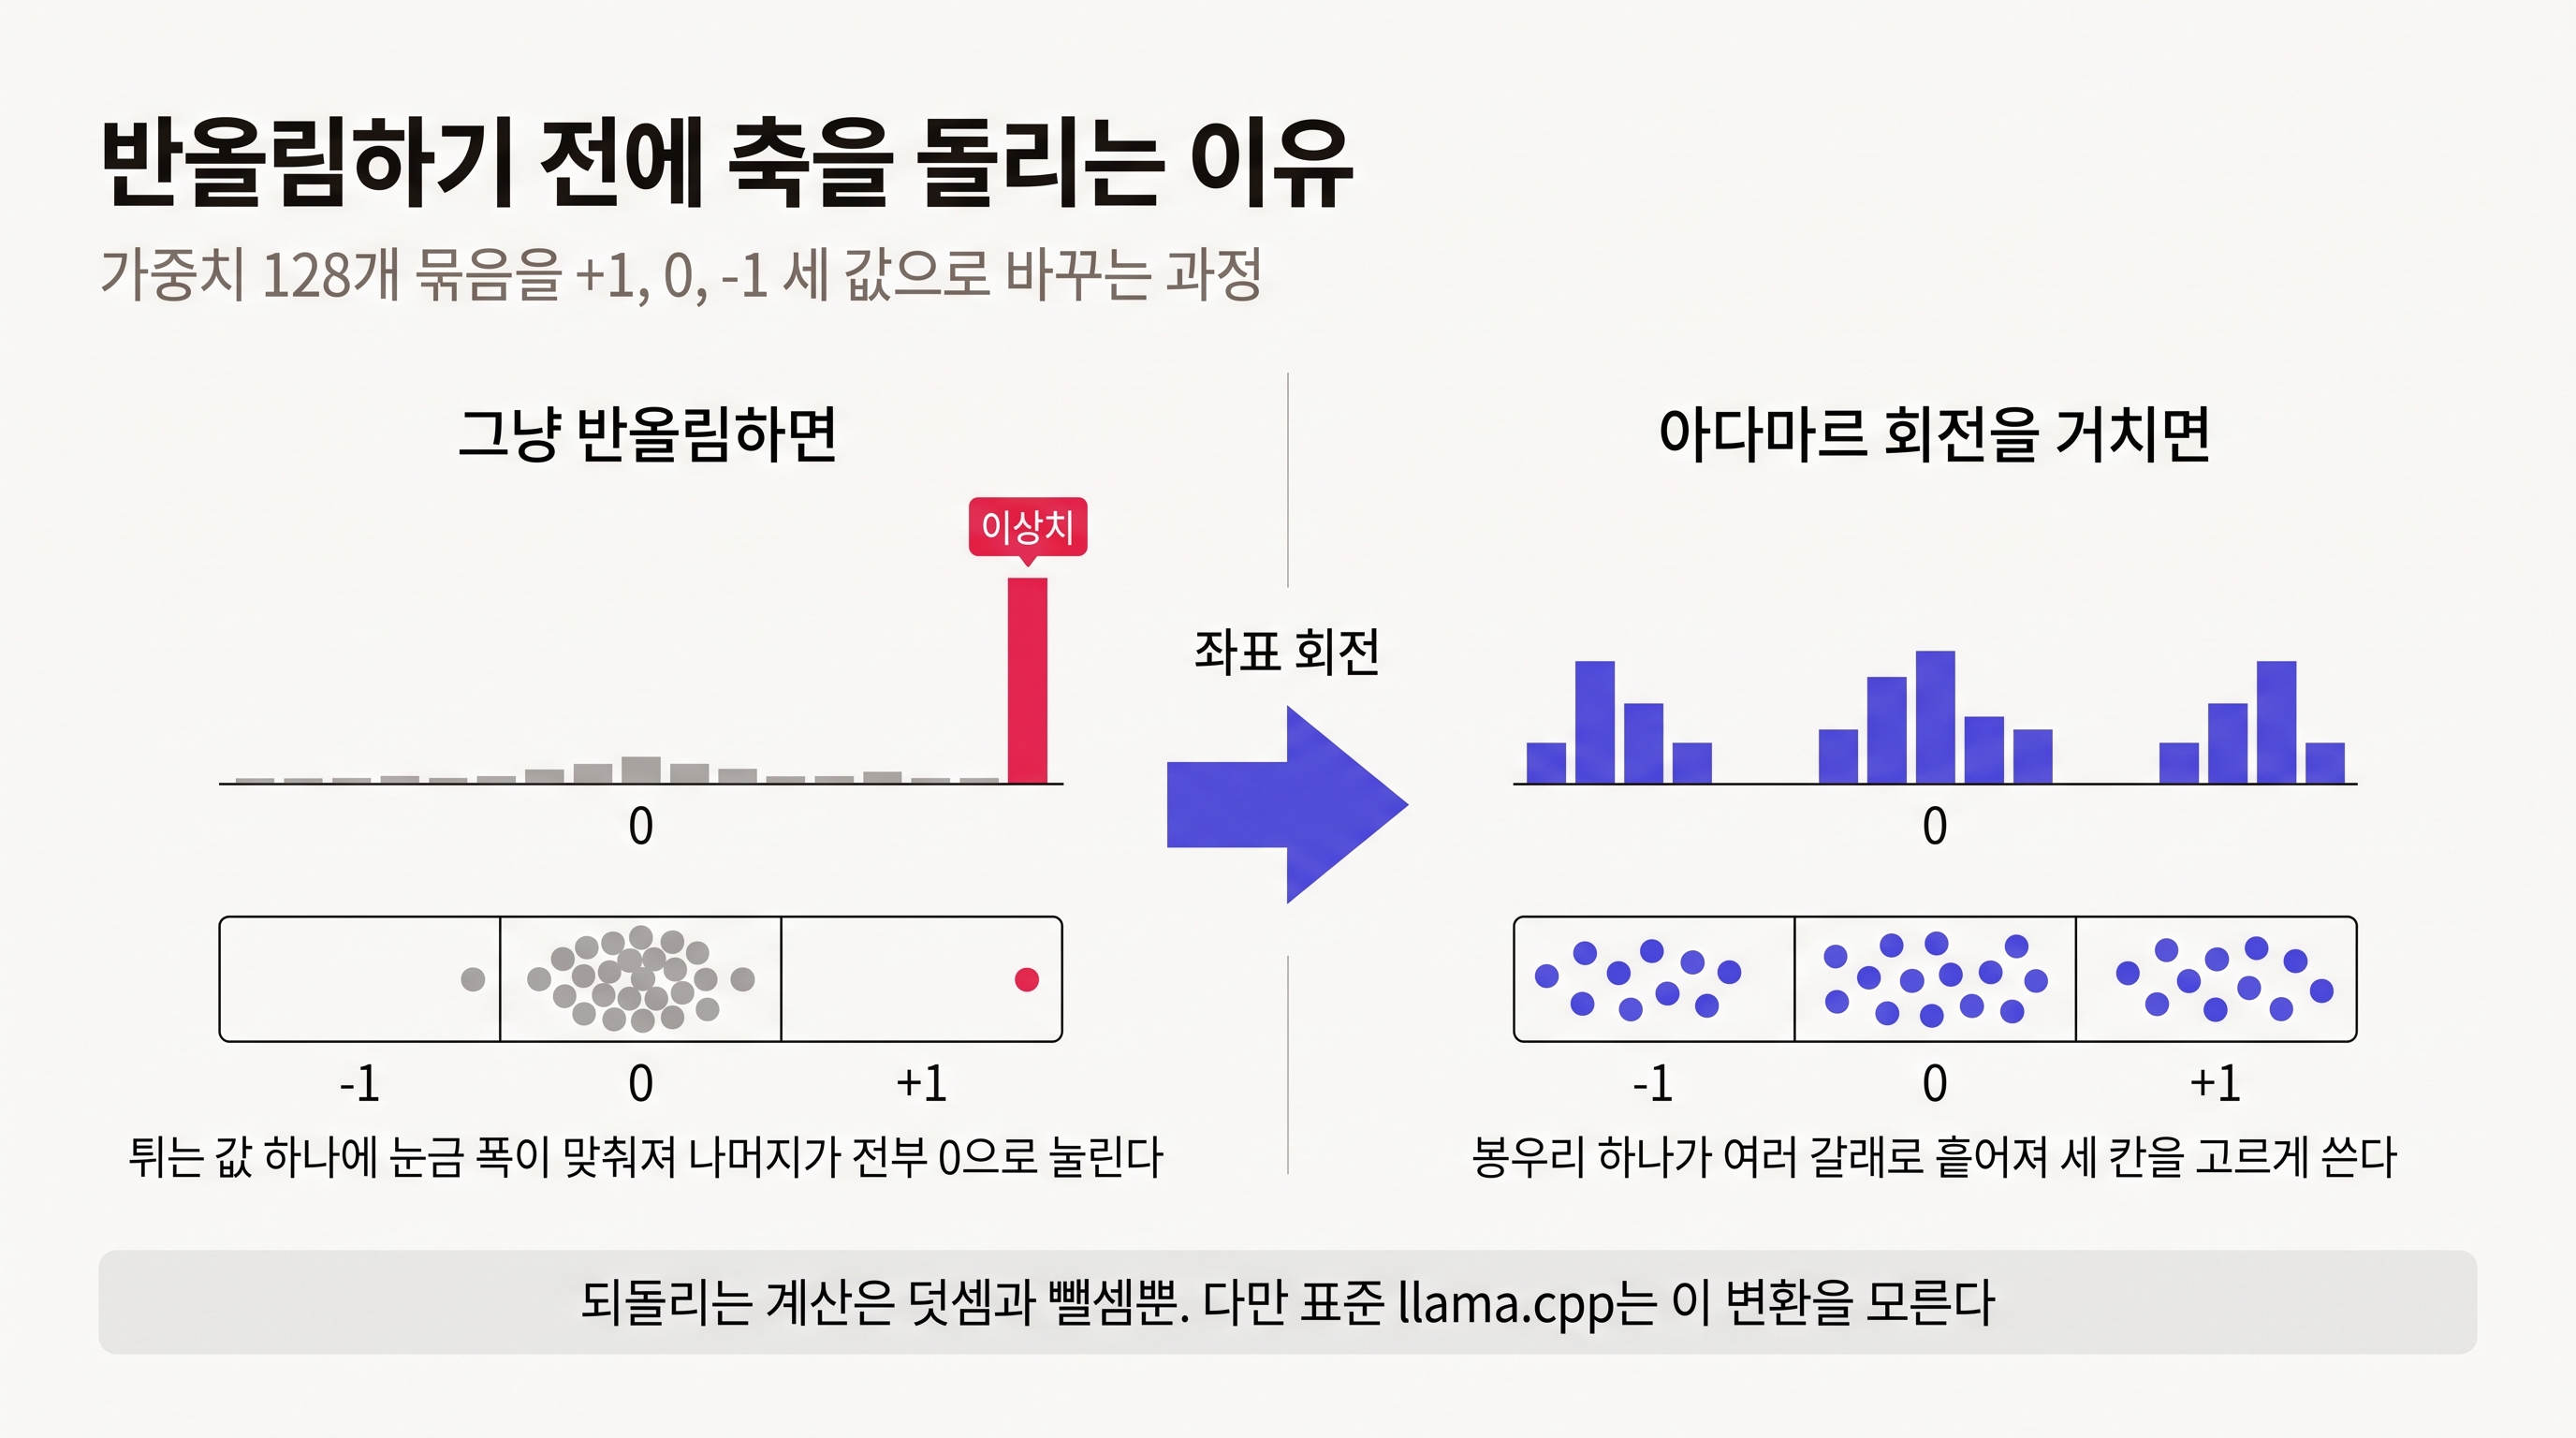
추론할 때는 원래 좌표가 필요하니 다시 되돌려야 합니다. 아다마르 변환을 고른 이유가 여기 있습니다. 되돌리는 계산이 덧셈과 뺄셈만으로 끝나서, 행렬 곱셈을 한 번 더 하는 것에 비하면 거의 공짜입니다.
대가는 따로 있습니다. 가중치를 돌려놨으면 입력값도 같은 각도로 돌려야 계산이 맞습니다. 그런데 이 변환은 표준 llama.cpp가 모르는 연산입니다. 그래서 PrismML은 자기들이 고친 llama.cpp 포크를 받아야 GGUF 파일이 돌아간다고 안내합니다. 애플 실리콘용 MLX 포맷은 손대지 않은 런타임에서 그냥 돌아가지만, 리눅스나 윈도우에서 GGUF로 쓰려면 특정 회사의 포크를 하나 더 얹어야 합니다. 라이선스는 아파치 2.0으로 활짝 열어놓고 실행 경로에는 잠금장치를 하나 걸어둔 모양새입니다.
98.2%를 어디까지 믿을까
PrismML이 앞세운 숫자는 98.2%입니다. 20개 벤치마크를 thinking 모드로 돌려 평균 83.9점을 받았고, 원본 FP16 모델의 85.4점 대비 98.2%라는 계산입니다. 직전 세대인 첫 27B판은 같은 기준으로 95% 수준이었습니다. 두 달 만에 3%포인트를 좁힌 겁니다. Bonsai 시리즈가 처음 나온 게 올해 3월이니, 회사가 내세우는 것도 크기보다는 이 속도입니다.
여기서 멈추면 보도자료를 옮겨 적는 일이 됩니다. 이 숫자에는 짚어둘 구멍이 몇 개 있습니다.
먼저 98.2%는 20개 점수의 평균끼리 나눈 비율입니다. 모든 능력이 고르게 98% 남았다는 뜻이 아닙니다. 평균은 항목별 편차를 지우고 하나의 숫자로 덮습니다. 어떤 항목이 얼마나 떨어졌는지는 비율만 봐서는 알 수 없습니다.
그 편차를 짐작할 단서가 하나 있습니다. 양자화에 가장 취약한 영역이 대표 수치에 올라오지 않았다는 사실입니다. 에이전트 방식 코딩, 그러니까 모델이 도구를 부르고 결과를 보고 다시 판단하기를 수십 번 반복하는 작업은 압축에 특히 약합니다. 한 번에 끝나는 질문은 살짝 흔들려도 답이 크게 달라지지 않지만, 긴 사슬에서는 중간의 작은 오차가 뒤로 갈수록 불어나기 때문입니다. 스무 번째 단계에서 엉뚱한 파일을 열면 그다음은 전부 무의미해집니다. Bonsai 2의 에이전트 코딩 결과는 논문 안쪽에 들어가 있고 모델 카드 대표 수치에는 빠져 있습니다. AI 코딩 도구에 물려 쓰려는 사람에게는 오히려 이쪽 숫자가 먼저입니다.
조건도 봐야 합니다. 비교 기준이 된 원본 모델은 H100에서 vLLM으로, 압축을 풀어놓은 상태로 돌렸습니다. 사람들이 실제로 내려받아 쓰는 포장된 GGUF 런타임과는 실행 경로가 다릅니다. 출력 길이도 8만 2천 토큰에서 끊었는데, 오래 생각하게 두는 것 자체가 성능인 추론 모델에서 이 상한선은 결과를 바꿀 수 있습니다. 같은 문제를 여러 번 풀렸을 때의 편차나 시간 초과 비율도 공개되지 않았습니다.
이 지적들은 PrismML 쪽이 아니라 바깥에서 나왔습니다. 양자화 모델을 직접 내려받아 돌려보고 기록하는 기술 뉴스레터 The Kaitchup이 공개 자료를 뜯어 정리한 내용입니다. 그쪽도 결론까지 부정적이지는 않습니다. 6GB 아래에서 돌릴 수 있는 모델 중에는 이게 제일 낫다는 쪽입니다. 다만 평가 설계가 약한 부분을 가리는 방향으로 짜였다는 지적은 남습니다. 숫자를 만든 쪽이 그 숫자를 검증하는 구조에서 늘 반복되는 문제입니다.
실제로 돌려보려면
파일은 허깅페이스에 아파치 2.0으로 올라가 있습니다. 상업적으로 써도 되고, 고쳐서 다시 배포해도 됩니다.
포맷이 두 가지인데 숫자만 보고 고르면 안 됩니다. PTQ1_0은 5.93GB에 가중치당 1.76비트로, 삼진 값을 빈틈없이 눌러 담은 쪽입니다. PQ2_0은 7.25GB에 2.16비트로, 값 하나를 2비트 칸에 여유 있게 넣습니다. 작은 쪽이 무조건 낫지는 않습니다. 빽빽하게 눌러 담으면 읽어낼 때마다 풀어내는 계산이 붙어서, 긴 프롬프트를 처음 훑는 단계는 PQ2_0이 더 빠릅니다. 메모리가 빠듯하면 PTQ1_0, 1.3GB를 더 쓸 여유가 있고 긴 문서를 자주 넣는다면 PQ2_0 쪽이 무난합니다.
속도는 장비에 따라 크게 갈립니다. 회사 발표 기준으로 RTX 5090에서 초당 143토큰까지 나옵니다. 해커뉴스에 올라온 맥 사용자들의 보고는 초당 20~40토큰 수준인데, 이것도 사람이 읽는 속도보다는 빠릅니다. 컨텍스트는 26만 2144토큰까지 받습니다.
한 가지 주의할 점이 있습니다. 5.9GB는 가중치 파일의 크기일 뿐입니다. 실제로 돌리면 대화가 길어질수록 불어나는 KV 캐시가 메모리를 따로 씁니다. 파일이 6GB니까 메모리 8GB에서 여유 있게 돌겠다고 계산하면 긴 대화에서 막힙니다. 26만 토큰 컨텍스트를 실제로 채워 쓰려면 가중치보다 캐시가 더 큰 상황도 나옵니다.
압축이 별도의 사업이 됐다
PrismML은 캘리포니아공대 연구진이 만든 회사입니다. 신호처리와 압축을 오래 파온 바박 하시비 교수가 대표를 맡고, 데이터브릭스 공동창업자 이온 스토이카가 자문으로 들어가 있습니다. 코슬라 벤처스와 서버러스 캐피털이 참여한 시드 라운드에서 2,225만 달러를 받았습니다.
이 회사는 모델을 만들지 않습니다. 알리바바가 막대한 비용을 들여 학습한 Qwen을 가져다 줄여서 내놓고, 그것마저 아파치 2.0으로 무료 배포합니다. 첫 Bonsai가 1,100만 번 내려받혔다고 합니다. 파는 물건이 모델도 아니고 구독료도 아닌 셈입니다.
모델 공급망에 압축이라는 층이 하나 따로 생겼다고 봐야 할 것 같습니다. 누군가는 모델을 학습하고, 누군가는 그걸 개인 장비에 들어갈 크기로 줄이고, 또 누군가는 그걸 돌리는 도구를 만듭니다. 앞서 Ollama가 "돌리는 자리"에서 투자를 받았다면 PrismML은 "줄이는 자리"에서 받았습니다. 둘 다 자기가 만들지 않은 모델 위에 올라타 있습니다.
원본을 만든 쪽이 무엇을 남기는지는 아직 정리되지 않은 문제입니다. 알리바바가 Qwen을 아파치 라이선스로 푼 목적이 생태계에 자기 모델을 깔아두는 것이라면 이런 파생 모델은 오히려 반가운 일입니다. 수백만 번 내려받힌 파일마다 Qwen이라는 이름이 붙어 다니니까요. 반대로 모델 자체를 상품으로 팔 생각이었다면, 학습비를 대는 쪽과 그 결과를 쓸 만한 크기로 만들어 이름을 얻는 쪽이 갈라지는 구조입니다.
국내로 옮겨 보면, 망 분리 때문에 외부 API를 쓸 수 없는 조직들이 가장 먼저 눈길을 줄 소식입니다. 외부로 나가는 길이 막히면 선택지는 장비를 더 사들이거나 더 작은 모델로 내려가거나 쪽으로 좁아집니다. 6GB 파일로 27B급에 근접한다면 그 사이에 칸이 하나 생기는 셈입니다.
다만 이 칸에 들어가기 전에 확인할 것이 둘 있습니다.
하나는 앞에서 짚은 실행 경로입니다. 줄어든 건 파일이지 설치 절차가 아닙니다. 맥에 올린다면 표준 MLX로 끝나지만, 사내 리눅스 서버에 올릴 생각이라면 PrismML이 고친 llama.cpp 포크가 함께 들어와야 합니다. 외부 반입 소프트웨어를 하나하나 심사하는 곳에서는 모델 크기보다 이쪽이 먼저 걸립니다. 출처가 한 회사인 추론 엔진을 들여올 수 있느냐는, 아파치 2.0 라이선스가 대신 답해주지 않는 질문입니다.
다른 하나는 맡길 일의 성격입니다. 판단 기준은 대표 수치 98.2%가 아닙니다. 문서 요약이나 분류처럼 한 번에 끝나는 일이라면 압축 손실이 거의 느껴지지 않을 겁니다. 반대로 도구를 여러 번 불러 가며 오래 이어가는 작업이라면, 대표 수치에서 빠져 있던 바로 그 영역에 정면으로 걸립니다. 다행히 이건 논쟁할 필요가 없는 문제입니다. 파일을 받아서 실제로 맡길 일을 30분 시켜보면 답이 나옵니다.