9월 17일 FDA는 방사선 AI를 510(k)에서 빼달라는 청원을 최종 기각했다. 관문은 그대로 두겠다는 결정이었다. 그 관문이 사후에 얼마나 잘 걸러냈는지를 3만 1천 건으로 따진 연구가 이달 하순 대중매체를 한 바퀴 돌았다. 통과한 기기의 10.3%에 나중에 리콜이 붙었다. 저자들이 내놓은 처방은 심사 자체를 머신러닝으로 세 갈래 나누는 것이다. 다만 그 대가로 반려율이 5%에서 12.1%로 오르고, 늘어난 몫의 대부분은 아무 문제 없었을 기기가 진다.
10.3%가 나온 자리
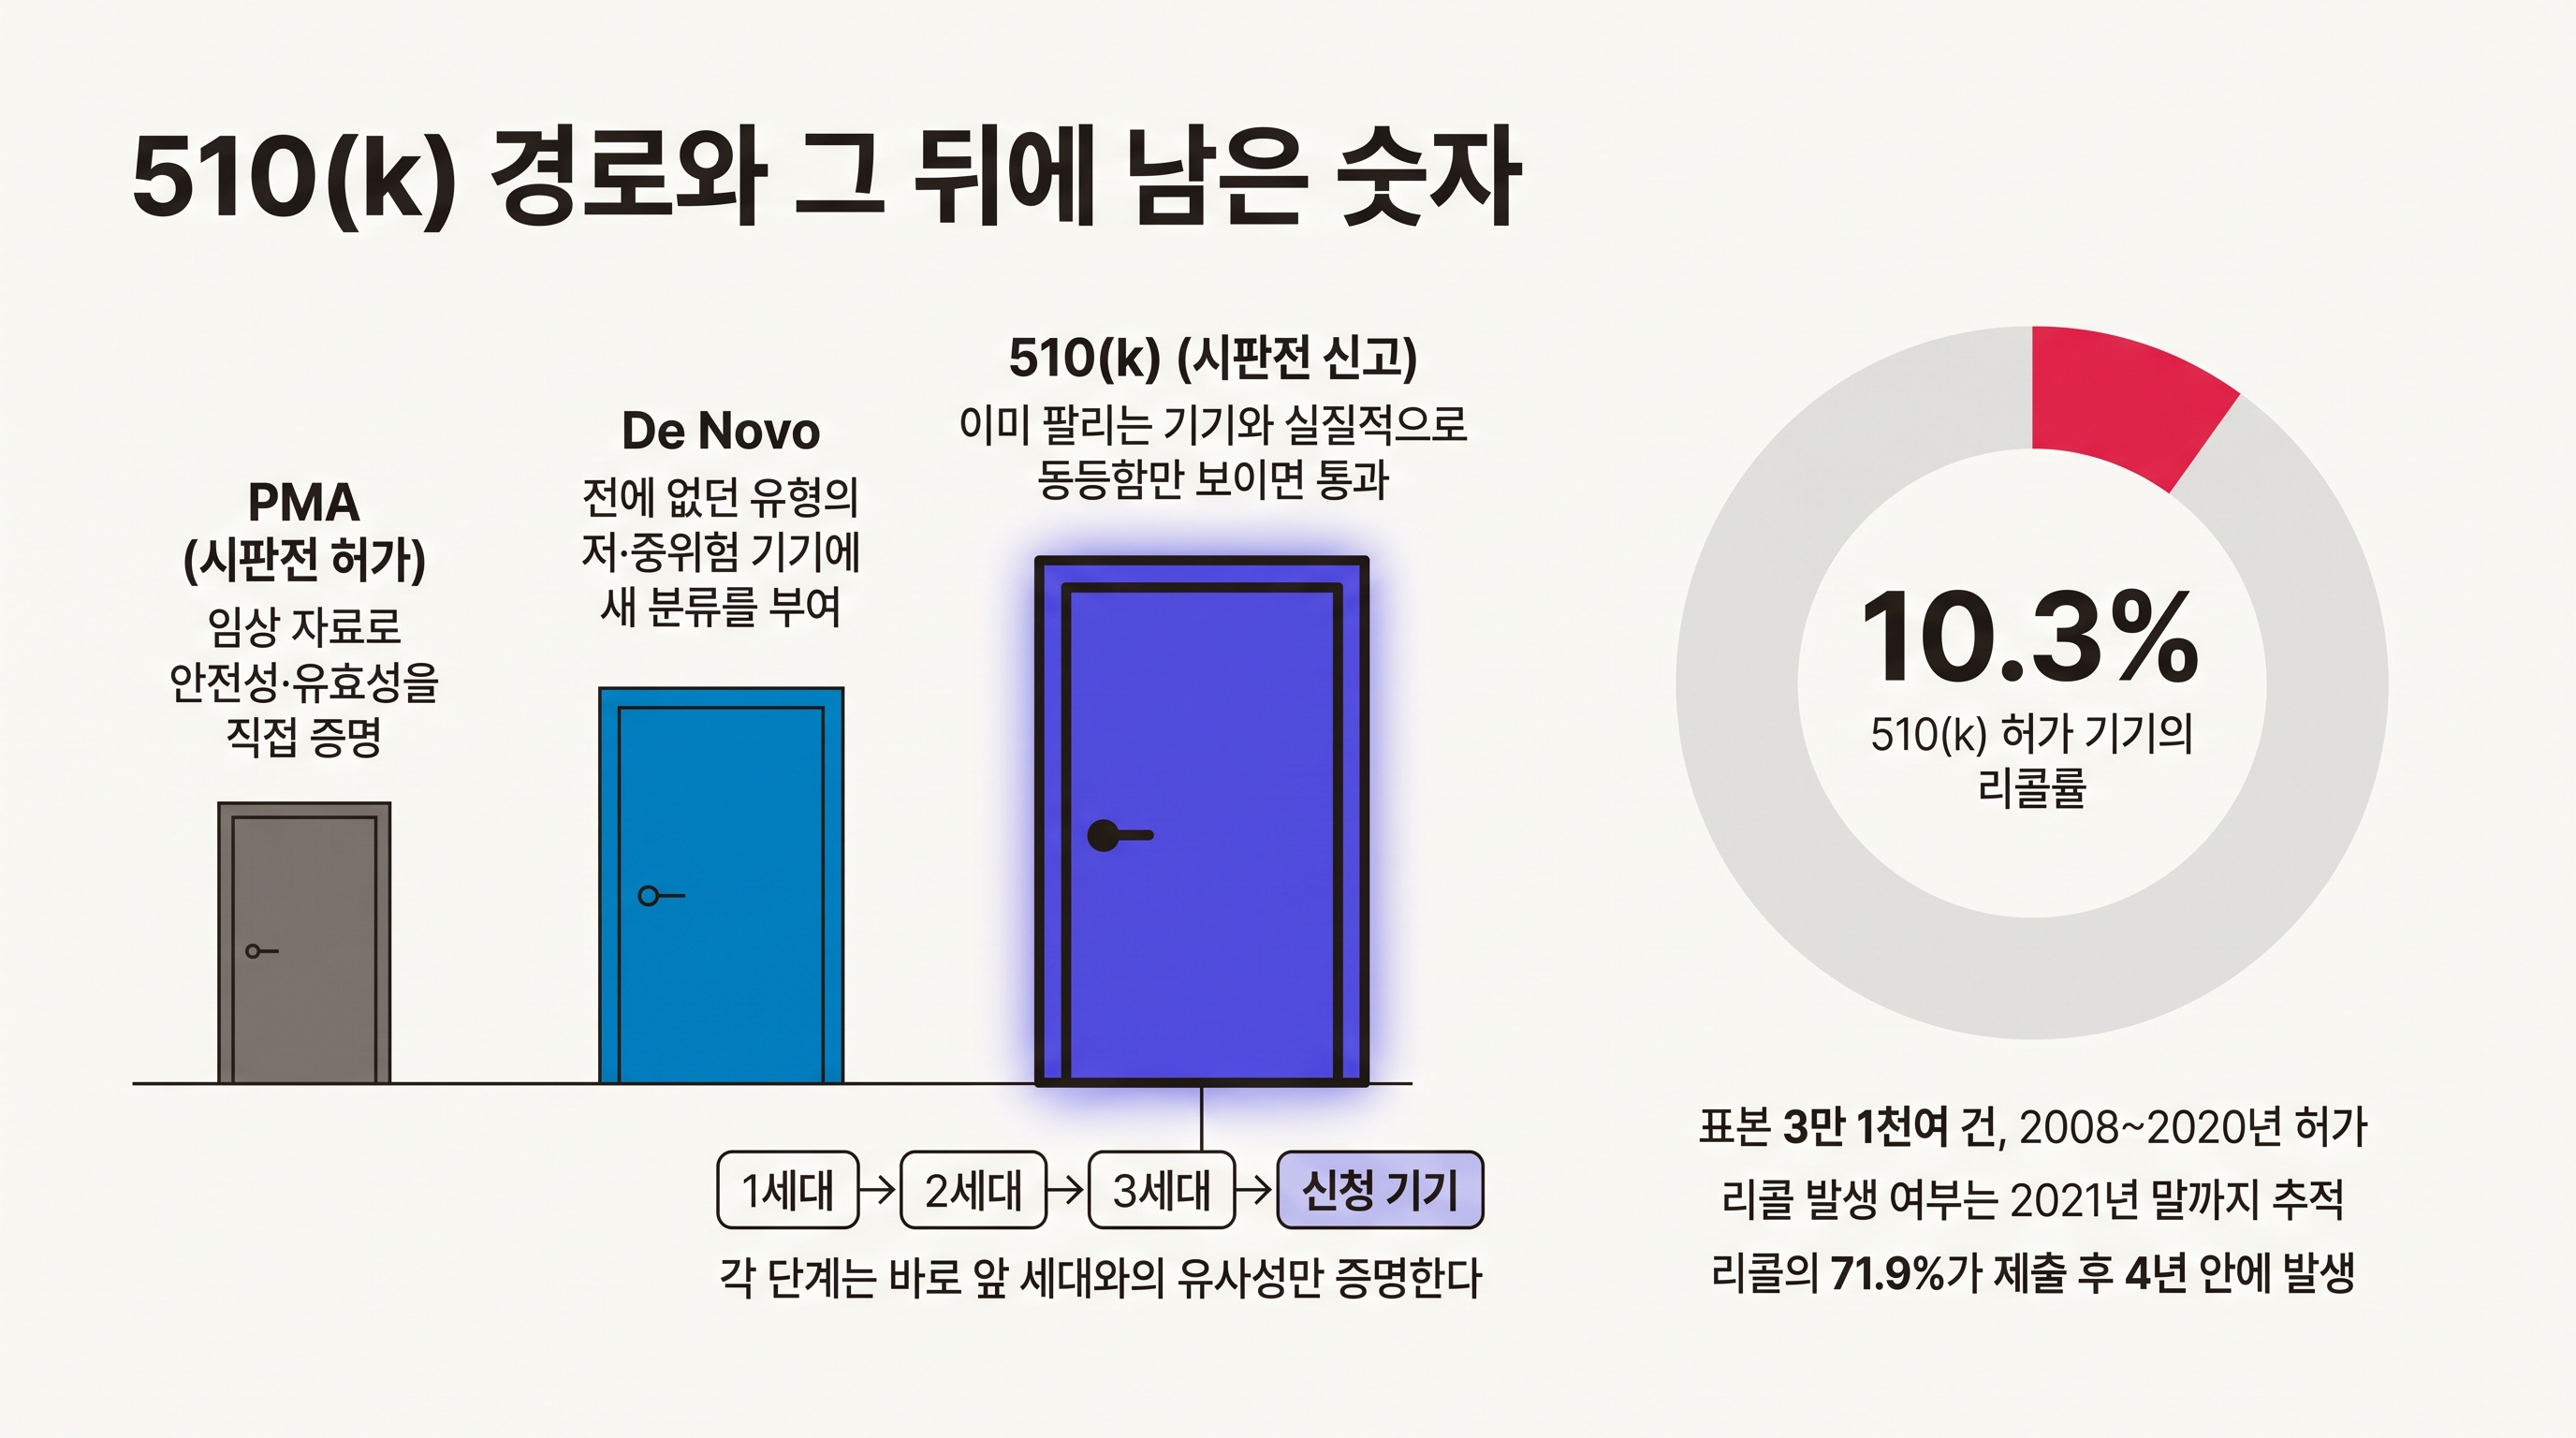
미국에서 의료기기를 파는 문은 크게 셋이다. 위험이 가장 큰 3등급 기기는 PMA, 즉 시판전 허가를 받는다. 임상 자료를 갖춰 안전성과 유효성을 직접 증명해야 하는 길이라 시간도 돈도 많이 든다. 전에 없던 유형의 저위험·중위험 기기는 De Novo로 새 분류를 만든다. 나머지 대다수가 510(k)를 지나간다.
510(k)는 이름부터가 허가가 아니라 신고다. 연방 식품의약품화장품법 510조 (k)항에서 따온 이름이고, 제조사가 "이미 합법적으로 팔리고 있는 기기와 실질적으로 동등하다"는 것만 보이면 시장에 나간다. 그 비교 대상이 되는 기존 기기를 predicate, 우리말로 비교대상 기기라고 부른다. 여기서 증명해야 하는 것은 이 기기가 안전하다는 사실이 아니라, 이미 팔리는 저것과 비슷하다는 사실이다.
이 차이는 법원에서도 확인됐다. 1996년 Medtronic v. Lohr 판결에서 연방대법원은 510(k) 절차가 안전성이 아니라 동등성에 초점을 둔다고 못 박았다. FDA 스스로도 이 경로의 한계를 인정해왔다.
문제는 동등성의 사슬이 길어진다는 데 있다. A를 근거로 B가 나오고, B를 근거로 C가 나오고, 그런 식으로 몇 세대를 내려가면 맨 처음 기기와 지금 기기는 꽤 달라진다. 그런데 각 단계에서 요구받은 것은 바로 앞 세대와의 유사성뿐이다. 업계에서는 이것을 predicate creep, 우리말로 옮기면 비교대상의 표류쯤 되는 현상이라 부른다. 사슬의 어느 마디가 부실했는지는 대개 사후에 드러난다.
사후에 드러나는 자리가 리콜이다. 제조사가 규정에 맞지 않는 기기를 회수하거나 시정하면 FDA는 그것을 리콜로 분류하고, 환자에게 끼칠 수 있는 위해의 정도에 따라 세 등급으로 나눈다. 1급은 중대한 건강 피해나 사망이 생길 만한 상황, 2급은 일시적이거나 되돌릴 수 있는 피해, 3급은 건강에 나쁜 결과를 부를 가능성이 낮은 경우다.
지금까지 이 경로를 두들긴 연구는 여럿 있었다. 2005년부터 2009년 사이 안전성 문제로 리콜된 기기의 71%가 510(k) 출신이라는 보고가 있었고, 2003년부터 2018년까지 510(k)로 허가된 기기의 11%가 나중에 1급이나 2급 리콜을 겪었다는 분석도 있었다. 다만 이 숫자들은 문제를 지적할 뿐, 그래서 어떻게 하자는 답으로 이어지지는 않았다.
이번에 Management Science에 실린 논문이 겨눈 곳이 그 빈자리다. 인디애나대 켈리경영대학원의 Mohammad Zhalechian, 하버드 케네디스쿨의 Soroush Saghafian, 그리고 컨설팅 회사 Emerging Health Consulting의 Omar Robles가 함께 썼다. 제목은 "Harmonizing Safety and Speed: A Human-Algorithm Approach to Enhance the FDA's Medical Device Clearance Policy", DOI는 10.1287/mnsc.2024.06477이다.
시점을 먼저 정리해두자. 이번 주에 튀어나온 발견이 아니다. arXiv에는 2024년 7월부터 사전출판본이 올라와 있었고, 저널 온라인 게재는 8월 28일이었으며, 대중매체 보도가 몰린 것이 9월 하순이다. 2년 넘게 심사대를 거친 결과물이 이제야 저널 이름을 달고 업계 바깥으로 도착한 셈인데, 하필 FDA가 같은 관문을 지키겠다고 선언한 직후에 도착했다.
저자들은 FDA의 510(k) 제출 자료와 CMS의 메디케어 청구 자료를 이어 붙여 3만 1천 건이 넘는 제출 건 데이터를 만들었다. 2008년부터 2020년 사이에 허가된 기기를 넣고, 리콜 발생 여부는 2021년 말까지 따라갔다. 공개 데이터베이스에는 신청 기기와 그 비교대상 기기를 연결해주는 구조화된 항목이 없어서, 제출 요약문서를 텍스트마이닝으로 훑어 사슬을 복원했다. 이 과정에서 약 3%가 빠졌는데, 대부분 전자제출이 의무화되기 전인 2008년부터 2011년 사이의 스캔 문서다.
이렇게 만든 표본에서 나온 숫자가 10.3%다. 510(k)를 통과한 기기 열 개 가운데 한 개꼴로 나중에 리콜 사건이 붙었다는 계산이다.
여기서 한 가지는 분명히 해두는 편이 낫다. 이 10.3%는 리콜 등급을 구분하지 않은 이진값이다. 라벨 문구를 고친 3급 시정 조치와 환자가 다칠 수 있어 회수한 1급 사건이 똑같이 한 건으로 세어져 있다. 그러니 "열에 하나가 위험한 기기였다"로 읽으면 과장이고, "열에 하나가 나중에 손을 대야 했다"로 읽는 편이 정확하다. 리콜 시점은 앞으로 쏠려 있다. 전체 리콜의 71.9%가 제출 후 4년 안에 일어났다. 한참 뒤에 드러나는 문제가 아니라 시장에 나가고 얼마 안 돼 터지는 문제가 대부분이다.
수용, 이관, 반려
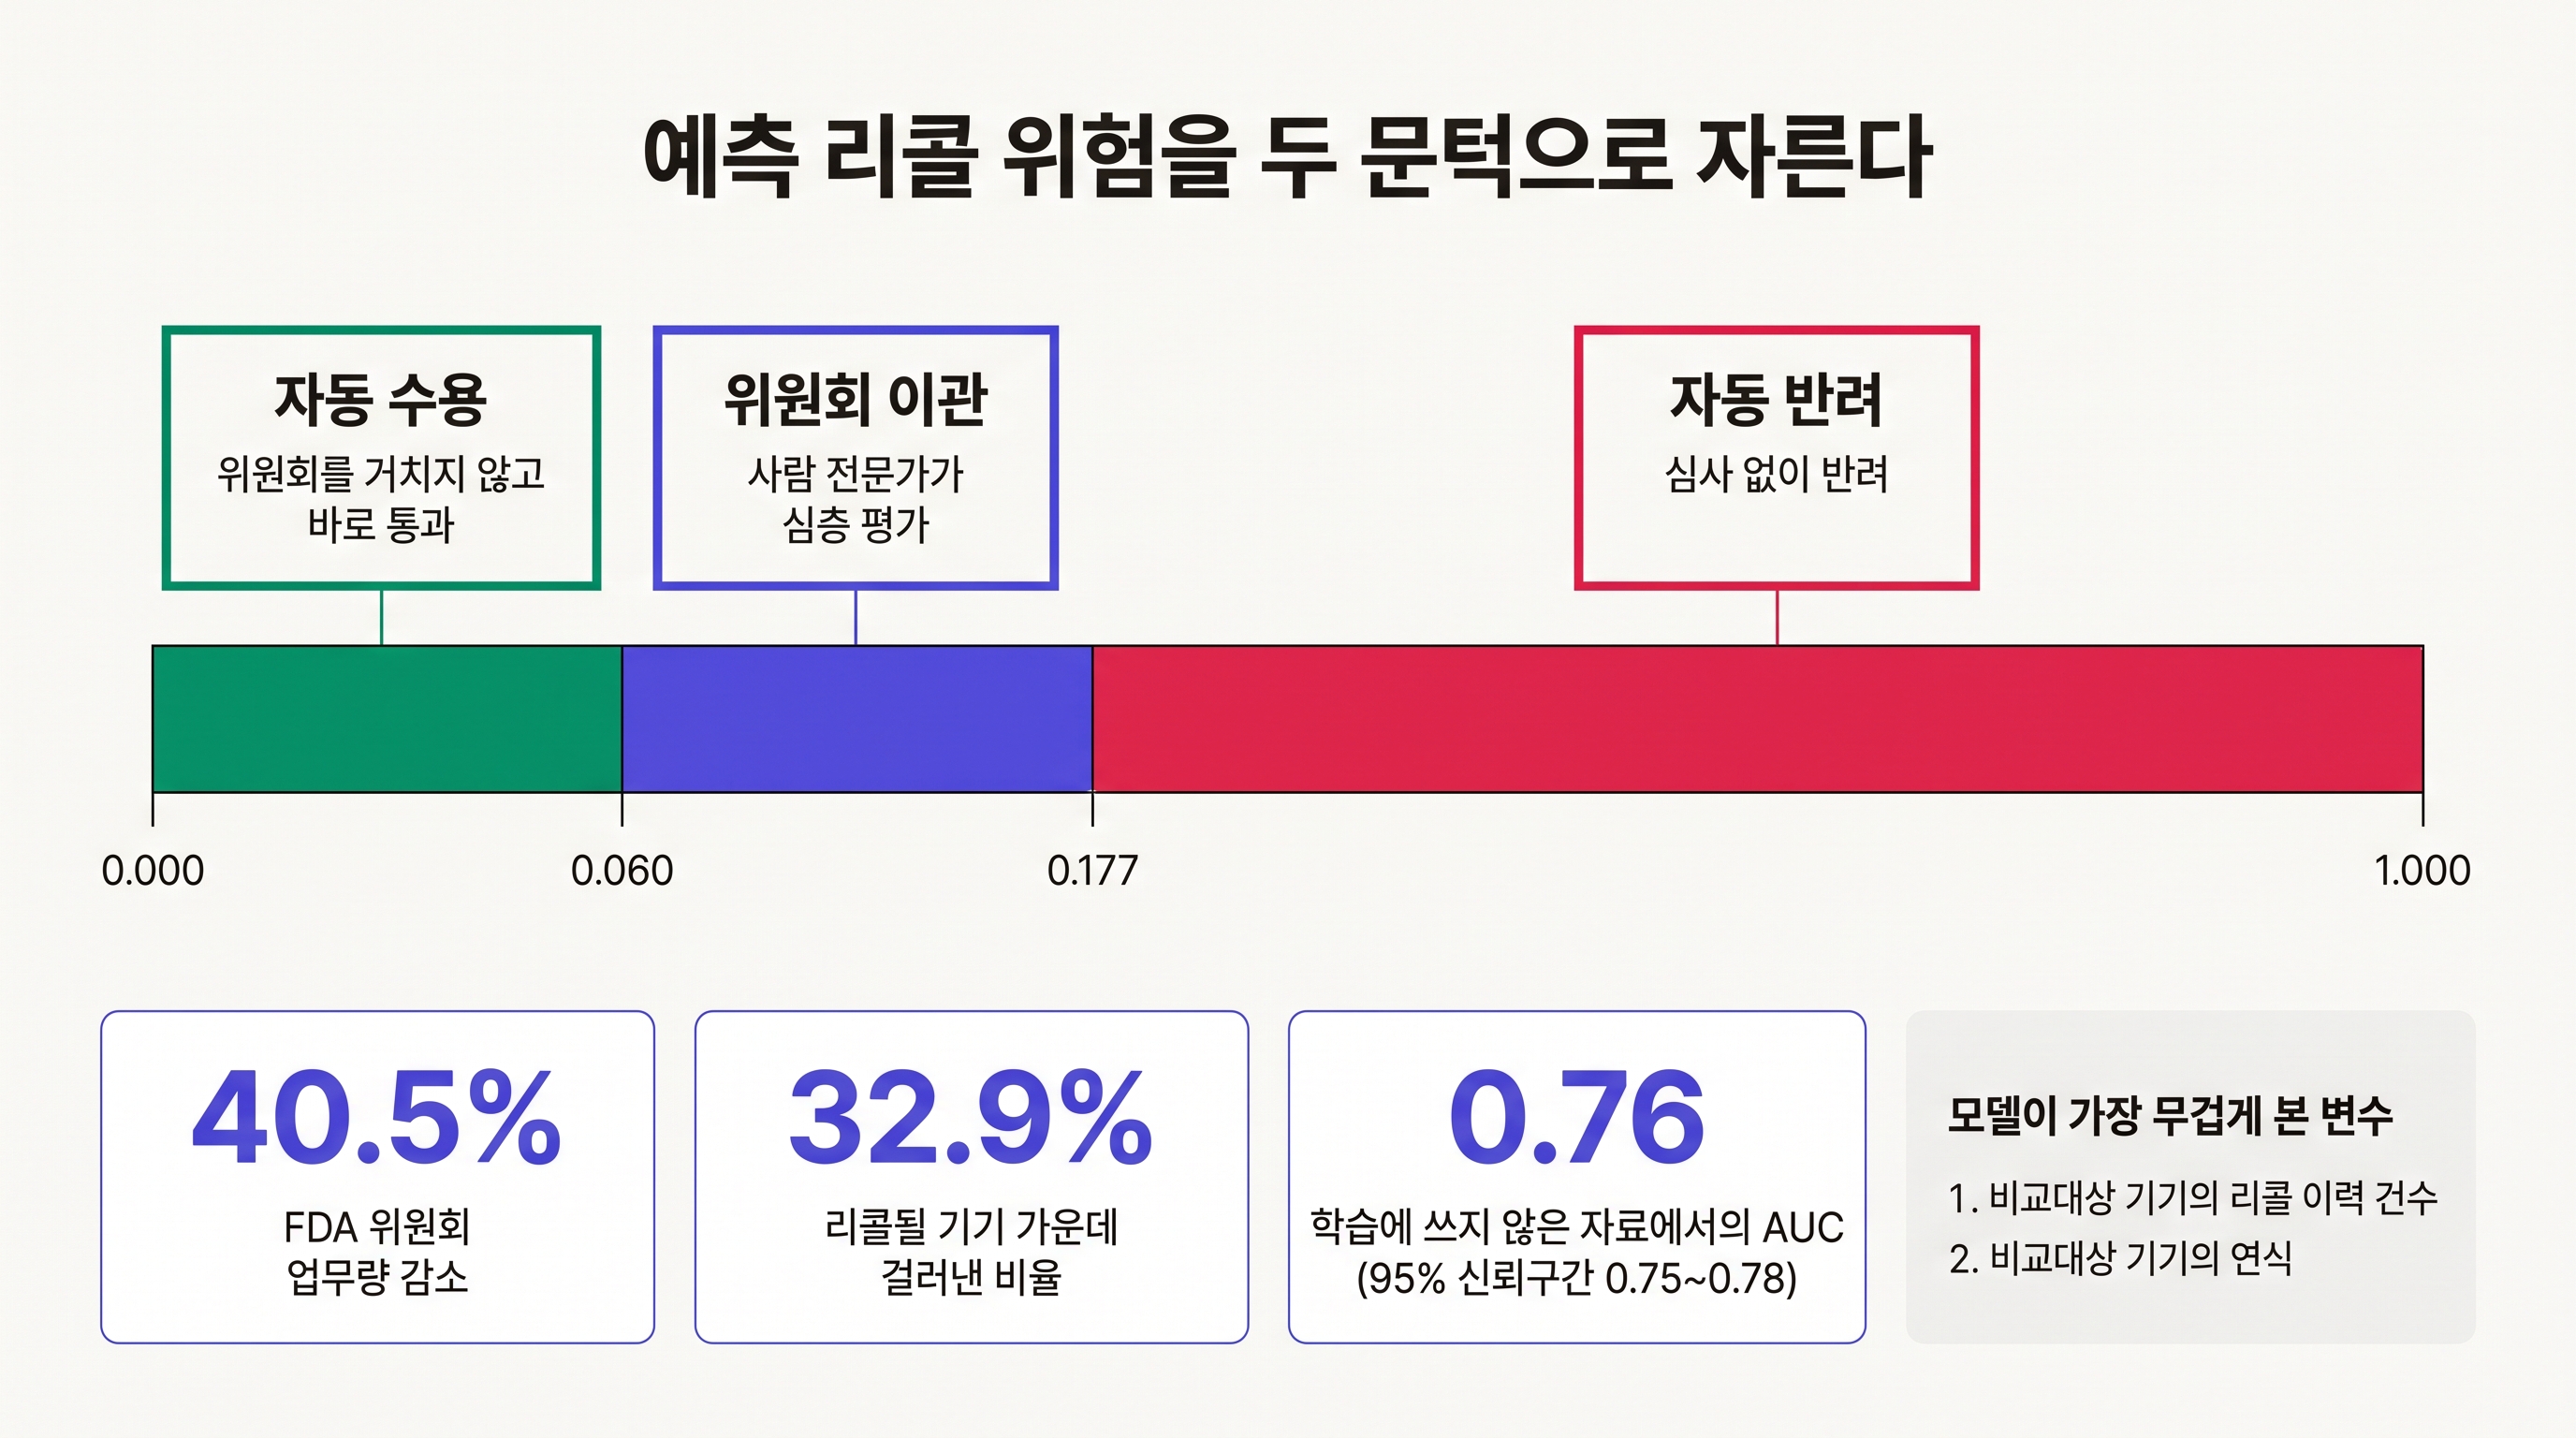
저자들의 제안은 두 단계로 되어 있다. 먼저 제출 시점에 손에 쥘 수 있는 정보만으로 그 기기가 나중에 리콜될 확률을 예측하는 모델을 만든다. 그다음 그 확률에 두 개의 문턱을 세워, 낮은 쪽은 자동 수용하고 높은 쪽은 자동 반려하고 사이에 낀 것만 사람 위원회로 넘긴다.
모델은 gradient boosting을 골랐다. 약한 결정나무를 하나씩 얹으면서 앞 나무가 틀린 부분을 다음 나무가 메우도록 학습시키는 방식이다. 로지스틱 회귀, 랜덤포레스트, Cox 생존모형도 같이 돌렸는데 성능 차이는 크지 않았다.
성능을 재는 잣대는 AUC다. 무작위로 고른 리콜될 기기와 리콜되지 않을 기기 한 쌍을 놓았을 때 모델이 앞쪽에 더 높은 위험 점수를 매길 확률이라고 보면 된다. 0.5면 동전 던지기, 1.0이면 완벽이다. 선택된 모델의 교차검증 AUC는 0.78(95% 신뢰구간 0.74~0.81), 학습에 쓰지 않은 자료에서의 AUC는 0.76(0.75~0.78)이었다. 리콜 등급별로 따로 재보니 1급 0.78, 2급 0.76, 3급 0.75로, 심각한 리콜일수록 조금 더 잘 맞혔다. 앞 절의 10.3%는 등급을 뭉갠 숫자였지만 모델 평가에서는 등급을 갈라 본 셈이다.
모델이 무엇을 보고 판단했는지가 실은 이 논문에서 가장 오래 남을 부분이다. 저자들은 SHAP으로 변수 기여도를 뜯어봤다. 예측값 하나를 놓고 각 변수가 그 값을 얼마나 밀어 올리고 끌어내렸는지 분해해주는 방법이다. 가장 힘이 센 변수는 비교대상 기기의 리콜 이력 건수였고, 그다음이 비교대상 기기의 연식이었다. 신청 기기 자체의 성능 자료가 아니라, 그 기기가 근거로 삼은 기존 기기의 전과 기록이 미래를 가장 잘 예측했다.
앞 절에서 이야기한 비교대상의 표류가 데이터로 확인된 것이다. 리콜 이력이 있는 기기를 근거로 삼은 신청은 그 자체로 위험 신호였다. 업계에서 오래 떠돌던 직관이었지만 3만 건 규모로 정량화된 것은 이번이 처음에 가깝다.
정책 쪽으로 넘어가면 대표 설정에서 두 문턱은 0.060과 0.177이다. 예측 리콜 위험이 6.0% 미만이면 위원회를 거치지 않고 바로 수용, 17.7%를 넘으면 바로 반려, 그 사이 구간은 사람 전문가에게 넘긴다. 결과는 FDA 위원회의 업무량이 40.5% 줄고 리콜률 지표가 32.9% 개선되는 것으로 나왔다.
이 "32.9% 개선"이 무슨 뜻인지는 짚고 넘어가야 한다. 국내외 보도 상당수가 "리콜을 3분의 1가량 줄인다"고 옮겼는데, 원 논문의 정의는 다르다. 전체 표본의 10.3%가 나중에 리콜되는 기기인데, 이 정책이 자동 반려로 걷어내는 기기 가운데 전체의 3.4%포인트가 실제로 리콜될 운명이었다. 3.4를 10.3으로 나누면 33%, 반올림 이전 값으로 32.9%가 나온다. 리콜될 기기 세 개 중 하나를 문 앞에서 잡았다는 말이지, 시장에 남은 기기의 리콜률이 3분의 1로 떨어진다는 말이 아니다.
데이터 자체의 구멍도 두 개 있다. 하나는 이 표본에 FDA가 반려한 기기가 한 건도 들어 있지 않다는 점이다. 허가된 기기만 모아놓고 허가 판단을 개선하겠다는 모델을 훈련시킨 구조다. 저자들도 이 점을 알고 있어서, 위험 점수 상위 구간에서 표본의 5%만큼을 뽑아 "FDA가 반려했을 기기"로 가정한 합성 데이터를 붙이고 정책 성능을 다시 재봤다. 결과가 크게 흔들리지는 않았다는 것이 저자들의 보고다.
나머지 하나는 관측창이 고르지 않다는 점이다. 2008년에 허가된 기기는 13년을 추적당했고 2020년에 허가된 기기는 1년밖에 추적되지 않았다. 리콜의 71.9%가 4년 안에 난다는 사실을 생각하면 최근 허가분의 리콜이 덜 잡혔을 가능성이 크다. 저자들은 추적 기간을 4년 이상부터 9년 이상까지 잘라가며 다시 학습시켰고, AUC가 0.74에서 0.78 사이에서 움직이는 것을 확인했다. 예측 성능이 절단에 크게 흔들리지 않는다는 뜻이지, 10.3%라는 기준선 자체가 편향에서 자유롭다는 뜻은 아니다.
평가 방식도 확인할 필요가 있다. 저자들은 위원회로 넘긴 기기에 대해 위원회가 역사적으로 내렸던 것과 똑같은 결정을 내린다고 가정했다. 추가 정보가 사람의 판단을 개선하는 효과를 0으로 놓은 것이다. 그래서 논문은 이 평가를 보수적이라고 부르고, 타당한 자기제한이다. 다만 뒤집어 보면 이 설계에서 개선분은 전부 자동 반려 구간에서만 나온다. 사람과 알고리즘이 협업해서 더 나은 판단에 도달한다는 그림이 아니라, 알고리즘이 확실해 보이는 양 끝을 잘라내고 사람은 가운데만 본다는 그림이다.
반려율을 5%에서 12.1%로 올린다는 말
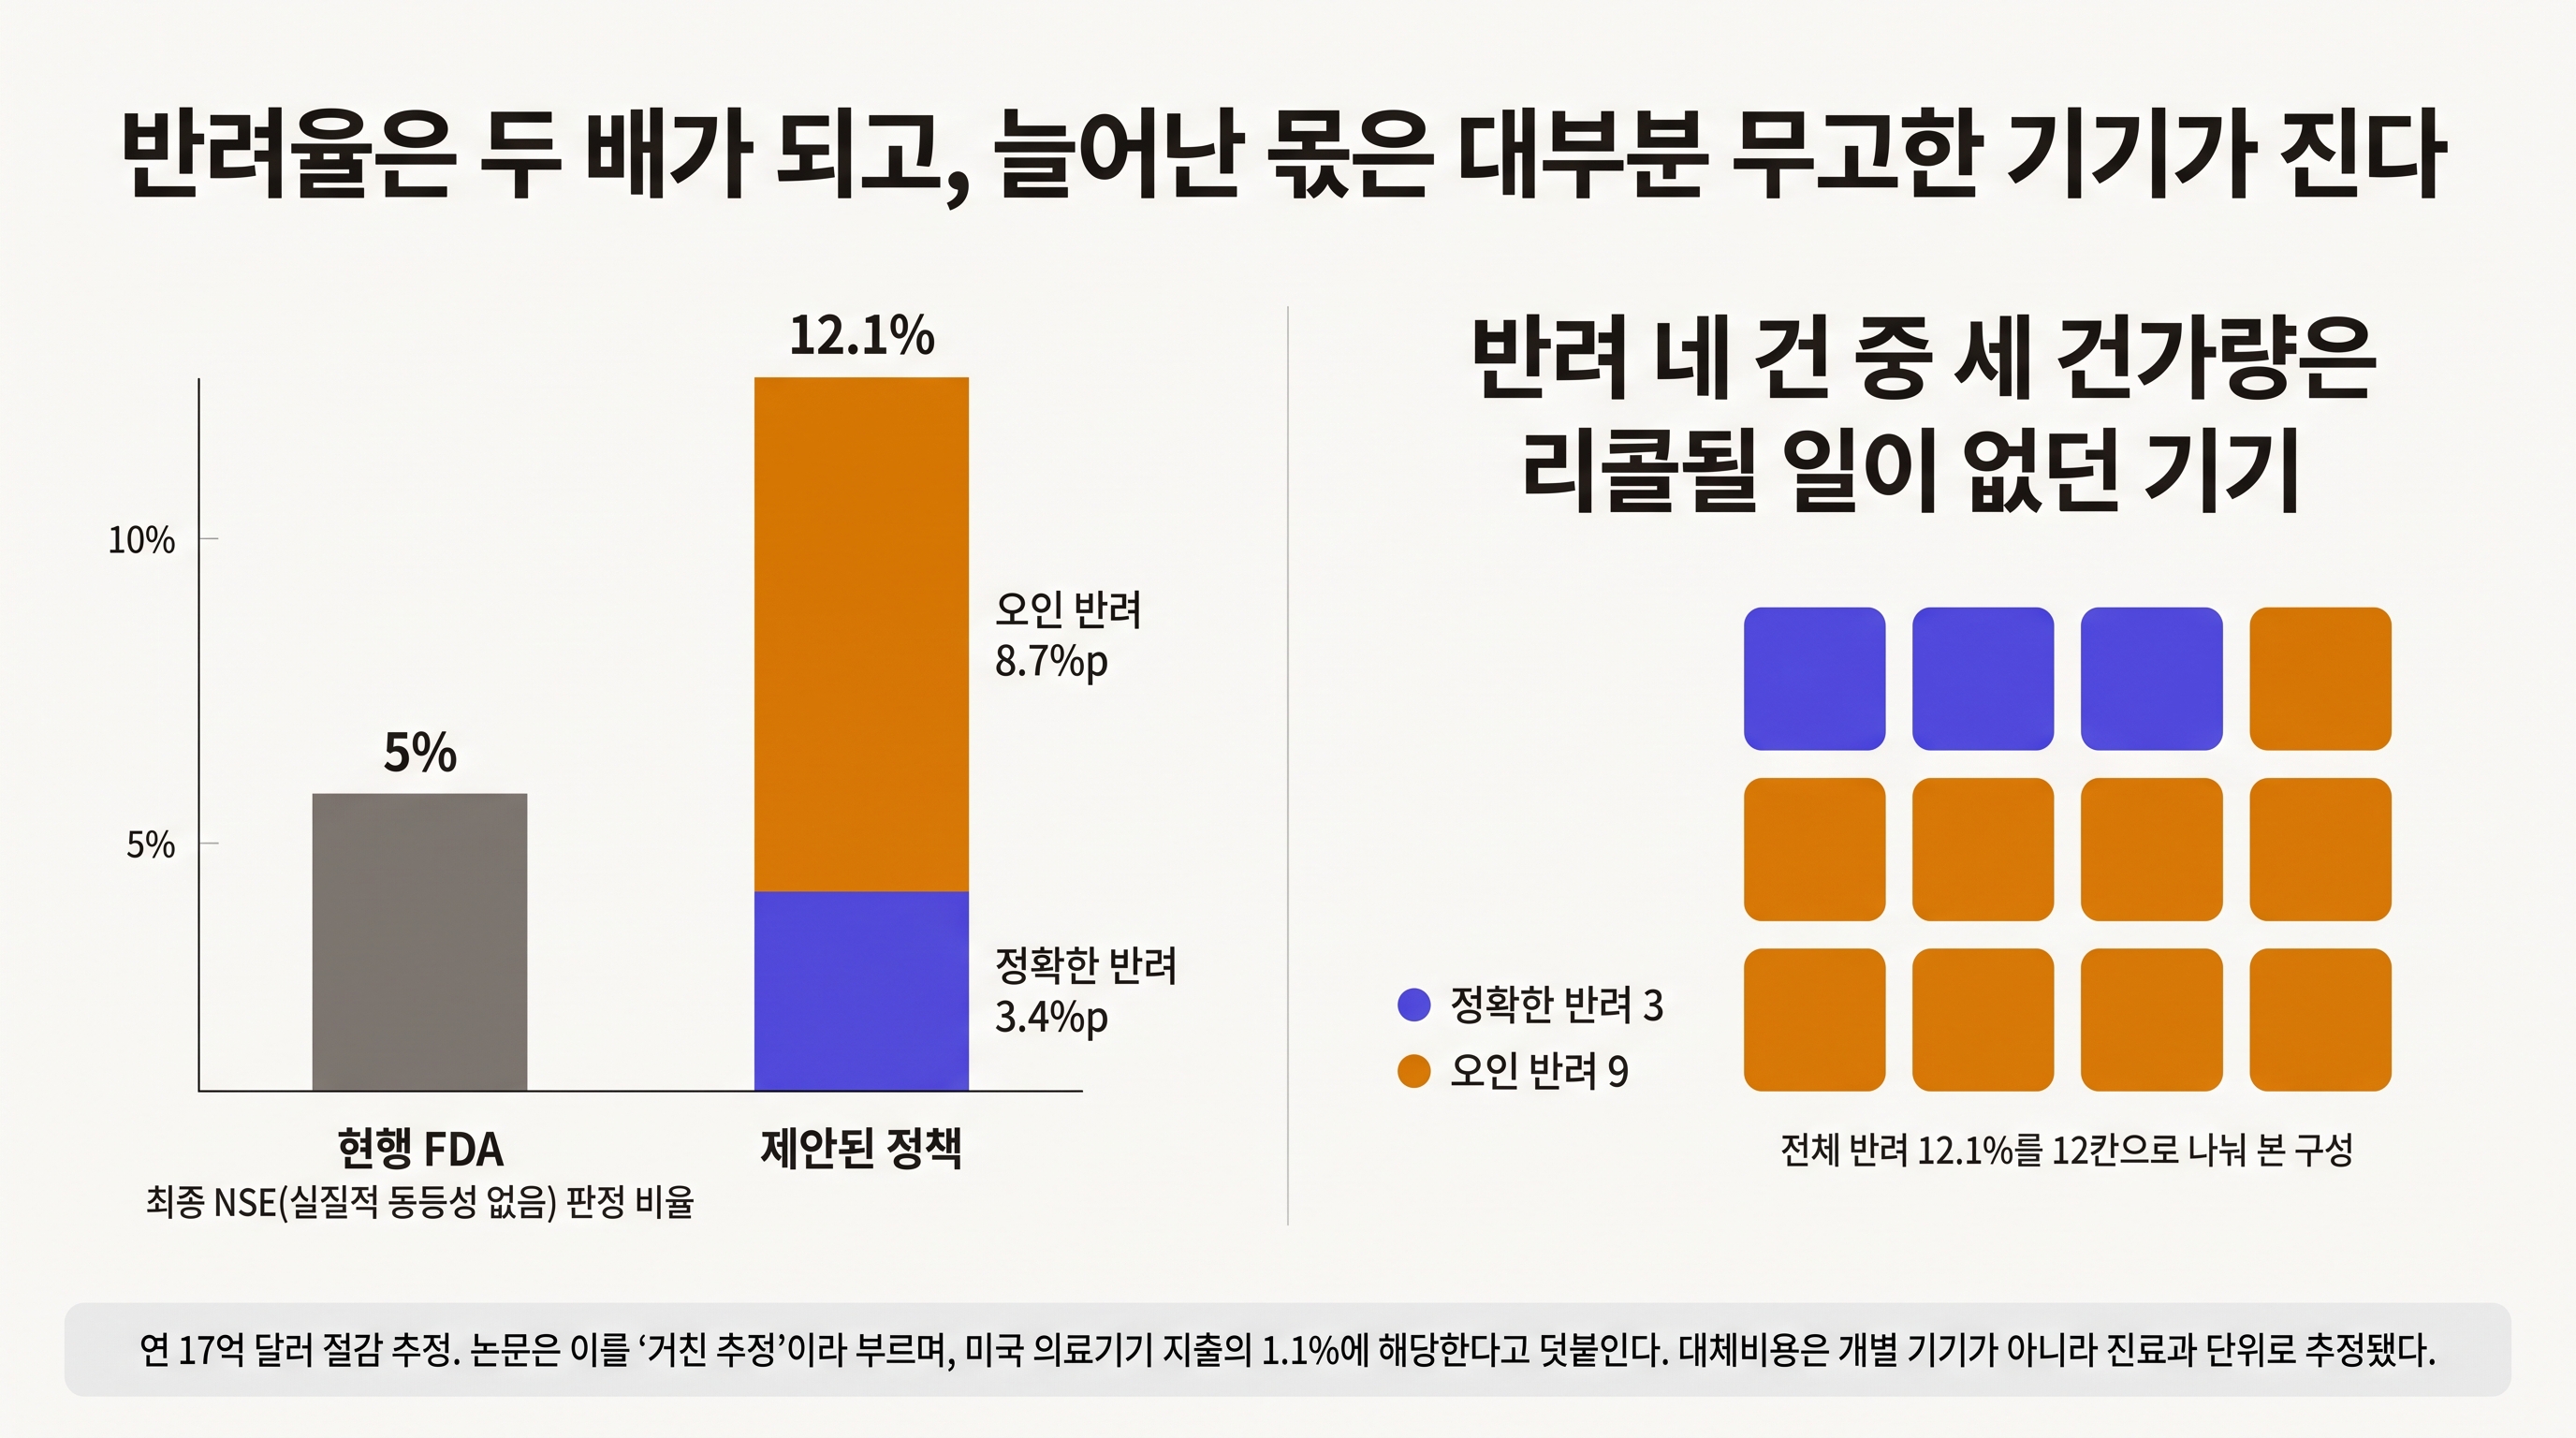
성능 개선에는 값이 붙는다. 이 정책의 전체 반려율은 12.1%다. 논문은 그 12.1%를 친절하게 쪼개놓았다. 전체 신청 대비 3.4%포인트가 옳게 반려된 것이고, 8.7%포인트는 잘못 반려된 것이다. 나중에 리콜될 일이 없었을 기기가 문 앞에서 막힌다.
8.7을 12.1로 나누면 반려 네 건 가운데 세 건가량이 오인이라는 계산이 나온다. 저자들도 이 사실을 숨기지 않는다. 다만 그들의 판단은 32.9%라는 개선폭을 생각하면 감수할 만한 맞교환이라는 것이고, FDA가 이 반려율을 높다고 보면 문턱을 조정해 낮출 수 있되 개선폭도 같이 줄어든다고 덧붙인다.
여기서 비교 기준이 하나 더 필요하다. 지금 FDA가 실제로 반려하는 비율은 얼마인가. 논문이 인용한 CDRH 내부 분석에 따르면 510(k) 제출 건의 약 5%가 최종적으로 NSE 판정을 받는다. NSE는 Not Substantially Equivalent의 약자로, 비교대상 기기와 실질적으로 동등하지 않다는 판정이다. 이 판정을 받으면 그 기기는 510(k)로는 시장에 못 나가고 De Novo나 PMA로 방향을 틀어야 한다.
그러니까 제안된 정책은 반려 비율을 5%에서 12.1%로, 두 배 넘게 올린다.
5%라는 숫자가 실제로 어떤 사건인지는 국내 사례로 보는 편이 빠르다. 2026년 4월 30일 뷰노의 심정지 예측 AI 딥카스가 FDA에서 NSE 판정을 받았다. 이 블로그가 7월에 한 편을 통째로 할애해 다뤘던 건이다. NSE는 기술을 부정하는 판정이 아니라 "이 자료로는 이 시장에서 동등성을 증명하기에 부족하다"는 절차적 판정이고, 재신청도 가능하다. 그런데 당시 딥카스는 CMS가 걸어둔 신기술 추가 수가 조건의 마감을 하루 앞두고 있었다. 절차적 판정 한 건이 급여 사이클 하나를 통째로 날렸다.
딥카스의 NSE 사유는 인구 구성 데이터가 미국 시장에 맞지 않는다는 쪽이었고, 이 논문이 다루는 리콜 위험 점수와는 층위가 다르다. 두 사건을 같은 것으로 묶으면 안 된다. 여기서 가져올 것은 하나뿐이다. 반려 판정이 회사에 닿을 때 그것은 확률이 아니라 날짜로 닿는다는 점, 그리고 그 비율을 두 배로 올리자는 제안이 회사 입장에서는 어떤 무게인지다.
게다가 늘어난 부담의 대부분은 실제로는 아무 문제가 없었을 기기가 진다. 그리고 그 반려 판단의 근거가 신청 기기 자체의 품질이 아니라 비교대상 기기의 전과라는 점이 걸린다. 모델의 최상위 변수가 비교대상 기기의 리콜 이력이라는 말은, 어떤 회사가 하필 리콜 전력이 있는 기기를 비교 대상으로 골랐다는 이유로 높은 위험 점수를 받는다는 뜻이다. 그 회사의 설계가 실제로 부실한지와는 별개다. 좁은 분야에서 쓸 만한 비교대상 기기가 몇 개 없는 상황이라면 선택의 여지 자체가 없는 경우도 생긴다.
돈 이야기도 정리해두자. 논문은 연간 약 17억 달러의 의료비 절감을 추정한다. 여기저기 인용되는 숫자이니 계산 과정을 봐야 한다. 절감의 원천은 리콜된 기기를 교체하는 비용이다. 그런데 메디케어 청구서에는 어떤 기기를 썼는지 적는 칸이 없다. 그래서 저자들은 개별 기기가 아니라 진료과 단위로 대체비용을 추정했다. 2013년부터 2020년 사이 청구 자료에서 HCPCS 코드 1,351개의 설명문을 진료과에 매칭하는 방식이다. HCPCS는 메디케어가 의료행위와 재료에 매기는 코드 체계이고, 여기에는 어느 진료과의 무슨 처치인지는 적히지만 어느 회사의 어느 기기인지는 적히지 않는다. 그렇게 시험 표본에서 나온 절감액을 연간 약 3,000건이라는 510(k) 제출 건수로 외삽해 17억 달러를 얻었다.
논문 스스로도 이 값을 rough estimate, 거친 추정이라고 부른다. 그리고 17억 달러가 얼마나 큰지를 가늠하려고 2017년 미국 의료기기 시장 규모 1,560억 달러와 견주는데, 그 비율이 1.1%다. 기사 제목에 붙은 "17억 달러"는 크게 들리지만 같은 논문이 붙여놓은 1.1%라는 꼬리표는 대개 떨어져 나간다.
AI 기기도 같은 문으로 나간다
여기까지 읽었다면 한 가지를 짚고 넘어가야 한다. 이 논문에는 artificial intelligence라는 단어도, software as a medical device라는 표현도 한 번도 나오지 않는다. 510(k) 전체를 다룬 연구이지 AI 기기를 따로 떼어 본 연구가 아니다. 그러니 이 결과를 의료 AI 이야기로 옮기는 순간부터는 추론이 붙는다는 것을 전제하고 읽어야 한다.
그 전제 위에서 보면 연결 고리는 두 갈래다.
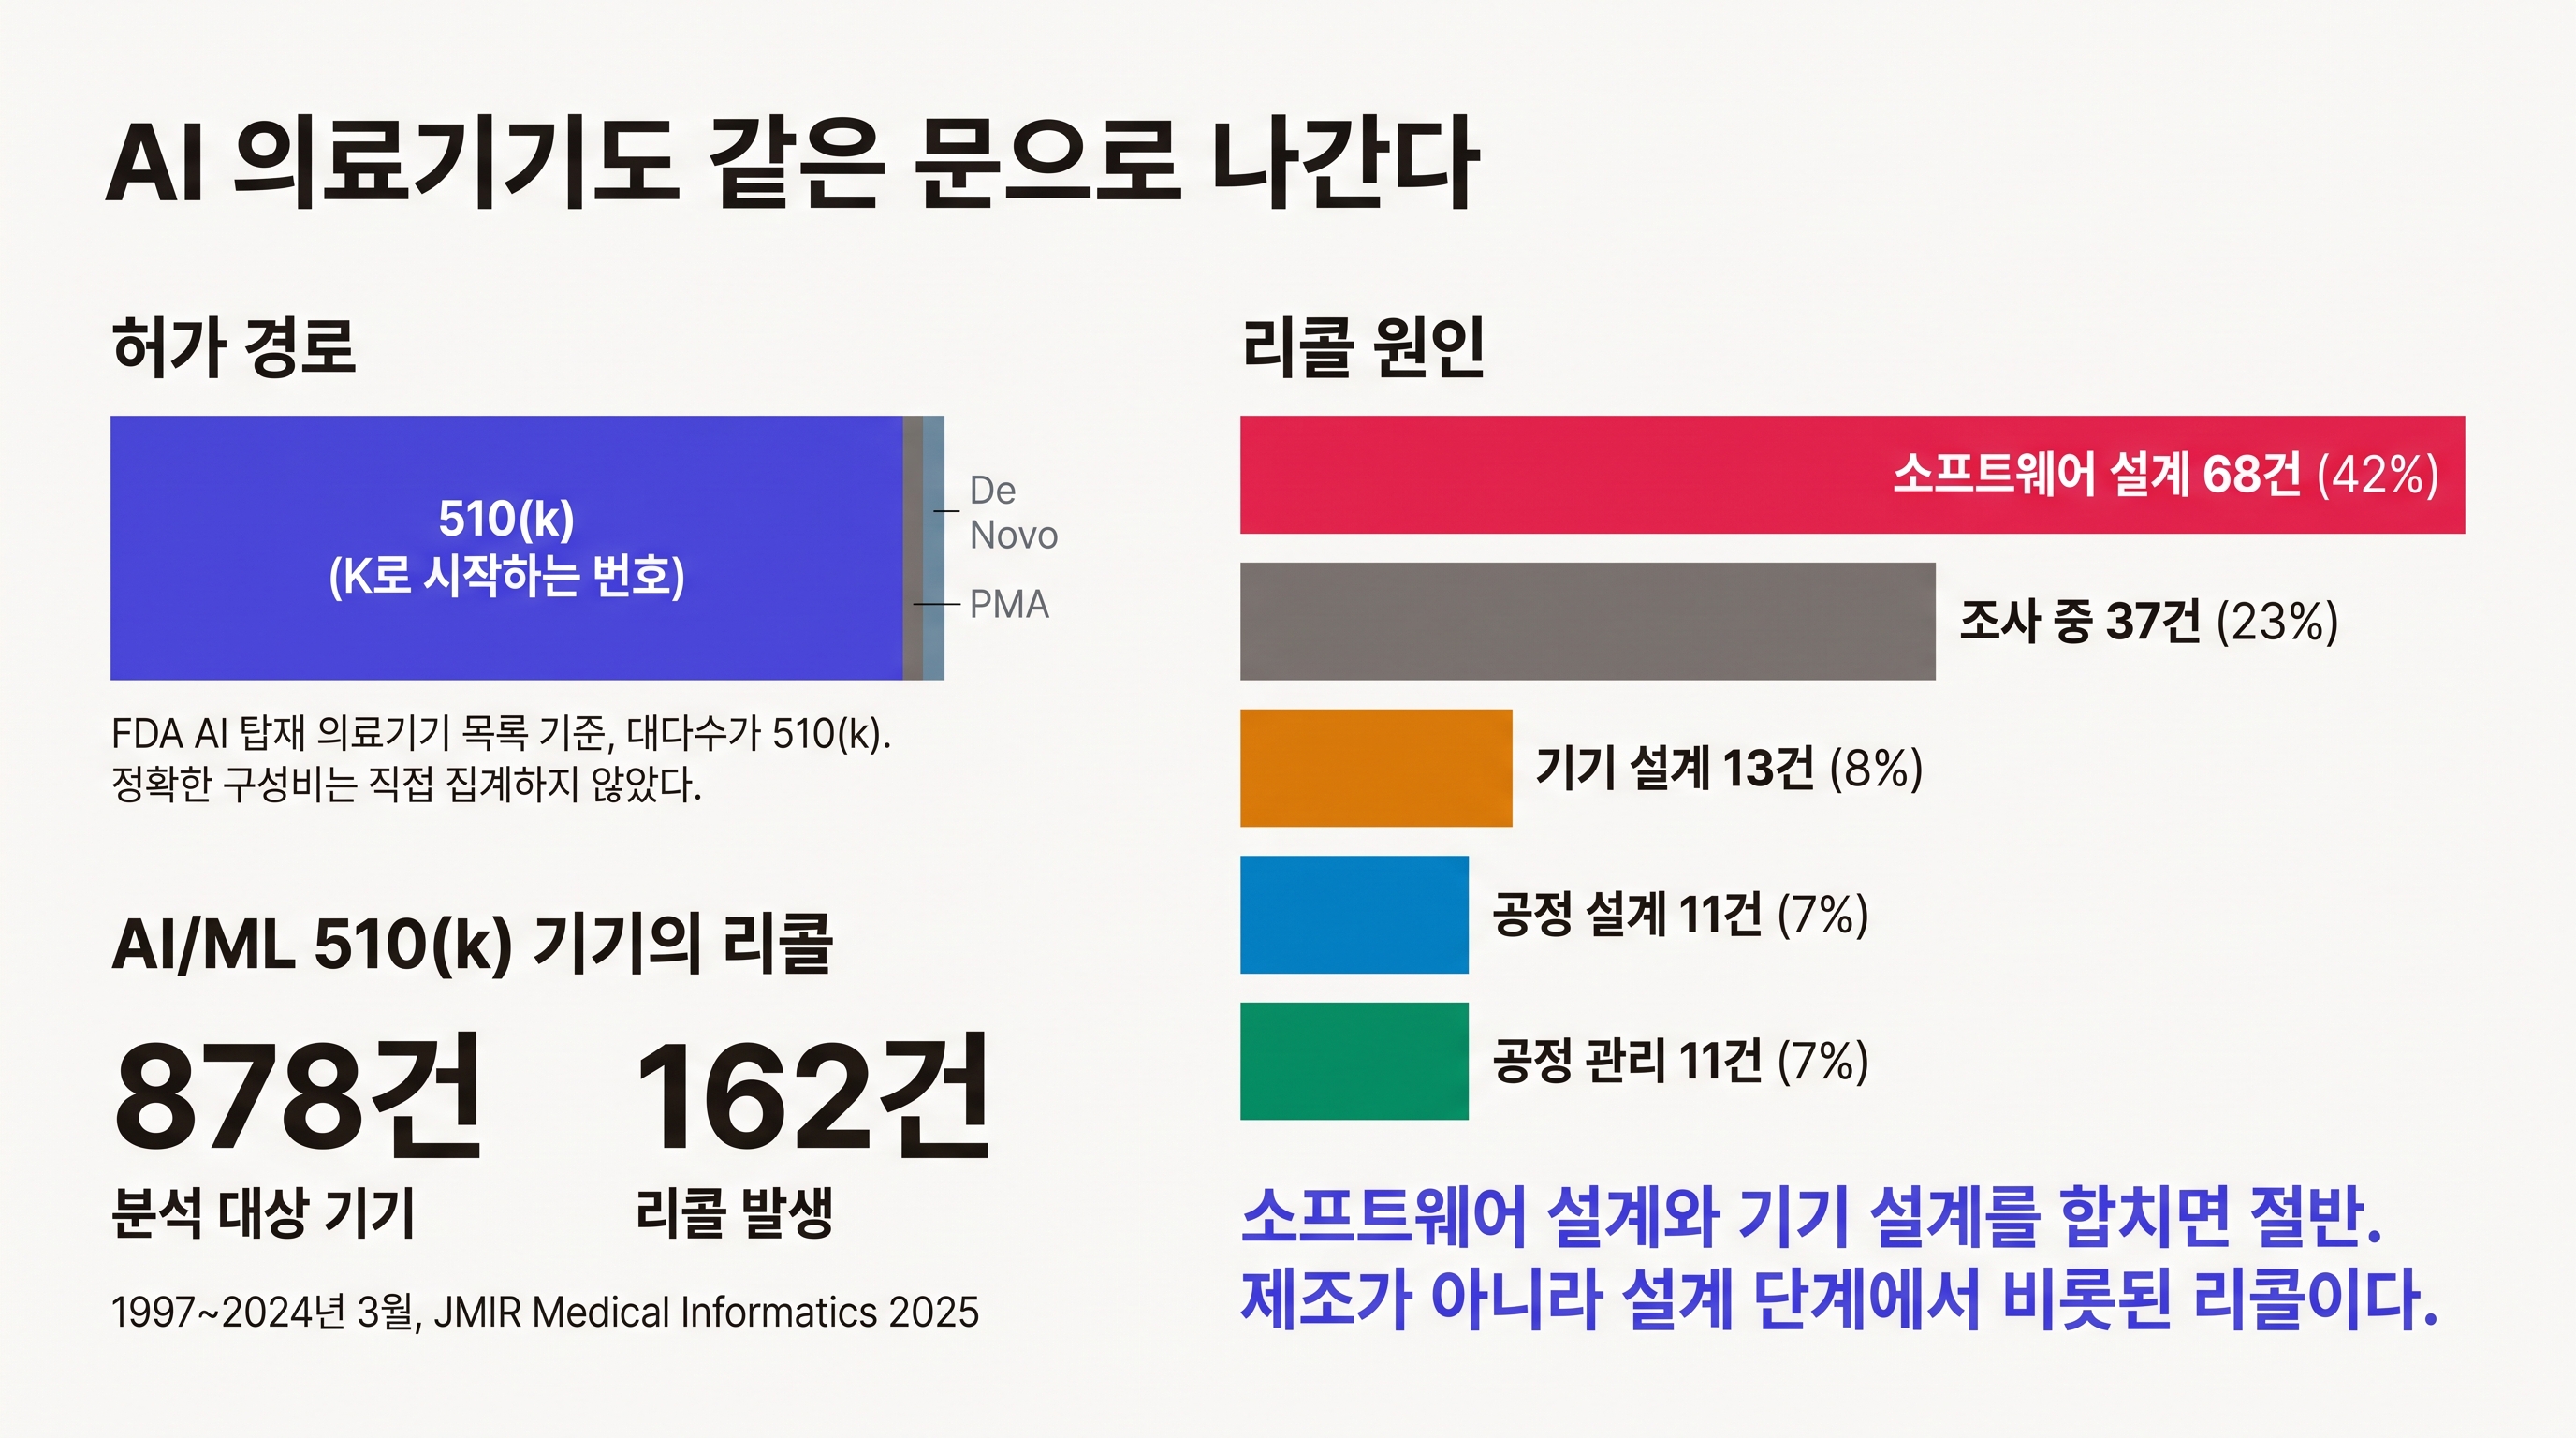
첫째, AI 의료기기는 거의 전부가 510(k)로 나간다. FDA가 공개하는 AI 탑재 의료기기 목록을 훑어보면 K로 시작하는 510(k) 번호가 대다수이고, DEN으로 시작하는 De Novo나 P로 시작하는 PMA는 드물게 섞여 있다. 정확한 구성비를 직접 세지는 않았으니 비율을 단정하지는 않겠다. 다만 510(k)가 사후에 얼마나 잘 걸러내느냐는 질문이 의료 AI 업계에는 남의 일이 아니라는 결론에는 그 정도 관찰로도 충분하다.
둘째, AI 기기의 리콜은 이미 관찰된 현상이다. 2025년 7월 JMIR Medical Informatics에 실린 대만 연구진의 분석이 이 부분을 다뤘다. 1997년부터 2024년 3월까지를 훑어 AI/ML이 들어간 510(k) 기기 878건을 추려냈고, 그 가운데 162건에서 리콜이 발생했다. 제품코드로는 110개에 걸쳐 있었다. 원인을 분류해보니 1위가 소프트웨어 설계로 68건, 전체의 42%였다. 기기 설계 13건까지 합치면 설계·개발 단계에서 비롯된 리콜이 절반을 차지했다. 제조 공정이나 부품 문제가 아니라 만들 때의 설계 판단이 문제였다는 이야기다. 분야로는 영상의학과 심혈관에 몰려 있었다.
이 두 갈래를 합치면 그림이 조금 불편해진다. AI 기기의 리콜은 설계 단계에서 이미 배태되는 경우가 많고, 설계 단계의 정보는 바로 510(k) 제출 시점에 서류로 제출되는 정보다. Management Science 논문이 예측에 쓴 정보도 정확히 그 시점의 정보다. 이론적으로는 걸러낼 여지가 있다는 말이 된다.
실제로 걸러낼 수 있을지는 다른 문제다. 이 모델이 가장 무겁게 본 변수는 비교대상 기기의 리콜 이력이었다. 그런데 AI/ML 기기 878건이 제품코드 110개에 흩어져 있다는 것은 코드 하나당 평균 여덟 건 가까이가 몰려 있다는 계산이 된다. 같은 코드 안의 기기들은 서로의 비교대상이 되기 쉬우니 사슬이 촘촘하게 얽힐 수밖에 없다. 그 사슬 어딘가에 리콜이 한 번 붙으면 뒤따라 들어오는 신청 전체의 위험 점수가 올라간다. 걸러내기와 연좌제의 경계가 그리 선명하지 않다.
그리고 AUC 0.76으로 돌아가야 한다. 이 정도 변별력은 집단 수준에서 심사 자원을 배분하는 데는 쓸 만하다. 신청 100건을 위험 순으로 줄 세워 위쪽부터 먼저 보게 만드는 용도라면 충분하다. 반면 신청 한 건의 운명을 가르는 잣대로는 얇다. 자원 배분의 오차는 다음 기기에서 만회되지만 반려 결정의 오차는 그 회사 한 곳이 통째로 뒤집어쓴다. 같은 0.76이 쓰임새에 따라 충분하기도 하고 부족하기도 한 이유다.
지난주에 다룬 결정과 겹쳐 읽으면 온도가 더 잘 느껴진다. 9월 17일 FDA는 방사선 CAD 소프트웨어를 510(k)에서 부분 면제해달라는 청원을 최종 기각했다(91 FR 58817). 이 분야는 아직 시판전 신고 없이 내보낼 만큼 예측 가능하지 않다는 판단이었다. 그 판단과 이번 논문은 사실 같은 곳을 가리킨다. 문제는 510(k)를 없애느냐 마느냐가 아니라 510(k)가 지금 제 몫을 하고 있느냐다.
FDA는 이미 AI를 쓰고 있다
논문의 제안이 현실과 얼마나 떨어져 있는지는 FDA의 최근 행보를 보면 가늠이 된다.
FDA는 2025년 6월 Elsa라는 생성형 AI 도구를 전 기관에 도입했고, 2026년 5월에는 Elsa 4.0을 내놨다. 40개가 넘는 신청·제출 데이터 시스템을 묶은 HALO와 연동되어 있고, 직원의 70% 이상이 쓰고 있으며 채택률이 가장 높은 곳이 의료기기를 담당하는 CDRH와 생물학적제제를 담당하는 CBER다. 2025년 12월에는 계획하고 추론하고 여러 단계를 실행하는 agentic AI를 시판전 심사, 시판후 감시, 실사에 쓰겠다고 발표했다. 직원이 선택해서 쓰는 도구이고 업계가 제출한 자료로 학습시키지 않는다는 단서가 붙었다.
동시에 정확성 문제도 보고됐다. 존재하지 않는 인용을 만들어내는 사례가 나왔고, 그래서 현재로서는 공식적인 규제 판단에는 쓰지 않는다는 선이 그어져 있다.
이 선이 이번 논문이 제안하는 것과 FDA가 지금 하는 것 사이의 거리다. 요약문을 정리하고 라벨을 비교하는 도구는 사람이 최종 판단을 하는 한 틀려도 되돌릴 수 있다. 반면 위험 점수 0.177을 넘었다는 이유로 신청을 반려하는 정책은 그 자체가 규제 결정이다. 규제 결정에는 설명이 따라붙고, 불복 절차가 따라붙고, 다툼이 생기면 그 설명이 밖에서 검증된다. 모델이 "비교대상 기기의 리콜 이력이 많아서"라고 답한다면 그 답변이 얼마나 버틸지는 별개의 문제다.
FDA가 이 간극을 모르는 것도 아니다. CDRH는 2026년 8월 생성형 AI 탑재 의료기기의 규제를 어떻게 할지 묻는 토론용 문서를 내고 의견을 받고 있다. 도켓 번호는 FDA-2026-N-7874, 마감은 10월 19일이다. Innolitics가 9월 21일 기준으로 집계한 바로는 96개 제출자가 107건, 개별 질문에 대한 답변 805개를 냈다. 입장을 보면 FDA의 틀을 받아들이되 수정을 요구한 비율이 87%, 원안 그대로 수용이 5%, 거부가 2%였다. 다만 이 집계는 업계 단체와 파운데이션 모델 개발사, 대형 의료기관이 아직 제출하지 않은 상태의 중간 스냅샷이라 표본이 한쪽으로 기울어 있다.
정리하면, 이 논문의 자동 반려 정책이 규제 실무에 그대로 들어갈 가능성은 낮다. 반려율을 두 배로 올리면서 그 증가분의 대부분을 무고한 기기가 지는 설계는 규제기관이 받아들이기 어려운 종류의 맞교환이고, 모델이 대는 근거가 신청자 자신이 통제할 수 없는 과거의 기록이라는 점도 걸린다. 그렇다고 이 연구가 헛것이냐 하면 그렇지 않다. 비교대상 기기의 리콜 이력이 미래 리콜을 가장 잘 예측한다는 발견은 자동 반려까지 가지 않아도 쓸 데가 있다. 심사 우선순위를 정하는 일, 즉 리콜 이력이 붙은 사슬을 타고 들어오는 신청을 심사관이 먼저 더 오래 들여다보게 만드는 일에는 법적 방어 부담이 거의 따라붙지 않는다. 그리고 이 쓰임새라면 AUC 0.76으로도 충분하다. 자동화의 야심을 걷어내고 남는 것이 그 정도인데, 남은 그 정도가 실은 지금 당장 쓸 수 있는 부분이다.
의료 AI 회사 쪽에서 가져갈 것도 여기서 나온다. 비교대상 기기를 고르는 일은 규제 실무에서 오랫동안 전략의 문제였다. 어떤 기기를 근거로 삼으면 심사가 빠른가, 어떤 기기를 잡으면 적응증을 넓게 쓸 수 있는가 같은 계산이다. 이 연구는 거기에 항목을 하나 더한다. 그 기기의 리콜 이력이 어떤가. FDA가 논문의 방식을 그대로 쓰지 않더라도, 심사관이 비교대상 기기의 전과를 먼저 들여다보기 시작하면 신청자가 체감하는 결과는 비슷해진다.
출처
- Zhalechian M, Saghafian S, Robles O. "Harmonizing Safety and Speed: A Human-Algorithm Approach to Enhance the FDA's Medical Device Clearance Policy." Management Science, 온라인 게재 2026-08-28. DOI: 10.1287/mnsc.2024.06477. 사전출판본 arXiv:2407.11823 (v1 2024-07-16, v4 2026-08-12)
- Chen WP, Teng WG, Kuo CB, et al. "Regulatory Insights From 27 Years of Artificial Intelligence/Machine Learning-Enabled Medical Device Recalls in the United States: Implications for Future Governance." JMIR Medical Informatics, 2025-07-11. DOI: 10.2196/67552
- FDA, Artificial Intelligence-Enabled Medical Device List
- FDA, "Medical Devices; Exemption From Premarket Notification: Radiology Computer-Aided Detection and/or Diagnosis Devices and Computer-Aided Triage and Notification Devices" (Final order), 91 FR 58817, 2026-09-17. Federal Register
- Medtronic, Inc. v. Lohr, 518 U.S. 470 (1996)
- Innolitics, "FDA Generative AI Device Public Comments Census" (Docket FDA-2026-N-7874, 2026-09-21 기준 집계)
- Hogan Lovells, "FDA says Agentic AI is used for premarket reviews, inspections, and more", 2025-12-09
- Medical Xpress, "AI could cut medical device recalls by nearly a third, study finds", 2026-09
- 데이너스, "뷰노 딥카스의 FDA NSE와 CMS NTAP 마감 하루 차이" (2026-07-04, 이 블로그 medical-ai 발행본). 딥카스 NSE 사유에 관한 서술은 국내 2차 보도에 근거한다.