Dainus

Copilot 채팅창 아래에는 오랫동안 모델 목록이 붙어 있었습니다. Anthropic 모델, OpenAI 모델, Google 모델이 줄줄이 있고, 사용자는 질문할 때마다 하나를 골라야 했습니다. 변수 이름 하나 바꾸는 데 가장 비싼 모델을 쓰자니 아깝고, 싼 모델에 까다로운 버그를 맡기자니 불안합니다. 결국 대부분은 손에 익은 모델 하나를 계속 쓰게 됩니다.
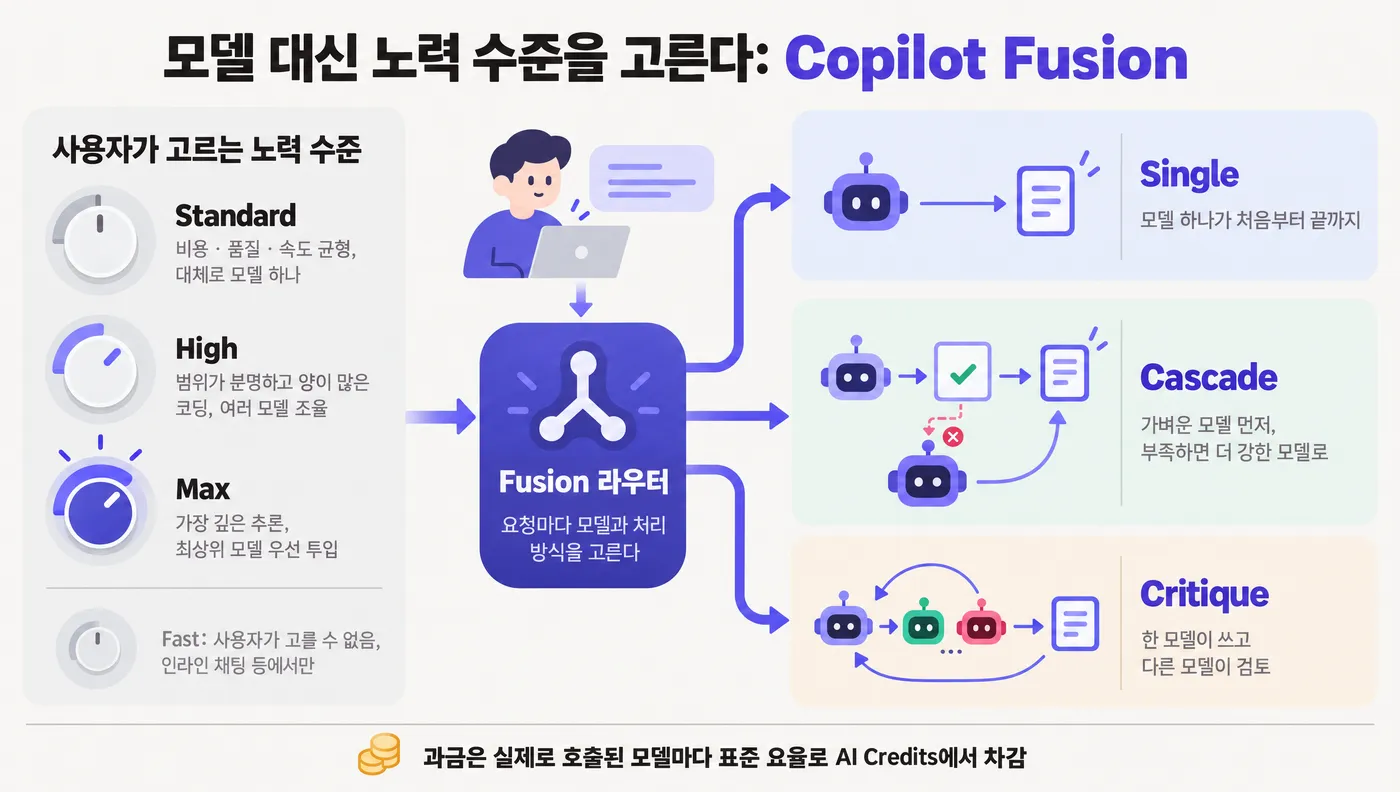
GitHub가 10월 28일 GitHub Universe 2026에서 정식 출시한 Copilot Fusion은 이 선택을 사용자에게서 가져갑니다. 모델 목록에서 Fusion을 고르고 Standard, High, Max 가운데 노력 수준만 정하면, 어떤 모델을 몇 개, 어떤 순서로 쓸지는 Copilot이 정합니다. 기능 하나가 추가된 것처럼 보이지만, 지난 6월 바뀐 과금 체계와 함께 보면 GitHub가 무엇을 노리는지가 더 분명해집니다. 공식 변경 기록과 문서를 따라 동작 방식, 비용, 그리고 아직 확인되지 않은 부분을 차례로 짚어봅니다.
모델 목록에 들어간 배차 담당자
Fusion은 모델 목록에 들어 있지만 그 자체로는 모델이 아닙니다. GitHub 문서는 Fusion을 "실행 시점에 모델을 고르고 조율하는 라우터"라고 설명합니다. 라우터는 들어온 일을 보고 어디로 보낼지 정하는 장치입니다. 택시 회사의 배차 담당자를 떠올리면 쉽습니다. 손님이 차종을 고르는 대신 "급해요" 또는 "짐이 많아요"라고 말하면, 배차 담당자가 그에 맞는 차를 보냅니다.
Fusion의 뿌리는 두 가지입니다. 하나는 Copilot에 원래 있던 Auto 모델 선택입니다. 요청마다 적당한 모델 하나를 자동으로 골라주는 기능이었습니다. 다른 하나는 9월부터 연구 프리뷰로 돌던 Project HydraFusion입니다. 여러 모델을 한 작업에 함께 투입하는 실험이었습니다. Fusion은 이 둘을 합친 결과물이고, 정식 출시와 함께 두 프리뷰를 대체했습니다. 프리뷰에서 Auto, HydraFusion, HydraFusion Max를 쓰던 사용자는 각각 Standard, High, Max로 자동으로 옮겨집니다. JetBrains IDE에서는 기존 Auto 옵션 자리를 Fusion이 그대로 차지했습니다.
쓸 수 있는 곳은 VS Code, GitHub Copilot 앱, Copilot CLI, JetBrains IDE입니다. 다른 도구는 "곧" 지원한다고만 밝혔습니다.
Single, Cascade, Critique 세 가지 처리 방식
Fusion이 일을 처리하는 방식은 세 가지입니다. 요청이 들어올 때마다 이 중 하나를 고르기 때문에, 한 대화 안에서도 방식이 섞일 수 있습니다.
Single은 가장 단순합니다. 모델 하나가 처음부터 끝까지 처리합니다. 함수 하나에 주석을 달거나 에러 메시지를 설명하는 정도의 일이라면 여러 모델을 부를 이유가 없습니다.
Cascade는 계단식입니다. 먼저 가볍고 싼 모델이 답을 만들고, 품질 검사가 그 답을 받아들일지 판정합니다. 통과하면 거기서 끝나고, 통과하지 못하면 더 강한 모델에게 넘깁니다. 병원 접수처를 생각하면 됩니다. 간단한 증상은 일반의가 보고, 일반의가 판단하기 어려우면 전문의에게 보냅니다. 처음부터 모든 환자를 전문의에게 보내지 않으니 평균 비용이 내려갑니다.
Critique는 초안과 검토를 나눕니다. 한 모델이 초안을 쓰면 다른 모델이 검토하고, 처음 모델이 그 의견을 반영해 고칩니다. 문서에 따르면 검토는 여러 모델이 동시에 할 수도 있습니다. 글쓴이와 편집자를 따로 두는 셈입니다. 같은 모델이 자기 답을 다시 보는 것보다 성향이 다른 모델이 보는 편이 놓친 부분을 잡을 가능성이 높다는 발상입니다.
노력 수준은 이 패턴을 얼마나 적극적으로 쓸지를 정하는 다이얼에 가깝습니다. 문서 기준으로 Standard는 비용과 품질, 속도의 균형을 맞추고 대체로 작업 하나에 모델 하나를 씁니다. High는 범위가 분명하지만 양이 많은 코딩 작업을 겨냥해 여러 모델을 조율하고, Max는 가장 깊은 추론이 필요한 일에 최상위 모델을 우선 투입합니다. 사용자가 고를 수 없는 Fast 단계도 있는데, VS Code의 인라인 채팅처럼 빠른 응답이 필요한 곳에서만 쓰입니다.
6월의 과금 개편과 겹쳐 보면
Fusion이 왜 지금 나왔는지는 과금 방식을 함께 봐야 이해됩니다. GitHub는 2026년 6월 1일부터 Copilot 과금 단위를 premium request에서 토큰 기반의 AI Credits로 바꿨습니다. premium request는 질문 한 번을 한 건으로 세는 방식이었습니다. 입력, 출력, 캐시 토큰을 각 모델의 공개 API 요율로 계산해 크레딧을 차감하는 방식입니다. 코드 자동완성과 Next Edit Suggestions(커서 다음에 고칠 곳을 미리 제안하는 기능)는 여전히 차감 없이 쓸 수 있지만, 채팅과 에이전트 작업은 쓴 만큼 줄어듭니다.
GitHub가 4월 발표문에서 밝힌 이유는 솔직했습니다. "짧은 채팅 질문 하나와 몇 시간짜리 자율 코딩 세션의 비용이 사용자에게 똑같다"며 기존 방식은 더 이상 지속할 수 없다고 적었습니다. 개편 직후 개발자 커뮤니티에는 에이전트를 많이 쓰면 크레딧이 생각보다 빨리 닳는다는 불만이 적지 않았습니다.
이 상황에서 모델 선택은 곧 비용 선택이 됩니다. 요청 횟수로 셀 때는 어떤 모델을 쓰든 체감 비용 차이가 크지 않았지만, 토큰 단가로 셀 때는 모델을 잘못 고르면 지갑이 바로 반응합니다. 그런데 대부분의 개발자는 작업마다 모델 단가를 따져가며 고르지 않습니다. Fusion은 바로 그 판단을 대신해 줍니다. 쉬운 일은 싼 모델에 맡기고 어려운 일만 비싼 모델로 올려 보내면, 같은 크레딧으로 더 많은 일을 할 수 있다는 계산입니다.
Fusion 자체에 붙는 별도 요금은 없습니다. 실제로 호출된 모델마다 각자의 표준 요율로 과금됩니다. 유료 요금제 사용자는 2026년 11월 30일까지 Fusion으로 쓴 모델 비용을 30% 할인받습니다. 기업 쪽에서는 같은 날 GitHub Enterprise 고객이 별도 Copilot 구독 없이 Copilot 기능 전체를 쓰고 사용한 AI 크레딧만큼 내는 방식도 발표됐습니다. 쓴 만큼 내는 구조가 넓어질수록 라우터의 쓸모도 커집니다.
절반의 비용이라는 숫자 읽는 법
GitHub가 내세운 숫자는 이렇습니다. Artificial Analysis Coding Agent Index에서 Fusion Max가 60점을 받았고, 이는 Opus 5.5 Max를 쓴 Claude Code와 2점 이내 차이라고 합니다. 그러면서 작업당 평균 API 비용과 토큰 사용량은 약 절반, 작업당 시간은 약 40% 짧았다고 밝혔습니다. AT&T의 한 수석 엔지니어는 Fusion Standard가 사내 전반의 토큰 효율을 높였다는 소감을 변경 기록에 남겼습니다.
숫자는 인상적이지만 몇 가지를 염두에 두고 읽어야 합니다.
첫째, 이 수치는 GitHub가 직접 발표한 것이고, 아직 제3자가 같은 조건에서 재현한 결과는 확인되지 않습니다. 비교 대상도 Claude Code라는 특정 도구와 특정 설정 하나입니다.
둘째, "절반의 비용"은 Max 단계를 최상위 단일 모델과 견준 결과입니다. 평소 Standard로 쓰던 사용자가 Max로 올리면 오히려 비용이 늘 수 있습니다. GitHub 문서도 High와 Max는 여러 모델을 쓸 수 있어 Standard보다 크레딧을 더 소모할 수 있다고 적고 있습니다. Critique 패턴만 해도 초안, 검토, 수정으로 모델 호출이 최소 세 번 일어납니다. 단일 모델이라면 한 번이면 끝날 일입니다.
셋째, 시간도 마찬가지입니다. 문서는 Cascade와 Critique가 Single보다 오래 걸린다고 명시합니다. 평균 시간이 줄었다는 것은 쉬운 작업을 빠르게 끝낸 덕분이지, 모든 요청이 빨라진다는 뜻이 아닙니다.
맡기기 전에 알아둘 제약
문서를 끝까지 읽으면 실무에서 부딪힐 만한 제약이 몇 가지 보입니다.
가장 눈여겨볼 부분은 버려진 초안의 흔적입니다. Cascade에서 약한 모델의 초안이 품질 검사를 통과하지 못해 강한 모델로 넘어가도, 그 초안이 이미 파일을 수정했다면 그 수정은 자동으로 되돌려지지 않습니다. GitHub는 커밋 전에 변경 내용을 확인하라고 안내합니다. 에이전트 모드로 파일을 직접 고치게 할 때라면 diff를 한 번 더 들여다봐야 합니다.
어떤 모델이 일했는지는 기본 화면에 드러나지 않습니다. 응답 아래의 노력 수준 이름에 마우스를 올려야 사용된 모델 목록이 보이고, 중간 단계의 진행 상황은 볼 수 있어도 최종 응답만 화면에 남습니다. 결과가 마음에 들지 않을 때 어느 모델 탓인지 따지기가 예전보다 번거로워졌습니다.
컨텍스트 창도 따로 없습니다. 각 단계는 그 단계를 맡은 모델의 한도 안에서 돌고, 화면에 표시되는 값은 Fusion이 쓰는 모델 가운데 가장 작은 한도를 기준으로 한 보수적인 수치입니다. 큰 저장소를 통째로 넣어야 하는 작업이라면 특정 모델을 직접 고르는 편이 나을 수 있습니다.
Fusion은 서브에이전트도 띄우지 않습니다. 서브에이전트는 큰 작업을 쪼개 하위 에이전트에게 나눠 맡기는 방식인데, Fusion은 모델을 바꿔 가며 쓸 뿐 일을 여러 갈래로 나눠 병렬로 돌리지는 않습니다.
요금제에 따라 쓸 수 있는 단계도 다릅니다. Standard는 Free와 Student를 포함한 모든 요금제에서 쓸 수 있습니다. High는 Pro+ 이상, Max는 Max, Business, Enterprise 요금제에서만 열립니다. 월 10달러짜리 Pro 사용자에게는 Standard만 열려 있는 셈입니다.
조직 입장에서 달라지는 것
개인 개발자에게 Fusion은 편의 기능이지만, 조직 관리자에게는 통제 수단이기도 합니다. Fusion은 조직과 엔터프라이즈 정책에서 허용한 모델만 씁니다. 관리자는 Fusion이 어떤 모델 후보 중에서 고르는지 볼 수 있고, 특정 모델을 다른 용도에서는 그대로 두면서 Fusion에서만 빼버릴 수 있습니다. 조직 전체의 기본 모델을 Fusion의 특정 노력 수준으로 지정하는 것도 가능합니다. 데이터 보관 지역 요건이나 FedRAMP(미국 연방 정부의 클라우드 보안 인증) 때문에 막힌 모델도 자동으로 후보에서 빠집니다.
모델을 하나씩 승인하고 직원마다 무엇을 쓰라고 안내하던 방식에서, "허용 목록은 이것, 기본 노력 수준은 Standard"로 정해두면 나머지는 Fusion이 알아서 하는 방식으로 관리 단위가 바뀝니다. 비용 관리 측면에서도 사람마다 제각각 비싼 모델을 고르는 상황보다 예측이 쉬워집니다.
Fusion이 덜어준 일과 남긴 일
Copilot Fusion이 바꾼 것은 모델의 성능보다 모델을 고르는 방식입니다. 출발점은 6월의 과금 개편입니다. 쓴 만큼 내는 구조에서는 "어떤 모델을 쓸까"가 곧 "얼마를 쓸까"가 되는데, GitHub는 그 판단을 사용자에게 맡기기보다 라우터로 흡수하는 쪽을 택했습니다.
다만 GitHub가 제시한 성능과 비용 수치는 아직 GitHub의 주장입니다. Max가 최상위 단일 모델보다 싸다는 말이 Standard보다 싸다는 뜻은 아니고, 여러 모델이 오갈수록 시간이 길어지며 버려진 초안이 남긴 파일 수정은 사람이 직접 확인해야 합니다. 노력 수준 다이얼 하나로 모델 선택의 수고는 덜었지만, 그 다이얼을 어디에 둘지와 결과를 어떻게 검토할지는 여전히 개발자의 몫으로 남아 있습니다.