Dainus

11월 4일 JAMA Network Open에 생성형 AI 산모 챗봇 Rosie의 무작위 임상시험 결과가 실렸다. 임신부와 출산 6개월 이내 산모 400명을 12개월 동안 추적했다. 챗봇을 받은 쪽은 질문을 한 사람당 중앙값 119개 던졌지만, 매달 그림책을 받은 대조군과 비교해 불안과 우울 점수에 차이가 없었다. 만족도와 사용량은 높고 임상 결과는 움직이지 않은 이 시험은, FDA가 생성형 AI 의료기기에 어떤 근거를 요구할지 놓고 의견을 모은 직후에 나왔다.
챗봇 대 그림책, 12개월
논문 제목은 「Generative Artificial Intelligence and Maternal Health Outcomes in Pregnant and Postpartum Individuals」다. 메릴랜드대 공중보건대학과 컴퓨터과학과, 미국 국립보건원(NIH) 산하 국립간호연구소(NINR)가 함께 했고, NIH 국립소수자보건·건강격차연구소(NIMHD)의 연구비로 진행됐다. 등록 번호는 NCT06053515다.
참가자는 미국 49개 주와 워싱턴 DC에서 온라인으로 모았다. 조건은 영어를 쓰고, 14세 이상이며, 임신 중이거나 생후 6개월 미만 아기를 키우고, 스스로를 인종·민족 소수자로 밝힌 사람이다. 2023년 10월부터 2024년 12월까지 400명을 받아 200명씩 나눴고, 12개월 추적은 2025년 12월에 끝났다. 평균 나이는 32.6세, 절반은 등록 당시 이미 아기를 키우고 있었다.
대조군 설계가 이 시험을 읽는 첫 번째 열쇠다. 대조군은 아무것도 받지 않은 것이 아니라 12개월 동안 매달 아기용 보드북 한 권을 받았다. 연구진은 이를 "능동 대조"라고 불렀다. 아무 개입도 없는 대기 대조와 견주면 챗봇의 효과가 부풀려지기 쉽다. 연구에 참여하고 있다는 느낌, 누군가 나를 챙긴다는 감각만으로도 점수가 좋아질 수 있어서다. 그림책은 그 몫을 양쪽에 똑같이 나눠 주는 장치다.
주요 결과는 12개월 시점의 불안과 우울이었다. 불안은 GAD-7(0~21점), 우울은 PHQ-9(0~27점)이라는 자가 설문으로 쟀다. 둘 다 진료실에서 선별 검사로 널리 쓰는 도구다. 부차 결과로는 응급실 방문, 임신 관련 합병증, 산후 검진 수검, 효과적인 피임, 수면 시간을 봤다. 380명이 12개월 설문을 마쳤거나 12개월 결과를 하나 이상 남겼다.
신뢰구간이 0을 넉넉히 품었다
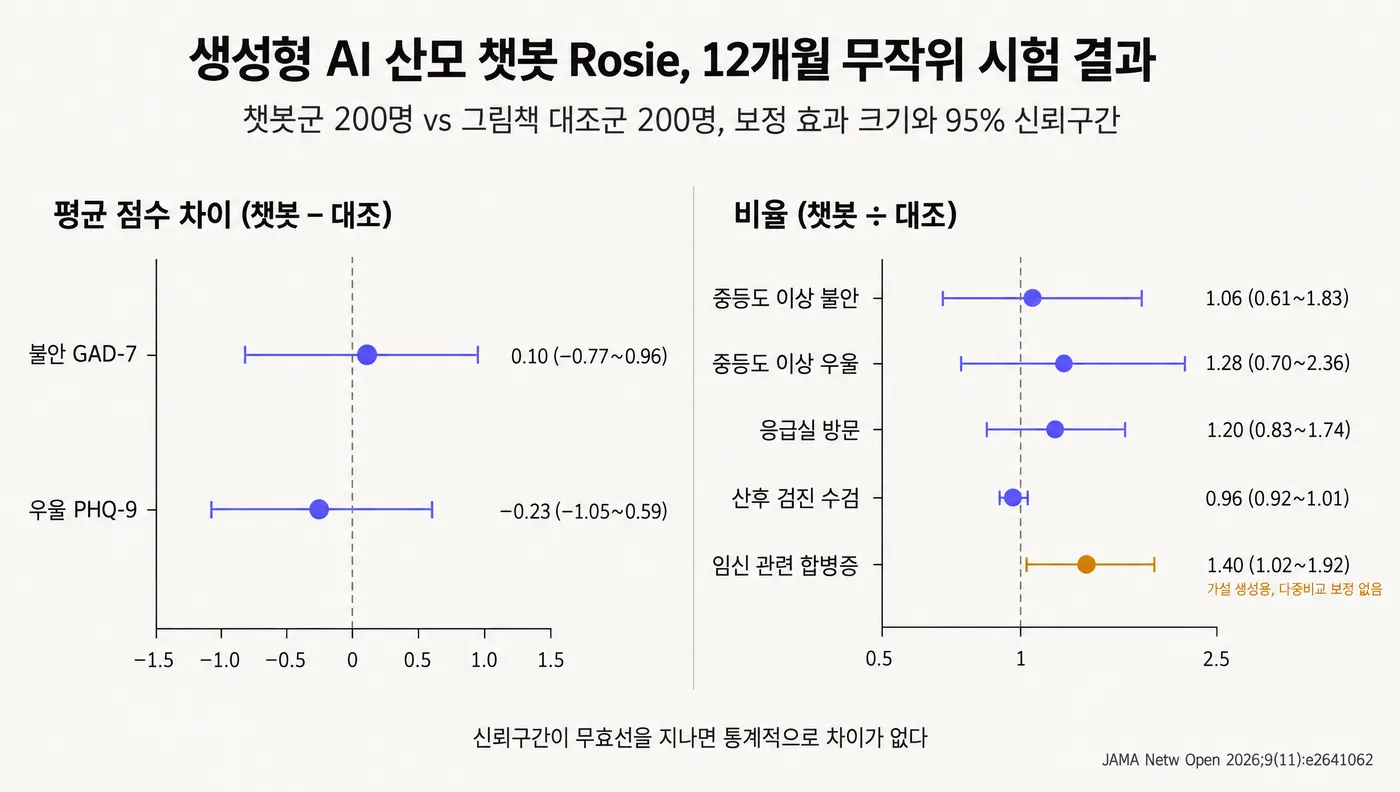
결과는 깔끔하게 "차이 없음"이었다. 보정한 12개월 GAD-7 평균 차이(챗봇군에서 대조군을 뺀 값)는 0.10점, 95% 신뢰구간은 −0.77~0.96이었다. PHQ-9는 −0.23점, 신뢰구간 −1.05~0.59였다. 중등도 이상 불안의 유병비는 1.06(0.61~1.83), 중등도 이상 우울은 1.28(0.70~2.36)이었다.
숫자를 읽는 요령은 이렇다. 신뢰구간이 0(비율이면 1)을 끼고 있으면 통계적으로 차이를 말할 수 없다. 더 눈여겨볼 대목은 구간의 폭이다. PHQ-9 신뢰구간의 아래 끝이 −1.05점이다. 27점 척도에서 챗봇이 줄여 줄 수 있었던 우울 점수가 이 시험의 불확실성을 다 감안해도 1점 남짓이었다는 뜻이다. 효과가 있었는데 표본이 작아 못 잡아낸 것이라기보다, 있었다 해도 작은 효과였다고 읽는 편이 자연스럽다. 연구진은 탈락 30%를 감안해 중간 크기의 차이를 검정력 80%로 잡도록 400명을 설계했다.
부차 결과도 대부분 비슷했다. 응급실 방문 비율비는 1.20(0.83~1.74), 산후 검진 수검은 0.96(0.92~1.01), 효과적인 피임은 1.13(0.96~1.32), 수면 시간 차이는 0.04시간이었다.
하나가 튀었다. 등록 당시 임신 중이던 188명만 놓고 본 임신 관련 합병증 비율비가 보정 분석에서 1.40(1.02~1.92)으로 챗봇군에서 더 높게 나왔다. 보정 전 값은 1.20(0.84~1.72)이었고, 종단 분석에서는 유의하지 않았다. 연구진은 다중비교 보정을 하지 않았다고 밝히고 이 결과를 "가설 생성용"으로 분류했다. 이 숫자 하나로 챗봇이 합병증을 늘렸다고 단정하기는 어렵다. 챗봇과 이야기하다 증상을 더 일찍 알아채고 더 많이 보고했을 가능성처럼 다른 설명도 열려 있다. 다만 다음 시험에서 미리 정한 결과로 따로 확인해야 할 신호인 것은 맞다.
많이 묻고, 만족했다
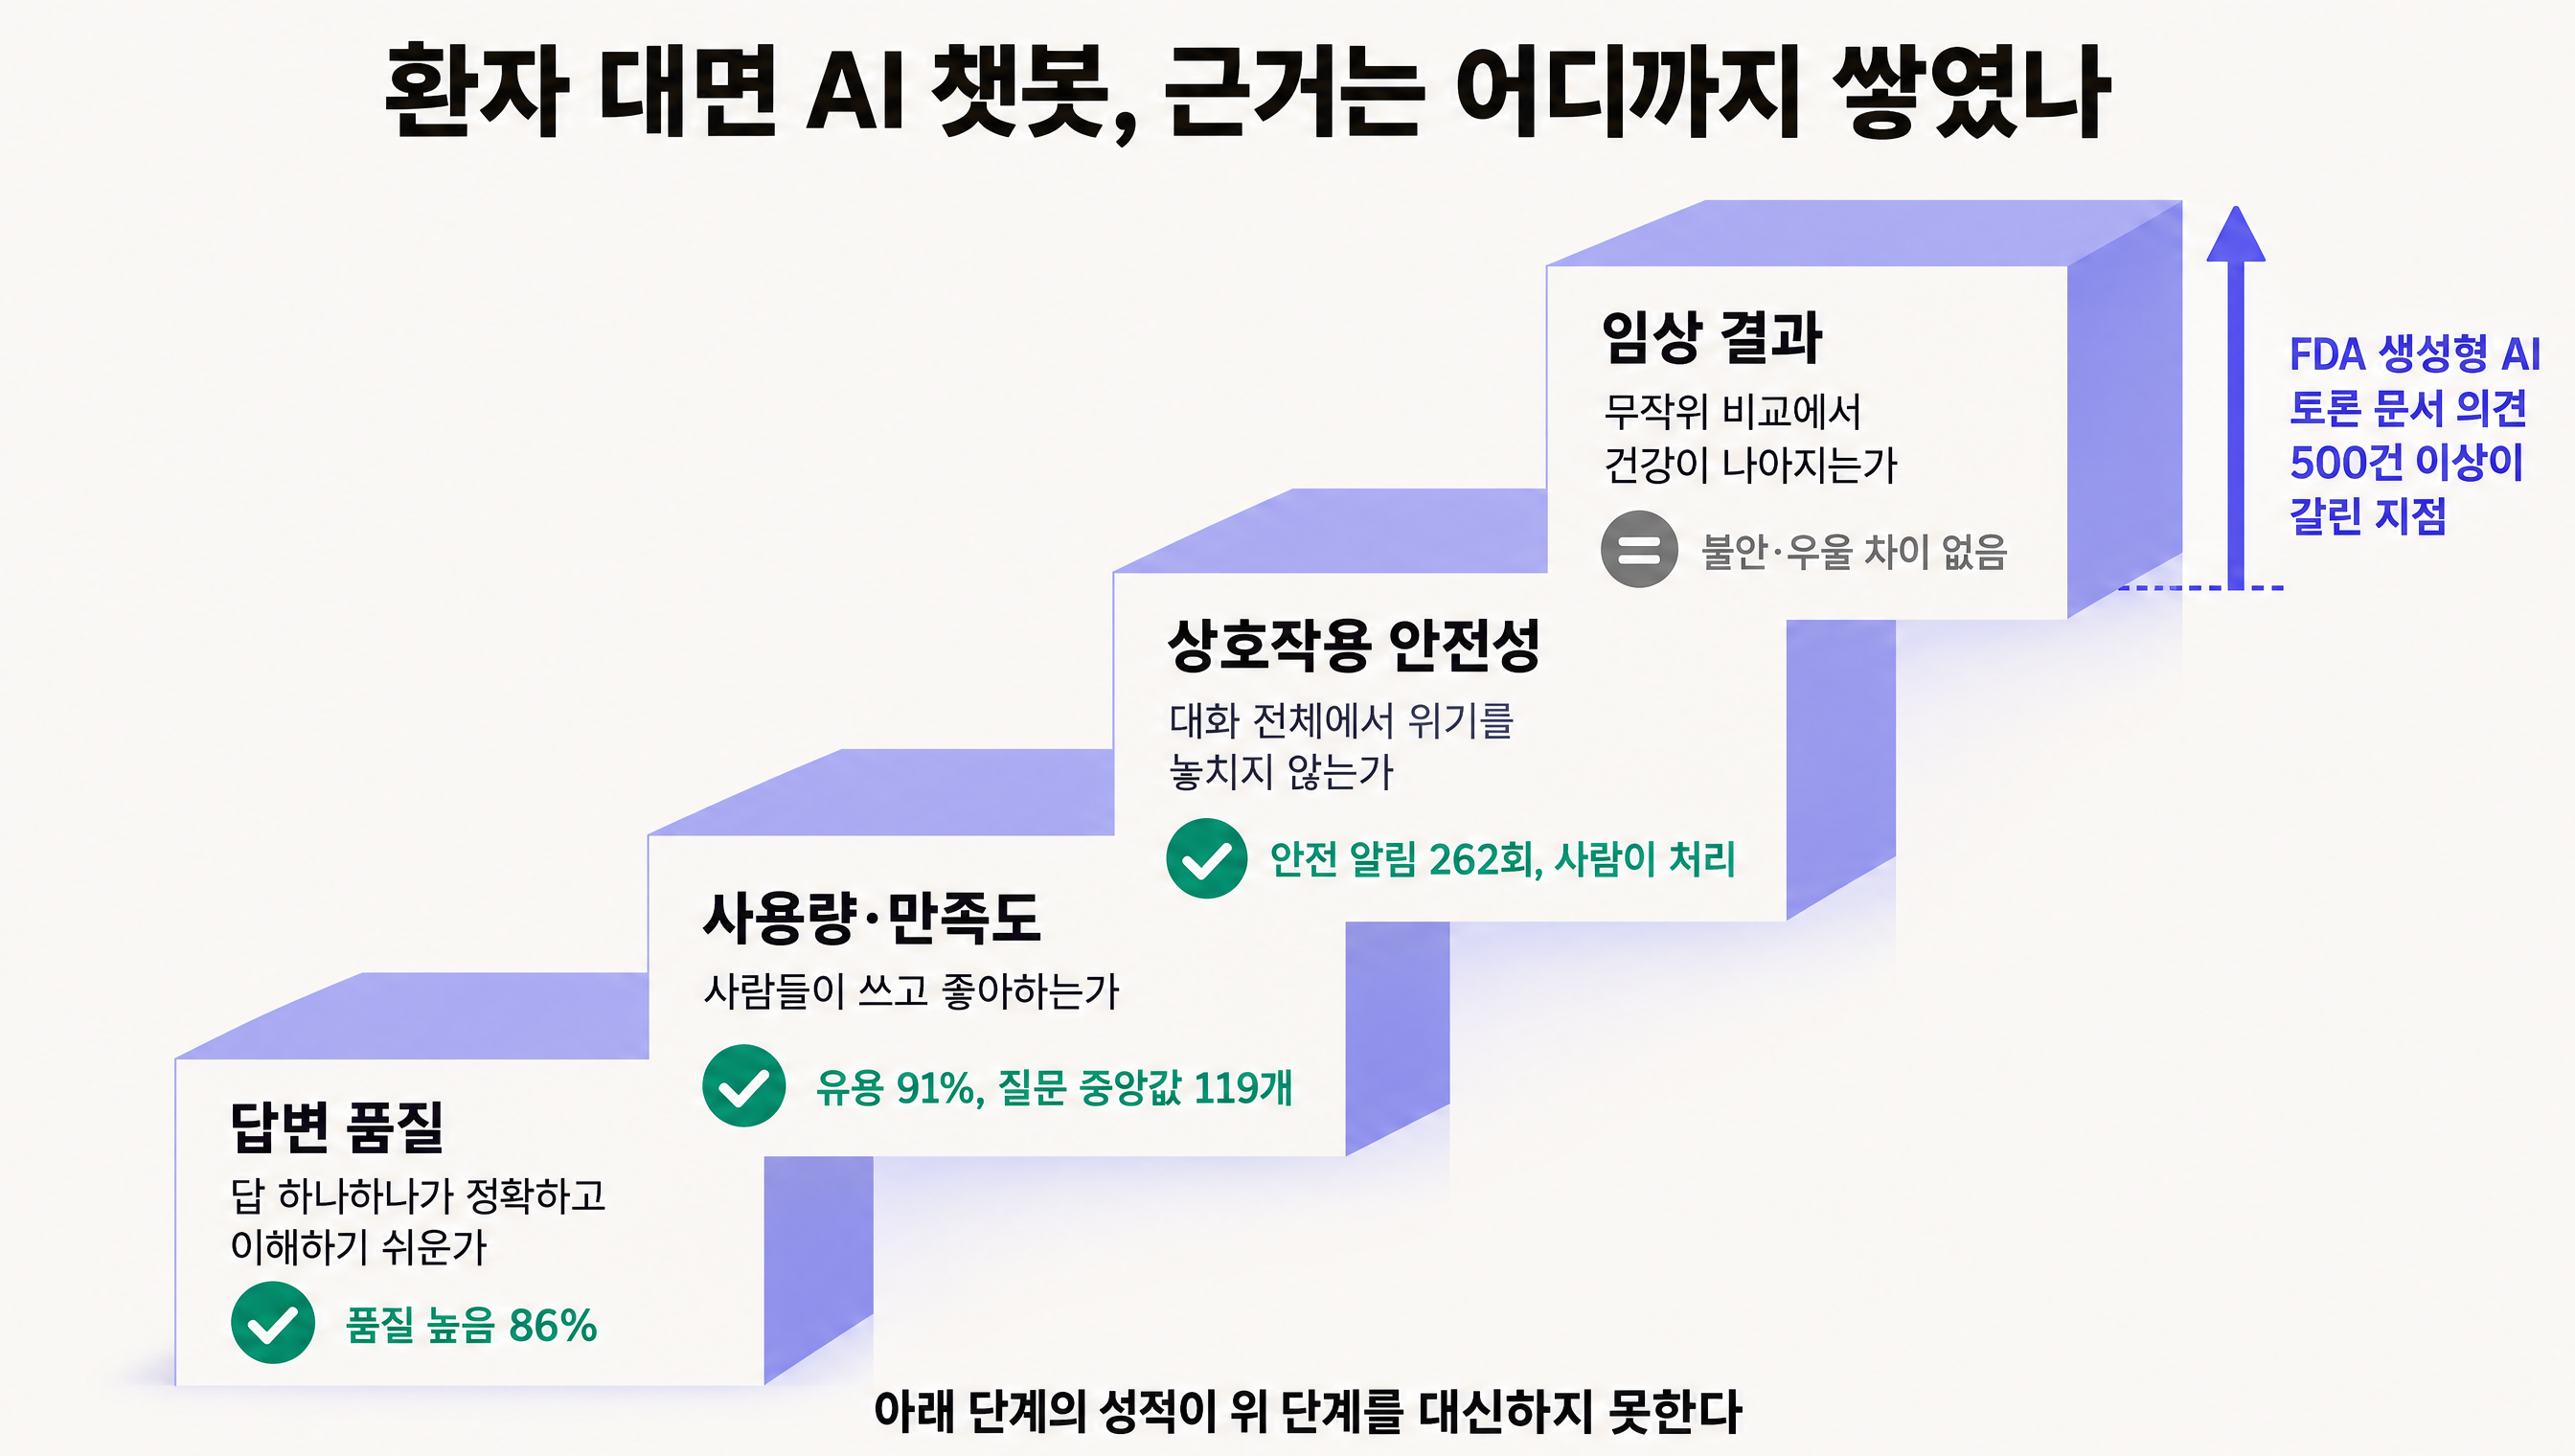
결과가 밋밋하다고 해서 아무도 쓰지 않은 챗봇은 아니었다. 챗봇군 중 187명(98.4%)이 한 번 이상 질문했고, 한 사람이 던진 질문 수의 중앙값은 119개였다. 사분위 범위는 47~222개다. 중앙값만 1년으로 나눠도 사흘에 한 번꼴로 질문한 셈이다.
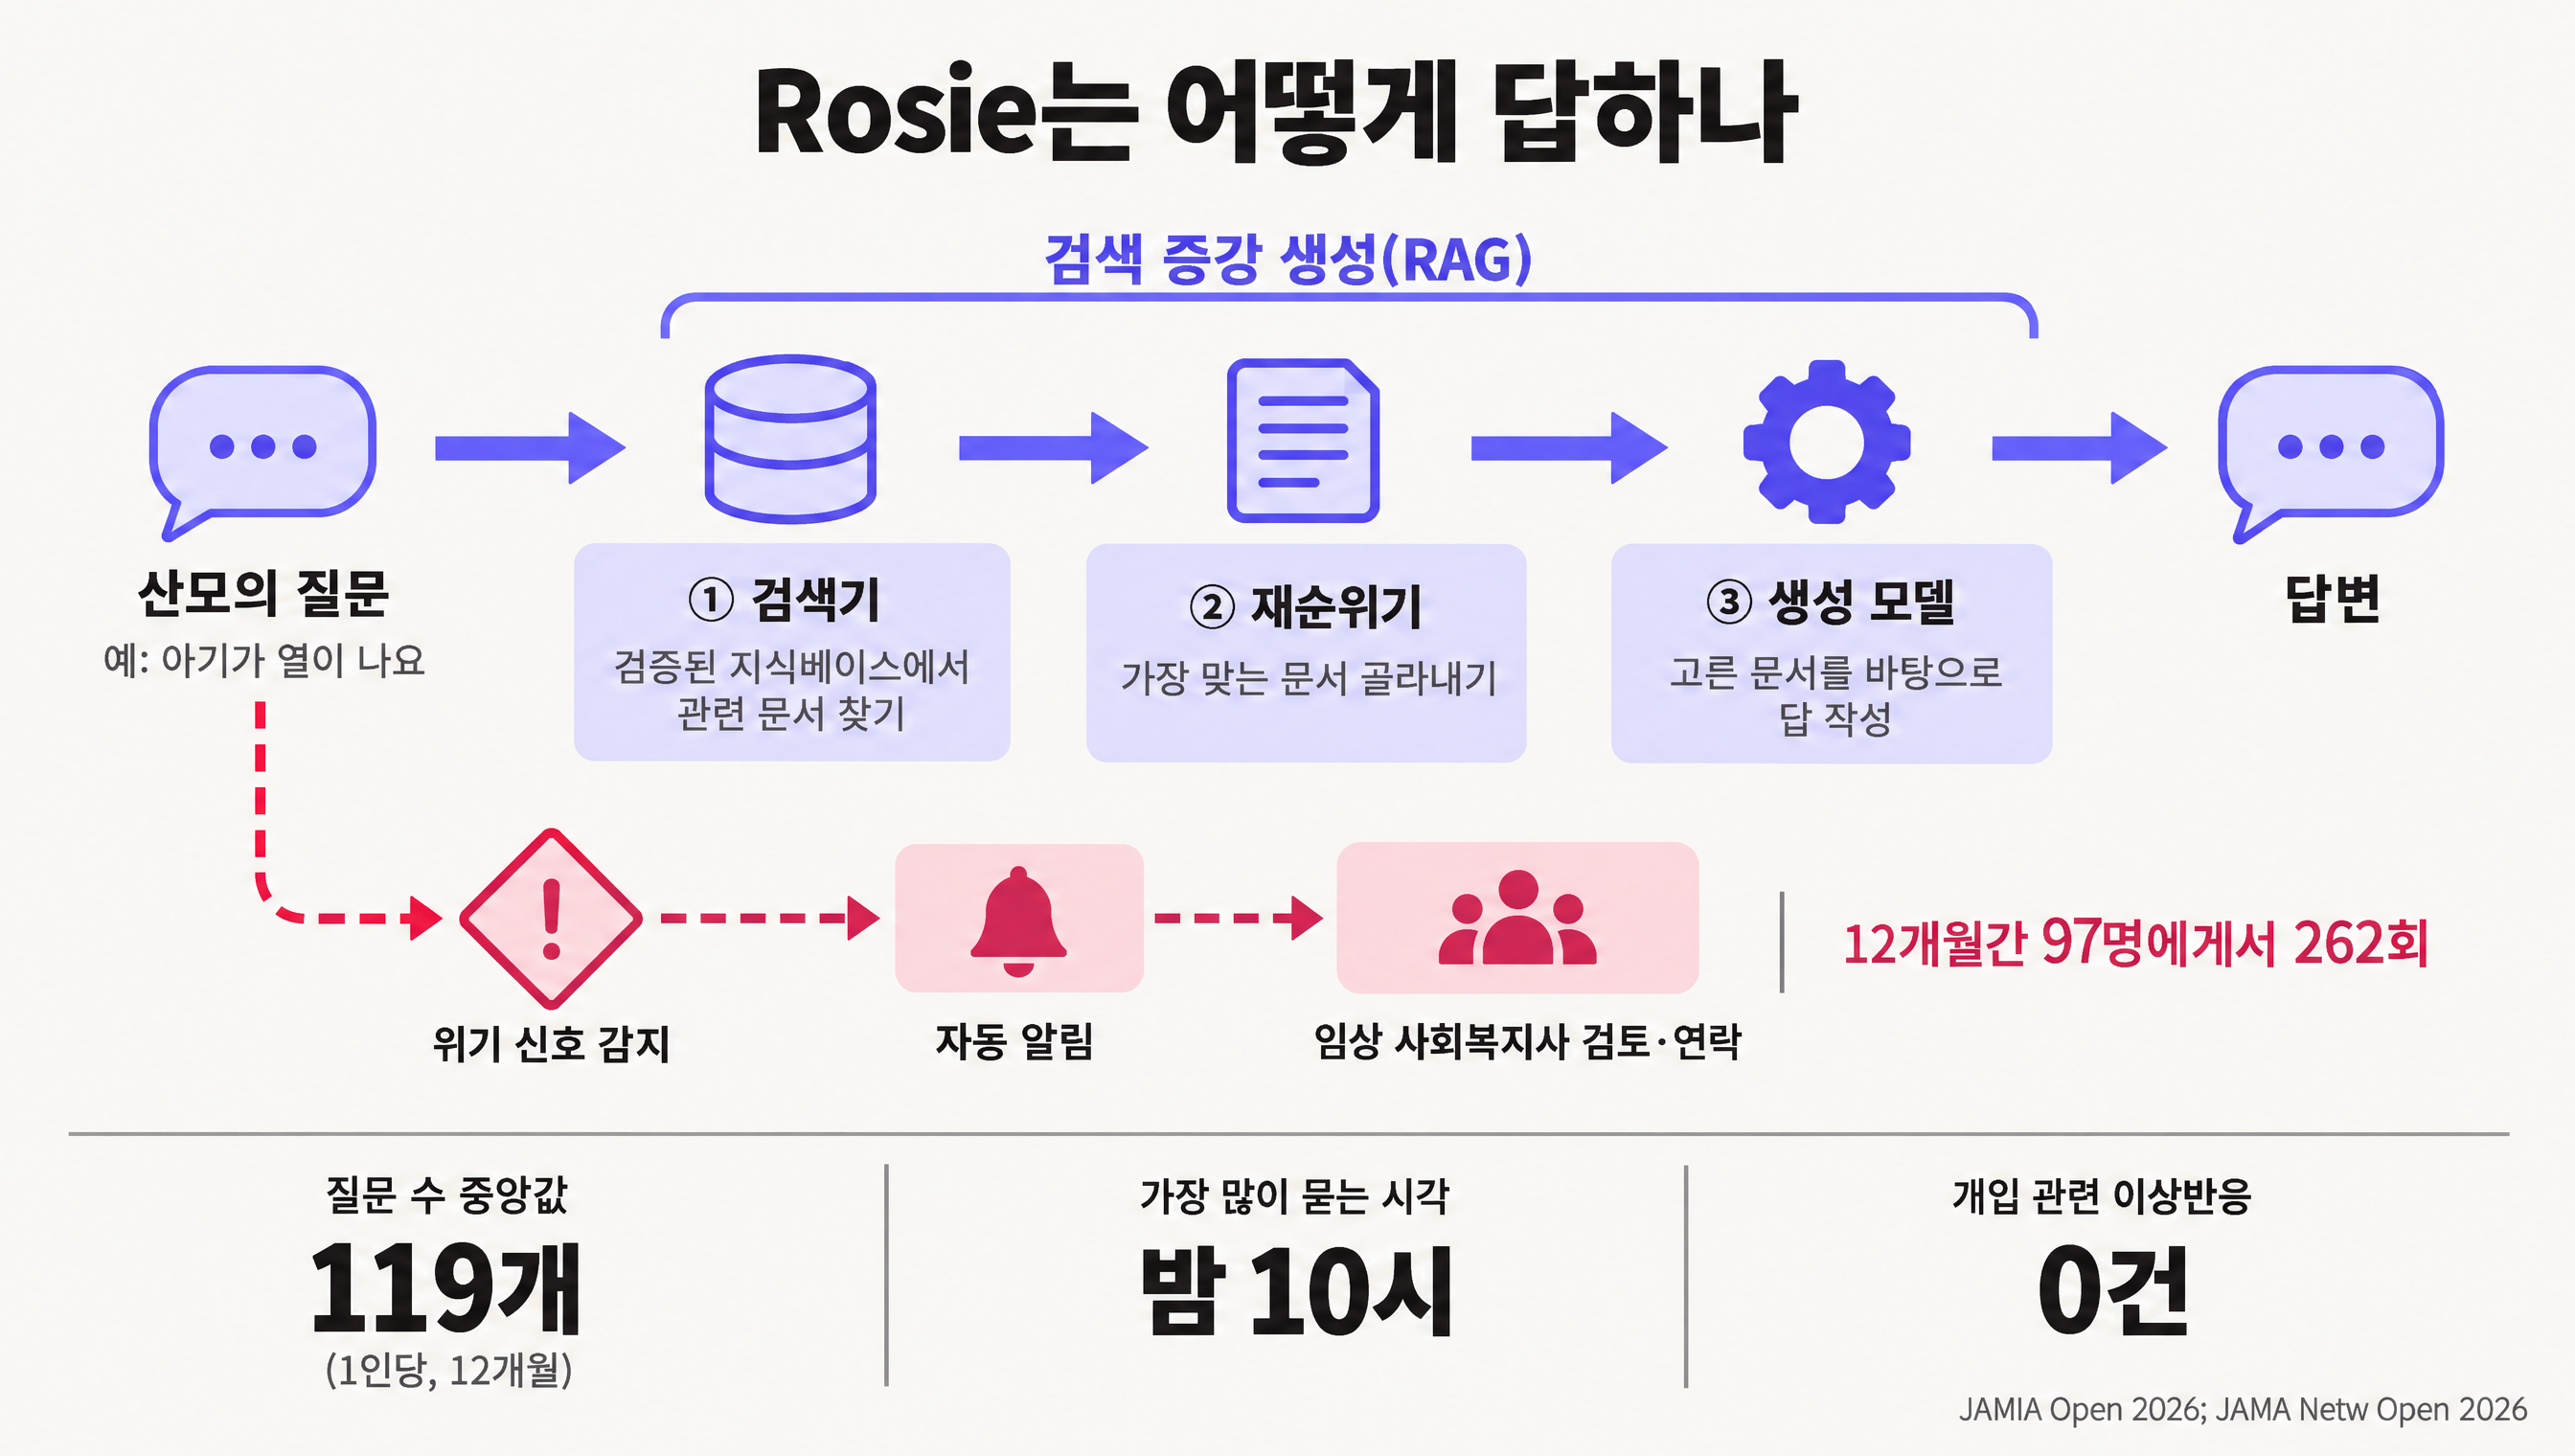
Rosie가 어떻게 생겼는지는 같은 연구진이 2026년 1월 JAMIA Open에 따로 정리했다. 검색기(retriever), 재순위기(re-ranker), 생성 모델로 이어지는 3단계 구조다. 사용자가 질문하면 먼저 검증된 지식베이스에서 관련 문서를 찾고, 그중 가장 맞는 것을 다시 고른 뒤, 생성 모델이 그 내용을 바탕으로 답을 쓴다. 흔히 검색 증강 생성(RAG)이라 부르는 방식이다. 모델이 기억에 의존해 답을 지어내는 대신 정해 둔 자료 안에서 답하게 만들어, 근거 없는 답(환각)을 줄이려는 설계다. 초기 파일럿(2024년, 29명)에서는 앱이 자주 멈추고 15명 중 12명이 일부 답변에 불만을 나타냈는데, 연구진은 RAG를 붙이고 지식베이스를 늘린 뒤 평가가 꾸준히 올랐다고 적었다.
사용 기록도 공개돼 있다. 2023년 10월부터 2025년 4월까지 197명이 질문 30,188건을 보냈다. 하루 평균 2.73건이었고 질문이 가장 몰린 시각은 밤 10시였다. 많이 물은 주제는 수유, 발달 단계, 열 같은 증상, 출산 준비였다. 6개월 시점 중간 설문에 응한 84명 중 86%가 답변 품질이 높다고, 91%가 유용하다고, 95%가 이해하기 쉽다고 답했다.
안전장치는 사람이 맡았다. 심한 고통, 자해 가능성, 심각한 산후 증상 같은 신호가 담긴 메시지가 들어오면 자동 알림이 울리고, 임상 사회복지사가 내용을 검토해 참가자에게 연락하고 위기 자원을 안내했다. 12개월 동안 알림은 97명에게서 262회 울렸다. 두 군 모두 개입과 관련된 이상반응은 보고되지 않았다.
정보는 불안을 낮추지 못했다
밤 10시에 아기가 열이 나는지 묻는 산모에게 즉시 정확한 답을 주는 일은 분명 쓸모가 있다. 그런데 그 쓸모가 1년 뒤 불안 점수로 이어지지 않았다. 연구진이 내놓은 설명은 두 갈래다.
첫째, 주산기 정신건강은 정보 부족만의 문제가 아니라는 것이다. 연구진은 구조적 스트레스, 돌봄 부담, 경제적 압박, 사회적 지지, 진료 접근성을 꼽았다. 챗봇이 수유 자세를 정확히 알려 줘도 밤샘 육아와 생활비 걱정은 그대로 남는다. 연구진은 결론에서 이런 도구가 "단독 개입보다 보조 도구로 자리 잡는 편이 나을 수 있다"고 적었다.
둘째, 그림책 대조군이 차이를 좁혔을 수 있다. 매달 집으로 오는 책과 필요할 때 연구진에게 연락할 수 있는 통로가 대조군에게도 있었다. 이 점은 거꾸로 읽으면 시험의 장점이다. 챗봇의 효과를 "무언가를 받는다"는 효과와 갈라냈기 때문이다.
비교할 만한 시험이 있다. 2025년 3월 NEJM AI에 실린 다트머스대의 Therabot 시험은 우울·불안 증상이 있는 성인 210명을 4주 동안 생성형 AI 치료 챗봇과 대기 대조로 나눴고, PHQ-9가 챗봇군에서 6.13점, 대기군에서 2.63점 줄었다. 두 시험은 겨냥한 것부터 다르다. Therabot은 증상이 있는 사람을 치료하려 만든 챗봇이고, Rosie는 정보를 주는 챗봇이며 참가자의 기준 점수도 높지 않았다. 대조군도 대기 대조와 능동 대조로 갈린다. 그래도 둘을 나란히 놓으면 한 가지는 보인다. 생성형 AI 챗봇의 임상 효과는 "챗봇이냐 아니냐"로 정해지지 않는다. 무엇을 하도록 설계했는지, 누구에게 줬는지, 무엇과 비교했는지에 따라 같은 기술이 전혀 다른 성적표를 받는다.
Rosie 연구진의 앞선 파일럿 두 편도 같은 방향을 가리켰다. 2024년 영어판 29명, 2026년 10월 스페인어판 30명 시험 모두 챗봇군 안에서는 점수가 내려갔지만 대조군과의 차이는 유의하지 않았다. 작은 시험에서 보이던 "군내 개선"이 400명 시험에서 사라진 셈이다. 군내 변화만 보고 효과를 말하는 디지털 헬스 연구가 아직 많다는 점을 생각하면, 이 연구진이 끝까지 대조군과 견준 것은 짚어 둘 만하다.
FDA 의견 500건과 겹쳐 읽기
시점이 공교롭다. FDA 의료기기·방사선보건센터(CDRH)는 지난 8월 생성형 AI 의료기기 규제 방향을 묻는 토론 문서를 냈고(이 지면에서 8월 24일 다뤘다), 10월 중순 마감된 의견수렴에 500건 넘는 의견이 들어왔다. 11월 3일 MedTech Dive와 RAPS가 그 내용을 정리했는데, Rosie 같은 환자 대면 정보 챗봇을 둘러싼 입장이 정확히 갈렸다.
한쪽 끝에 스마트링 회사 Oura가 있다. Oura는 사용자에게 "정보를 주되 행동을 지시하지 않는" 출력을 내는 기능은 의료기기로 보지 말거나 집행재량(규제 권한은 있지만 당분간 행사하지 않는 것)으로 다뤄 달라고 했다. FDA가 증상 확인 앱을 다루는 방식에 빗댔다. 혈압 측정값을 보고 고혈압 가능성을 언급하며 의사와 상의하라고 권하는 LLM을 예로 들었다. 업계 단체 AdvaMed와 MDMA는 생성형 AI가 들어갔다는 이유만으로 새로운 평가 틀을 씌우지 말고 기존 체계를 쓰자고 했다.
반대편에는 근거를 더 요구하는 목소리가 있다. 만성질환 청년 단체 Generation Patient는 시판 전 근거를 시판 후 감시로 바꾸면 위해의 부담이 환자에게 넘어간다며, AI 동반자(컴패니언) 도구는 웰니스 면제에서 빼라고 요구했다. FDA의 일반 웰니스 면제는 건강한 생활을 돕는다고만 말하는 저위험 제품을 심사 대상에서 빼 주는 정책이다. 스탠퍼드 정신건강혁신연구실의 니나 바산 교수는 라벨에 적힌 용도만이 아니라 "합리적으로 예견 가능한 사용"까지 시험하라고 했다. 예일대 연구진은 환자 대면 기기는 "고립된 출력이 아니라 임상적 상호작용"으로 검증해야 한다고 썼다.
Rosie 시험은 이 논쟁에 실제 데이터를 하나 얹는다. Rosie의 출력은 Oura가 말한 범주에 가깝다. 정보를 주고, 위급하면 사람에게 넘기고, 처방하지 않는다. 답변 하나하나를 떼어 보면 품질 평가는 좋았다. 그런데 1년 동안 주고받은 대화를 통째로 놓고 사람의 상태를 재자 차이가 없었다. 예일대 의견이 말한 "출력이 아닌 상호작용 단위의 검증"이 무엇을 드러내는지 보여 준 사례다.
이 결과가 어느 한쪽 손을 들어 주지는 않는다. 정보 제공 챗봇 쪽에서는 "해를 끼쳤다는 증거도 없지 않느냐"고 말할 수 있다. 실제로 안전 알림 262회가 사람에게 넘어갔고 개입 관련 이상반응은 없었다. 근거를 요구하는 쪽은 "만족도가 임상 결과를 대신하지 못한다는 증거"로 읽을 것이다. 다만 Rosie의 안전 기록에는 단서가 붙는다. 위기 신호를 사회복지사가 받아 처리하는 구조였다. 연구진도 이 점이 완전 자동 챗봇에 결과를 일반화하기 어렵게 만든다고 적었다. 규제기관 입장에서 보면 이 시험의 안전성은 챗봇과 사람을 합친 시스템의 안전성이다.
사용 기록이 결과를 대신하지 못한다
지난달 이 지면에서 다룬 OpenEvidence 분석은 의사들이 AI에 던진 질문 2억 7,100만 건을 셌지만 답이 맞았는지는 재지 않았다. 구글 AMIE의 Lancet 전향 연구는 환자 98명 앞에서 안전 중단 0건을 보였지만 무작위 비교는 아니었다. Rosie는 그보다 한 걸음 더 나가 무작위 배정과 능동 대조, 12개월 추적을 갖췄고, 그래서 "효과 없음"이라는 답을 받았다. 의료 AI 업계가 지금까지 쌓은 사용량과 만족도 지표가 임상 결과와 얼마나 거리가 있는지, 이 정도 설계를 갖춰야 비로소 드러난다.
국내에도 같은 질문이 온다. 식약처는 지난 4월 숨빗AI의 흉부 X선 판독문 생성 AI를 세계 처음으로 생성형 AI 의료기기로 허가했다. 다만 그 제품은 의사가 읽는 예비 판독문을 쓴다. 환자가 직접 쓰는 상담형 챗봇이 의료기기가 아닌 건강관리 서비스로 나온다면, 병원이나 보험자를 설득할 근거로 내밀 것은 결국 사용자 수와 만족도다. Rosie의 결과는 그 근거가 얼마나 얇은지를 보여 준다. 산모 200명이 1년 동안 한 사람당 질문 119개(중앙값)를 던지고 중간 설문에서 높은 점수를 줬는데도 불안과 우울이 움직이지 않았다는 사실은, 챗봇을 파는 쪽보다 사는 쪽에 더 쓸모 있는 정보다.
출처
- Norell EM, Yue X, Mane H, et al. Generative Artificial Intelligence and Maternal Health Outcomes in Pregnant and Postpartum Individuals: A Randomized Clinical Trial. JAMA Netw Open. 2026;9(11):e2641062. 2026-11-04 온라인 게재. doi:10.1001/jamanetworkopen.2026.41062. https://jamanetwork.com/journals/jamanetworkopen/fullarticle/2856248
- ClinicalTrials.gov NCT06053515. https://clinicaltrials.gov/study/NCT06053515
- Nguyen QC, Norell EM, Mane H, et al. Developing an artificial intelligence-powered question-and-answer chatbot with English-Spanish capabilities for new mothers. JAMIA Open. 2026;9(1):ooaf169. doi:10.1093/jamiaopen/ooaf169 (PMID 41502532)
- Nguyen QC, Aparicio EM, Jasczynski M, et al. Rosie, a Health Education Question-and-Answer Chatbot for New Mothers: Randomized Pilot Study. JMIR Form Res. 2024;8:e51361. doi:10.2196/51361 (PMID 38214963)
- Norell EM, Marin Gutierrez FX, Smolyak D, et al. Rosie en Español, a Chatbot-Delivered Intervention for Spanish-Speaking, US-Based Latina Mothers: Pilot Randomized Controlled Trial. JMIR Form Res. 2026;10:e101898 (2026-10-22). doi:10.2196/101898 (PMID 42954061)
- Heinz MV, et al. Randomized Trial of a Generative AI Chatbot for Mental Health Treatment. NEJM AI. 2025. doi:10.1056/AIoa2400802. https://ai.nejm.org/doi/full/10.1056/AIoa2400802
- MedTech Dive, "How should the FDA regulate generative AI in medtech? Here are 5 takes," 2026-11-03. https://www.medtechdive.com/news/how-should-the-fda-regulate-generative-ai-in-medtech-here-are-5-takes/873608/
- RAPS, "Stakeholders offer competing feedback on how FDA should regulate genAI devices," 2026-11-03. https://www.raps.org/resource/stakeholders-offer-competing-feedback-on-how-fda-should-regulate-genai-devices.html
- FDA Digital Health Advisory Committee (2025-11-06, Generative AI-Enabled Digital Mental Health Medical Devices). https://www.fda.gov/medical-devices/digital-health-center-excellence/fda-digital-health-advisory-committee
- 본 블로그, "FDA가 생성형 AI 의료기기를 의사처럼 시험하는 안을 꺼냈다" (2026-08-24)
- 본 블로그, "의사 95만 명이 AI에 던진 질문 2억 7천만 건" (2026-10-19)
- 본 블로그, "구글 진단 AI가 실제 환자 98명 앞에서 받은 성적표" (2026-10-12)
- 본 블로그, "식약처가 FDA보다 먼저 허가한 이유: 세계 최초 생성형 AI 의료기기가 나온 배경" (2026-06-22)